

“รายชื่อ AI crawler” ส่วนใหญ่ที่คุณเจอคัดลอกต่อกันมา และหลายรายการล้าสมัยแล้ว ยังระบุ Claude-Web ว่าเป็นครอว์เลอร์ของ Anthropic สร้างบอทชื่อ “Googlebot-Extended” ขึ้นมาเอง หรือบอกว่า Google-Extended รวบรวมข้อมูลหน้าเว็บของคุณ ซึ่งไม่จริง Google-Extended ไม่มียูสเซอร์เอเจนต์ของตัวเอง เป็นเพียงโทเค็นใน robots.txt เท่านั้น
รายชื่อนี้ต่างออกไปสองข้อ ยูสเซอร์เอเจนต์ทุกตัวด้านล่างได้รับการตรวจสอบกับเอกสารของผู้ให้บริการเอง ณ วันที่ 20 พฤศจิกายน 2026 และเราวัดว่าเว็บไซต์จริงปฏิบัติต่อบอทเหล่านี้อย่างไร โดยดึง robots.txt จาก 3,000 เว็บไซต์ที่สุ่มเลือกจากทะเบียนของ Online Web Directory แล้วนับว่ามีการระบุชื่อและบล็อก AI crawler ตัวใดบ้าง คุณยังจะได้กฎ robots.txt, Nginx และ Apache ที่ทดสอบแล้ว รวมถึงสคริปต์ตรวจสอบว่าผู้เข้าชมที่อ้างว่าเป็น “GPTBot” มาจาก OpenAI จริงหรือไม่
รายชื่อ AI crawler คืออะไร? รายชื่อ AI crawler คือข้อมูลอ้างอิงของบอทที่บริษัท AI ใช้ดึงหน้าเว็บ พร้อมโทเค็น robots.txt ของแต่ละบอท สตริงยูสเซอร์เอเจนต์ และหน้าที่ของมัน ได้แก่ เก็บข้อมูลสำหรับการฝึก จัดทำดัชนีหน้าเว็บสำหรับการค้นหาด้วย AI หรือดึงหน้าเว็บแบบเรียลไทม์เพราะผู้ใช้ขอ คุณใช้รายชื่อนี้เพื่อเขียนกฎ robots.txt อ่านล็อกเซิร์ฟเวอร์ และตั้งนโยบายไฟร์วอลล์
ภาพรวม AI crawler
| คำถาม | คำตอบสั้น ๆ |
|---|---|
| AI crawler ที่สำคัญมีกี่ตัว? | ประมาณ 20 ยูสเซอร์เอเจนต์ที่มีเอกสารจากผู้ให้บริการ 9 ราย (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral) บวก DuckDuckGo และบอทขนาดเล็กอีกจำนวนมาก |
| ประเภทหลัก | ครอว์เลอร์สำหรับการฝึก ครอว์เลอร์สำหรับการค้นหาด้วย AI และตัวดึงข้อมูลหรือเอเจนต์ที่ผู้ใช้สั่งงาน Google-Extended และ Applebot-Extended เป็นโทเค็นควบคุม ไม่ใช่ครอว์เลอร์ |
| บอทเหล่านี้ทำตาม robots.txt หรือไม่? | ครอว์เลอร์สำหรับการฝึกและการค้นหาที่มีเอกสารระบุว่าทำตาม ส่วนตัวดึงข้อมูลที่ผู้ใช้สั่งงาน (ChatGPT-User, Perplexity-User, ตัวดึงข้อมูลที่ผู้ใช้สั่งงานของ Google, Meta-ExternalFetcher) ระบุว่า robots.txt อาจไม่มีผล |
| robots.txt ส่งคืน 403 ได้หรือไม่? | ไม่ได้ robots.txt เป็นคำขอ ไม่ใช่กุญแจล็อก รหัส 403 มาจากเซิร์ฟเวอร์ CDN หรือไฟร์วอลล์ของคุณ |
| เว็บไซต์บล็อกบอทเหล่านี้บ่อยแค่ไหน? | ในตัวอย่างของเราวันที่ 20 พ.ย. 2026 ไฟล์ robots.txt 16.9% บล็อก GPTBot ทั้งหมด แต่มีเพียง 2.8% ที่บล็อก OAI-SearchBot ทั้งหมด |
| จะตรวจสอบบอทได้อย่างไร? | เทียบ IP ของคำขอกับรายการ IP ที่ผู้ให้บริการเผยแพร่ (เช่น https://openai.com/gptbot.json) ยูสเซอร์เอเจนต์ปลอมแปลงได้ง่ายมาก |
รายชื่อ AI crawler (ตรวจสอบเมื่อพฤศจิกายน 2026)
ตารางด้านล่างแสดงโทเค็น robots.txt แต่ละตัว ผู้ให้บริการ หน้าที่ตามที่ผู้ให้บริการระบุ และผู้ให้บริการบอกว่าบอททำตาม robots.txt หรือไม่ “ประเภท” แบ่งเป็นสามกลุ่ม: การฝึก (เก็บเนื้อหาที่อาจใช้ฝึกโมเดล) การค้นหา (จัดทำดัชนีหน้าเว็บเพื่อให้ผลิตภัณฑ์ AI อ้างอิงได้ภายหลัง) และ ผู้ใช้ (ดึงหน้าเว็บแบบเรียลไทม์เพราะมีคนขอ) เราไม่รวมบอทที่ผู้ให้บริการไม่ได้เผยแพร่เอกสารที่เราตรวจสอบได้
| โทเค็น robots.txt | ผู้ให้บริการ | ประเภท | หน้าที่ | ทำตาม robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | การฝึก | รวบรวมเนื้อหาที่อาจใช้ฝึกโมเดลพื้นฐานของ OpenAI | ใช่ |
OAI-SearchBot |
OpenAI | การค้นหา | จัดทำดัชนีหน้าเว็บเพื่อให้ปรากฏในผลการค้นหาของ ChatGPT | ใช่ |
ChatGPT-User |
OpenAI | ผู้ใช้ | เข้าชมหน้าเว็บเมื่อผู้ใช้ ChatGPT หรือ Custom GPT ถามคำถาม | “อาจไม่มีผล” |
OAI-AdsBot |
OpenAI | ตรวจสอบโฆษณา | ตรวจสอบแลนดิ้งเพจที่ส่งมาเป็นโฆษณาใน ChatGPT ไม่ใช้สำหรับการฝึก | เข้าชมเฉพาะหน้าที่ส่งมา |
ClaudeBot |
Anthropic | การฝึก | เก็บเนื้อหาเว็บที่อาจช่วยในการฝึกโมเดล Claude | ใช่ และรองรับ Crawl-delay |
Claude-SearchBot |
Anthropic | การค้นหา | จัดทำดัชนีเนื้อหาเพื่อปรับปรุงผลการค้นหาของ Claude | ใช่ |
Claude-User |
Anthropic | ผู้ใช้ | ดึงหน้าเว็บเมื่อผู้ใช้ Claude ถามคำถาม | ใช่ ตามที่ Anthropic ระบุ |
Google-Extended |
โทเค็นควบคุม | กำหนดว่าเนื้อหาที่ Google รวบรวมสามารถใช้ฝึก Gemini หรือเป็นข้อมูลอ้างอิงสำหรับคำตอบของ Gemini ได้หรือไม่ ไม่มีครอว์เลอร์แยก | โทเค็นเท่านั้น | |
Google-CloudVertexBot |
ตามคำขอของเจ้าของ | รวบรวมข้อมูลเว็บไซต์ของเจ้าของที่สร้าง Vertex AI Agents ไม่มีผลต่อ Google Search | ใช่ | |
Google-Agent |
ผู้ใช้ | เอเจนต์บนโครงสร้างพื้นฐานของ Google ที่ท่องเว็บและดำเนินการตามคำขอของผู้ใช้ | ผู้ใช้สั่งงาน: โดยทั่วไปไม่ | |
PerplexityBot |
Perplexity | การค้นหา | จัดทำดัชนีหน้าเว็บสำหรับผลการค้นหาของ Perplexity ไม่ใช้สำหรับการฝึก | ใช่ |
Perplexity-User |
Perplexity | ผู้ใช้ | ดึงหน้าเว็บระหว่างเซสชัน Perplexity ของผู้ใช้ | “โดยทั่วไปไม่สนใจ” |
Applebot-Extended |
Apple | โทเค็นควบคุม | กำหนดว่าหน้าเว็บที่ Applebot รวบรวมสามารถใช้ฝึกโมเดลพื้นฐานของ Apple ได้หรือไม่ ไม่ได้รวบรวมข้อมูลเอง | โทเค็นเท่านั้น |
meta-externalagent |
Meta | การฝึก | รวบรวมข้อมูลเพื่อการใช้งาน เช่น ฝึกโมเดล AI หรือจัดทำดัชนีเนื้อหา | ใช่ |
meta-externalfetcher |
Meta | ผู้ใช้ | ดึงลิงก์แต่ละรายการตามคำขอของผู้ใช้ รวมถึงงานแบบเอเจนต์ | “อาจข้ามได้” |
Amazonbot |
Amazon | การฝึก | ปรับปรุงผลิตภัณฑ์และบริการของ Amazon อาจใช้ฝึกโมเดล AI ของ Amazon | ใช่ |
Amzn-SearchBot |
Amazon | การค้นหา | จัดทำดัชนีหน้าเว็บสำหรับประสบการณ์การค้นหา เช่น Alexa ไม่ใช้สำหรับการฝึก | ใช่ |
Amzn-User |
Amazon | ผู้ใช้ | ดึงข้อมูลสดเพื่อตอบผู้ใช้ เช่น คำถามที่ถาม Alexa | “อาจไม่ทำตามทั้งหมด” |
CCBot |
Common Crawl | ข้อมูลการฝึก | สร้างคลังเว็บแบบเปิด Common Crawl ซึ่งเป็นแหล่งข้อมูลการฝึก AI ที่ใช้กันทั่วไป | ใช่ |
MistralAI-Training |
Mistral AI | การฝึก | รวบรวมเนื้อหาเพื่อสร้างชุดข้อมูลสำหรับฝึกโมเดล Mistral | ใช่ |
MistralAI-Index |
Mistral AI | การค้นหา | จัดทำดัชนีเนื้อหาสำหรับการค้นหาของ Mistral ไม่ใช้สำหรับการฝึก | ใช่ |
MistralAI-User |
Mistral AI | ผู้ใช้ | เข้าชมหน้าเว็บเมื่อผู้ใช้ถามผู้ช่วย Vibe ของ Mistral | ใช่ สำหรับคำขอของผู้ใช้ |
DuckAssistBot |
DuckDuckGo | การค้นหา | รวบรวมหน้าเว็บแบบเรียลไทม์สำหรับคำตอบที่ใช้ AI ช่วยของ DuckDuckGo | ใช่ (มีผลหลัง 72 ชั่วโมง) |
แหล่งที่มาของทุกแถวมีลิงก์อยู่ท้ายบทความนี้ ข้อความที่ยกมาในคอลัมน์สุดท้ายมาจากเอกสารของผู้ให้บริการโดยตรง เราตั้งใจไม่ใส่ Bytespider (ByteDance) เพราะไม่พบหน้าของ ByteDance ที่อธิบายบอทนี้ แม้ว่าไฟล์ robots.txt ในตัวอย่างของเรา 18.5% จะระบุชื่อมันก็ตาม ด้วยเหตุผลเดียวกัน เราจึงไม่อธิบายโทเค็นที่พบน้อยอย่าง cohere-ai, Diffbot หรือ omgili คุณจะเห็นว่าเว็บไซต์ระบุชื่อพวกมันบ่อยแค่ไหนในส่วนข้อมูล
สตริงยูสเซอร์เอเจนต์แบบเต็มที่คุณจะเห็นในล็อก
robots.txt จับคู่ด้วยโทเค็นสั้น ๆ แต่ล็อกการเข้าถึงจะแสดงสตริงแบบเต็ม นี่คือตัวอย่างที่ผู้ให้บริการเผยแพร่ หมายเลขเวอร์ชันเปลี่ยนได้ จึงควรจับคู่ด้วยโทเค็น ไม่ใช่ทั้งสตริง
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
OpenAI ยังระบุว่า GPTBot และ OAI-SearchBot อาจเพิ่มเครื่องหมาย robots.txt ในยูสเซอร์เอเจนต์เมื่อดึงไฟล์ robots.txt ของคุณ เพื่อให้แยกคำขอเหล่านั้นได้ในล็อกที่ไม่บันทึกพาธ
AI crawler สามประเภท และเหตุใดความแตกต่างจึงสำคัญ
การบล็อก “บอท AI” รวมเป็นกลุ่มเดียวคือข้อผิดพลาดที่เราพบบ่อยที่สุด ทั้งสามประเภทมีต้นทุนและประโยชน์ต่างกัน และผู้ให้บริการปฏิบัติต่อ robots.txt แตกต่างกันในแต่ละประเภท
ครอว์เลอร์สำหรับการฝึก
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot และ MistralAI-Training เก็บหน้าเว็บที่อาจกลายเป็นข้อมูลฝึกโมเดล การบล็อกพวกมันไม่ได้ทำให้คุณหายไปจากผลการค้นหาด้วย AI ของบริษัทเดียวกัน OpenAI ระบุว่าการตั้งค่า robots.txt แต่ละรายการเป็นอิสระต่อกัน คุณจึงห้าม GPTBot แต่ยังอนุญาต OAI-SearchBot ได้ ในตัวอย่างของเรา ครอว์เลอร์สำหรับการฝึกเป็นกลุ่มที่ถูกบล็อกมากที่สุด: ไฟล์ robots.txt 17.3% ห้าม CCBot ทั้งหมด 16.9% ห้าม GPTBot และ 15.9% ห้าม ClaudeBot
ครอว์เลอร์สำหรับการค้นหาด้วย AI
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index และ DuckAssistBot จัดทำดัชนีหน้าเว็บเพื่อให้ผู้ช่วยค้นหาและอ้างอิงได้ภายหลัง การบล็อกพวกมันอาจทำให้คุณไม่ปรากฏในคำตอบเหล่านั้น เจ้าของเว็บไซต์ดูเหมือนจะรู้เรื่องนี้: มีเพียง 2.8% ของไฟล์ที่บล็อก OAI-SearchBot ทั้งหมด และ 5.8% ที่บล็อก PerplexityBot เทียบกับ 16.9% สำหรับ GPTBot
ตัวดึงข้อมูลและเอเจนต์ที่ผู้ใช้สั่งงาน
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User และ Google-Agent ทำงานเพื่อคนคนเดียวในแต่ละครั้ง เหมือนเบราว์เซอร์ ผู้ให้บริการหลายรายบอกว่า robots.txt อาจไม่มีผลเพราะมนุษย์เป็นผู้ขอหน้าเว็บ บอทเหล่านี้ยังเป็นบอทที่เอเจนต์ช้อปปิ้งและจองใช้ การบล็อกจึงอาจทำให้ลูกค้าจริงหันหลังกลับ ไฟล์ 5.9% ในตัวอย่างของเราบล็อก ChatGPT-User ทั้งหมด
โทเค็นควบคุมที่ไม่รวบรวมข้อมูล
Google-Extended และ Applebot-Extended ไม่เคยเข้าชมเว็บไซต์ของคุณ Google และ Apple รวบรวมข้อมูลด้วย Googlebot และ Applebot ตามปกติ แล้วตรวจสอบโทเค็นเหล่านี้เพื่อตัดสินว่าเนื้อหาใช้ฝึกโมเดลได้หรือไม่ ตามที่ Google ระบุ การห้าม Google-Extended ไม่มีผลต่อการแสดงหรืออันดับใน Google Search ไฟล์ในตัวอย่าง 14.1% บล็อก Google-Extended ทั้งหมด และ 13.5% บล็อก Applebot-Extended Google ยังบอกว่ามีแผนรองรับสัญญาณการฝึก AI ร่วม (user-agent: __usage_ai-training) ในต้นปี 2027 เราอธิบายไว้ในคู่มือการไม่ยินยอมให้ฝึก AI ด้วย robots.txt
โทเค็นเก่าที่ยังคงเต็มไฟล์ robots.txt
หน้าช่วยเหลือปัจจุบันของ Anthropic ระบุเพียง ClaudeBot, Claude-User และ Claude-SearchBot แต่ไฟล์ในตัวอย่าง 15.6% ยังระบุ anthropic-ai และ 13.8% ระบุ Claude-Web กฎสำหรับชื่อเหล่านี้ไม่เป็นอันตราย แต่ถ้าเป็นกฎเดียวที่คุณมีสำหรับ Anthropic ก็อาจไม่ครอบคลุมบอทที่ Anthropic ระบุในเอกสารปัจจุบัน ตรวจสอบให้แน่ใจว่ามีการระบุ ClaudeBot อย่างชัดเจน
การเข้าถึงของ AI crawler ในทางปฏิบัติ
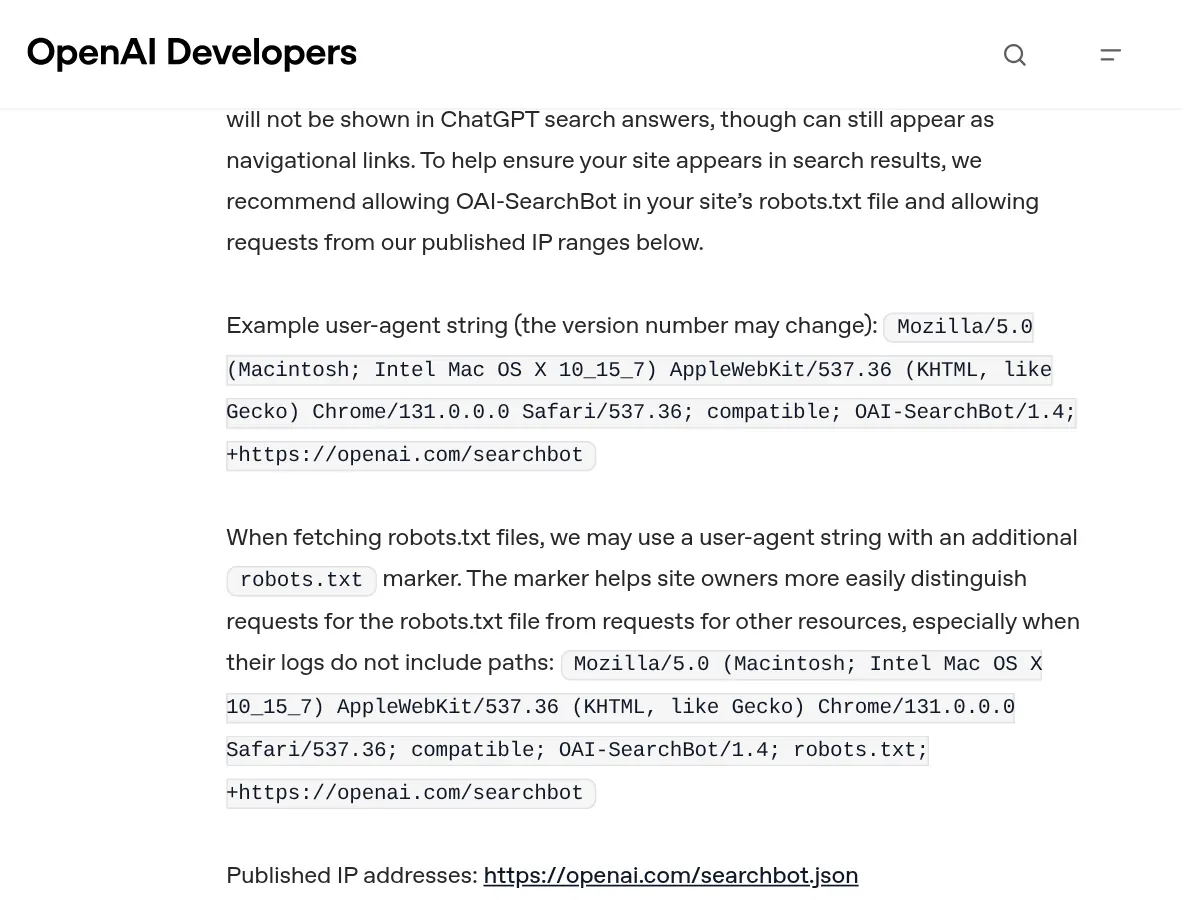
เอกสารของผู้ให้บริการคือแหล่งข้อมูลที่ถูกต้องที่สุดสำหรับยูสเซอร์เอเจนต์ เช่น หน้าของ OpenAI แสดงบอทแต่ละตัวพร้อมตัวอย่างสตริงยูสเซอร์เอเจนต์ หมายเหตุเกี่ยวกับเครื่องหมาย robots.txt และลิงก์ไปยังไฟล์ IP ที่เผยแพร่
สิ่งที่เว็บไซต์ทำกับบอทเหล่านี้จริง ๆ เป็นอีกเรื่องหนึ่ง เราขอหน้าแรกหกเว็บไซต์จากเซิร์ฟเวอร์ของเราด้วยยูสเซอร์เอเจนต์ของ Chrome, GPTBot ของ OpenAI และ ClaudeBot เซิร์ฟเวอร์ของเราอยู่บน IP ของดาต้าเซ็นเตอร์ ซึ่งระบบป้องกันบอทจำนวนมากมองว่าน่าสงสัย ผลจากอินเทอร์เน็ตบ้านจึงอาจต่างออกไป
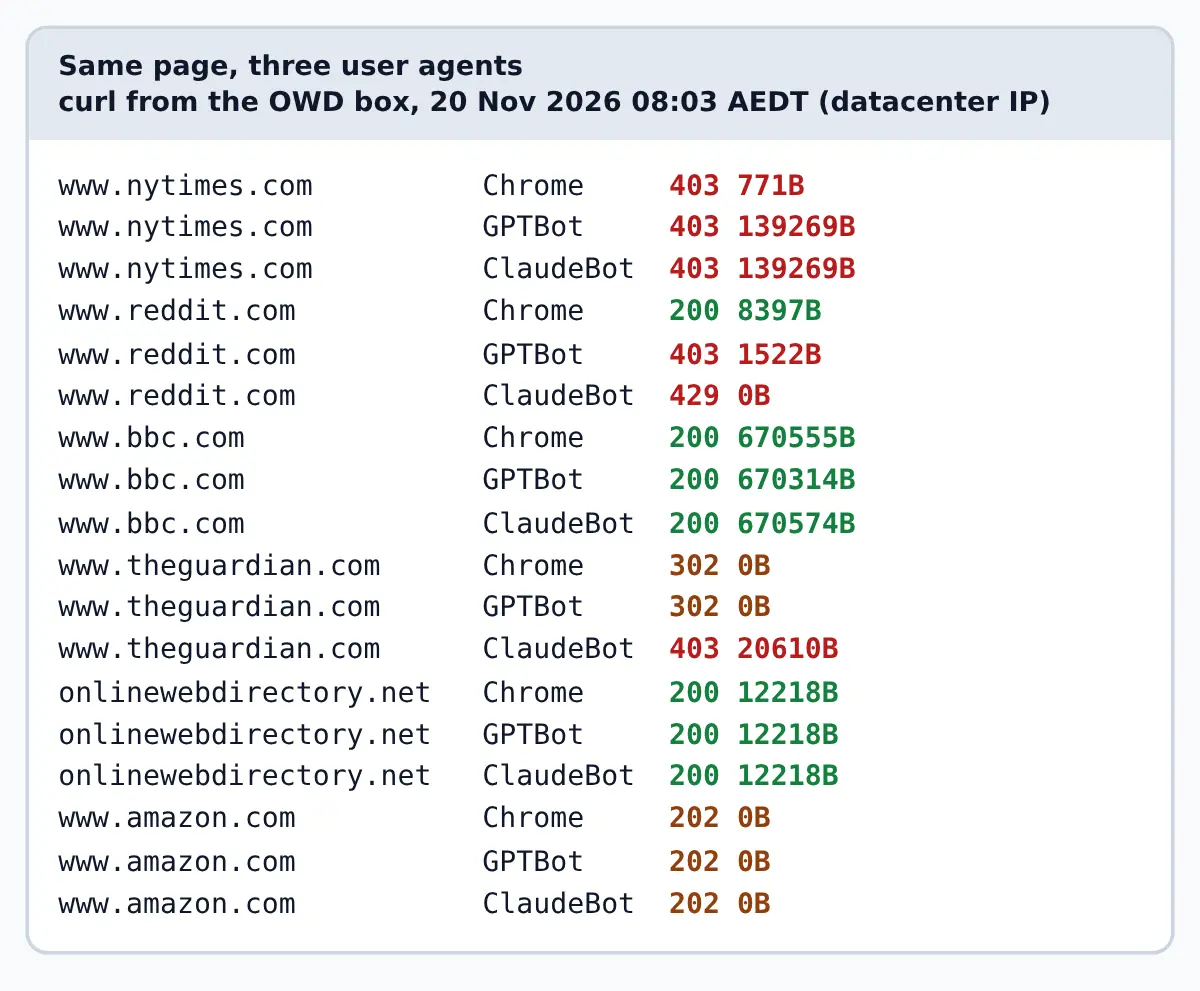
พบสามรูปแบบ Reddit ให้บริการ Chrome แต่ส่ง 403 ให้ GPTBot และ 429 ให้ ClaudeBot ซึ่งเป็นการกรองตามยูสเซอร์เอเจนต์ที่เซิร์ฟเวอร์หรือ CDN The New York Times ส่ง 403 ให้ทั้งสาม แสดงว่าการบล็อกอิงจาก IP ของเราหรือลายนิ้วมือของคำขอ ไม่ใช่ยูสเซอร์เอเจนต์ และ bbc.com ส่ง 200 ให้ GPTBot แม้ว่า robots.txt จะห้าม GPTBot, ClaudeBot, CCBot, PerplexityBot และโทเค็น AI อื่นอีกอย่างน้อยห้าตัว นี่คือหลักฐานที่ชัดที่สุดว่า robots.txt เป็นเพียงคำขอและไม่ได้บังคับ Amazon ตอบทั้งสามด้วย 202 และเนื้อหาว่าง ซึ่งเป็นหน้าท้าทายคั่นกลาง ไม่ใช่หน้าเว็บจริง
บันทึกของ Online Web Directory สำหรับแต่ละเว็บไซต์แยกสองชั้นนี้ออกจากกัน: เอเจนต์เข้าถึงเว็บไซต์ได้หรือไม่ และ robots.txt เขียนว่าอะไร
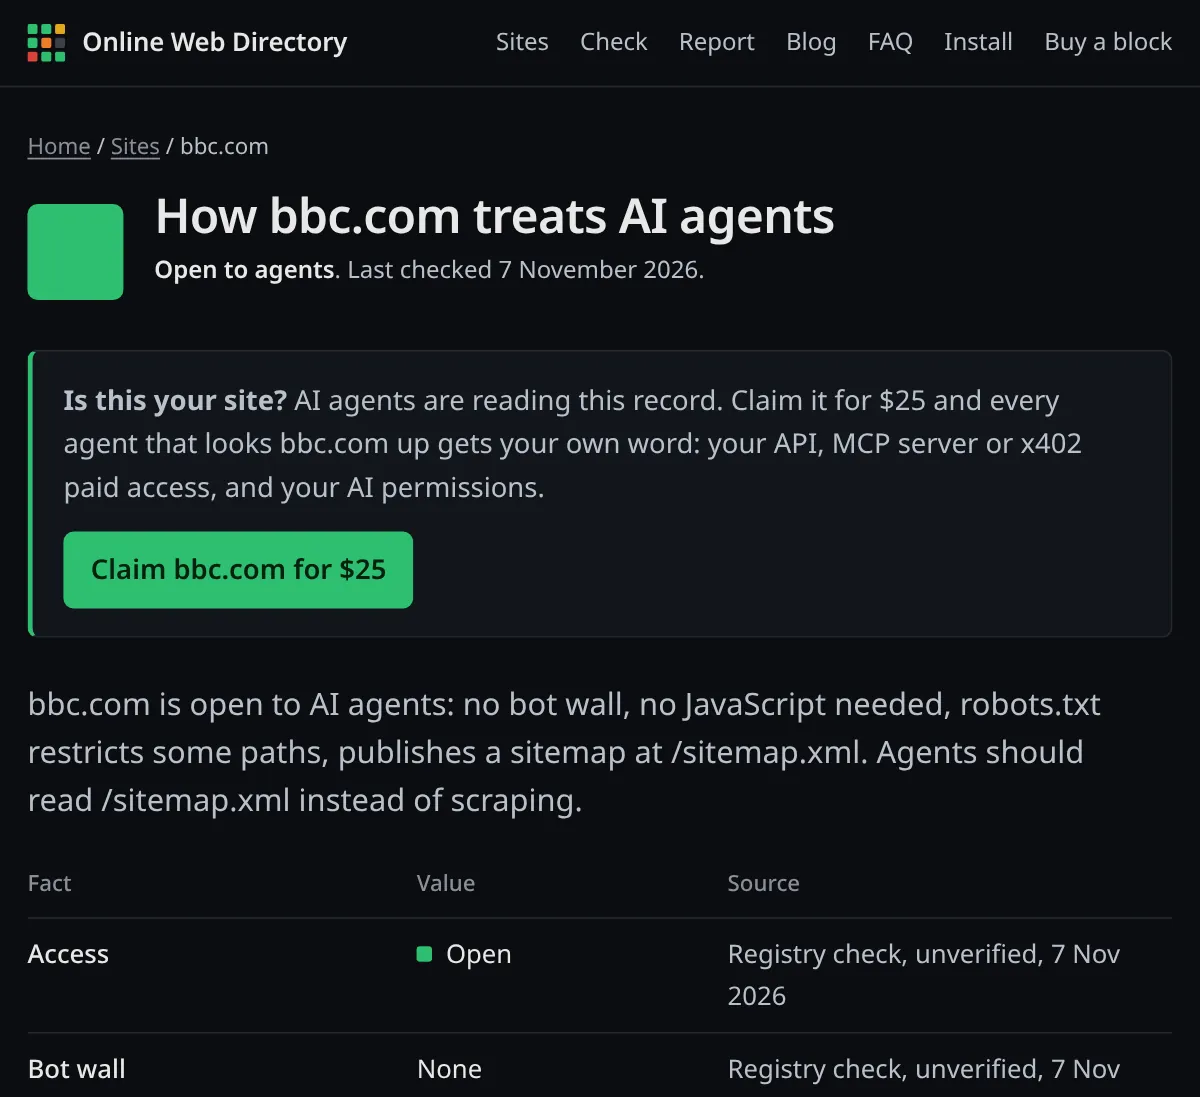
วิธีตรวจสอบว่า AI crawler ตัวใดเข้าถึงเว็บไซต์ของคุณได้
1. อ่านกลุ่มใน robots.txt ที่เกี่ยวกับโทเค็น AI
เริ่มจากสิ่งที่คุณขอให้ครอว์เลอร์ทำ คำสั่งนี้พิมพ์ทุกกลุ่มที่ระบุโทเค็น AI ที่พบบ่อย พร้อมบรรทัดถัดไป:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'ผลลัพธ์จริงของ bbc.com เมื่อ 20 พฤศจิกายน 2026 เวลา 08:09 AEDT (ตัดเหลือสี่จากเก้ากลุ่ม):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
จำไว้ว่าครอว์เลอร์จะทำตามเฉพาะกลุ่มที่เจาะจงที่สุดซึ่งตรงกับโทเค็นของมัน หากคุณระบุ GPTBot ในกลุ่มของมันเอง มันจะไม่สนใจกฎ User-agent: * เลย ดังนั้นให้ใส่กฎที่ใช้ร่วมกันซ้ำในกลุ่ม GPTBot ด้วย
2. ทดสอบว่าเซิร์ฟเวอร์ตอบสนองยูสเซอร์เอเจนต์ AI อย่างไร
robots.txt อาจบอกว่า “ไม่” ขณะที่เซิร์ฟเวอร์ยังบอกว่า “ได้” หรือกลับกัน ขอหน้าเดียวกันด้วยยูสเซอร์เอเจนต์ต่างกันแล้วเทียบรหัสสถานะ:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
เปลี่ยน URL เป็นของคุณ ถ้ามี 403 หรือ 429 เฉพาะ GPTBot แปลว่ากรองตามยูสเซอร์เอเจนต์ ถ้า 403 ทั้งคู่ มักเป็นเพราะชื่อเสียงของ IP หรือการท้าทายบอท ให้รันทั้งจากอินเทอร์เน็ตบ้านและจากเซิร์ฟเวอร์ ครอว์เลอร์จริงมาจาก IP ดาต้าเซ็นเตอร์ ผลจากเซิร์ฟเวอร์จึงใกล้เคียงกับสิ่งที่มันเห็นมากกว่า
3. ค้นหา AI crawler ในล็อกการเข้าถึง
นับจำนวนครั้งต่อบอท แล้วตรวจสอบรหัสสถานะที่แต่ละบอทได้รับ เรารันคำสั่งเหล่านี้กับล็อกการเข้าถึงของเซิร์ฟเวอร์ Nginx ทดสอบเมื่อ 20 พฤศจิกายน 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
คำสั่งที่สองใช้กับรูปแบบล็อก “combined” มาตรฐาน ซึ่งรหัสสถานะอยู่ถัดจากบรรทัดคำขอในเครื่องหมายคำพูด GPTBot ได้ 200 ที่ /robots.txt และ 403 ที่อื่นทั้งหมด คือผลลัพธ์ที่คุณต้องการเมื่อบล็อกครอว์เลอร์สำหรับการฝึกที่เซิร์ฟเวอร์
4. ตรวจสอบว่าผู้เข้าชม “GPTBot” มาจาก OpenAI จริง
ใครก็ส่งยูสเซอร์เอเจนต์ GPTBot ได้ OpenAI, Perplexity, DuckDuckGo, Mistral และ Google เผยแพร่รายการ IP ดังนั้นให้ตรวจสอบ IP ต้นทาง สคริปต์นี้ทดสอบ IP กับไฟล์สามไฟล์ของ OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
ผลลัพธ์เมื่อ 20 พฤศจิกายน 2026 เวลา 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
ขณะที่เราทดสอบ ไฟล์ gptbot.json ของ OpenAI มีช่วง IPv4 18 ช่วง โดยมีเวลาสร้างเป็น 22 กันยายน 2026 ให้ดึงไฟล์ใหม่ทุกครั้งแทนการฝังค่าไว้ในโค้ด
5. ค้นหาเว็บไซต์ของคุณในทะเบียน
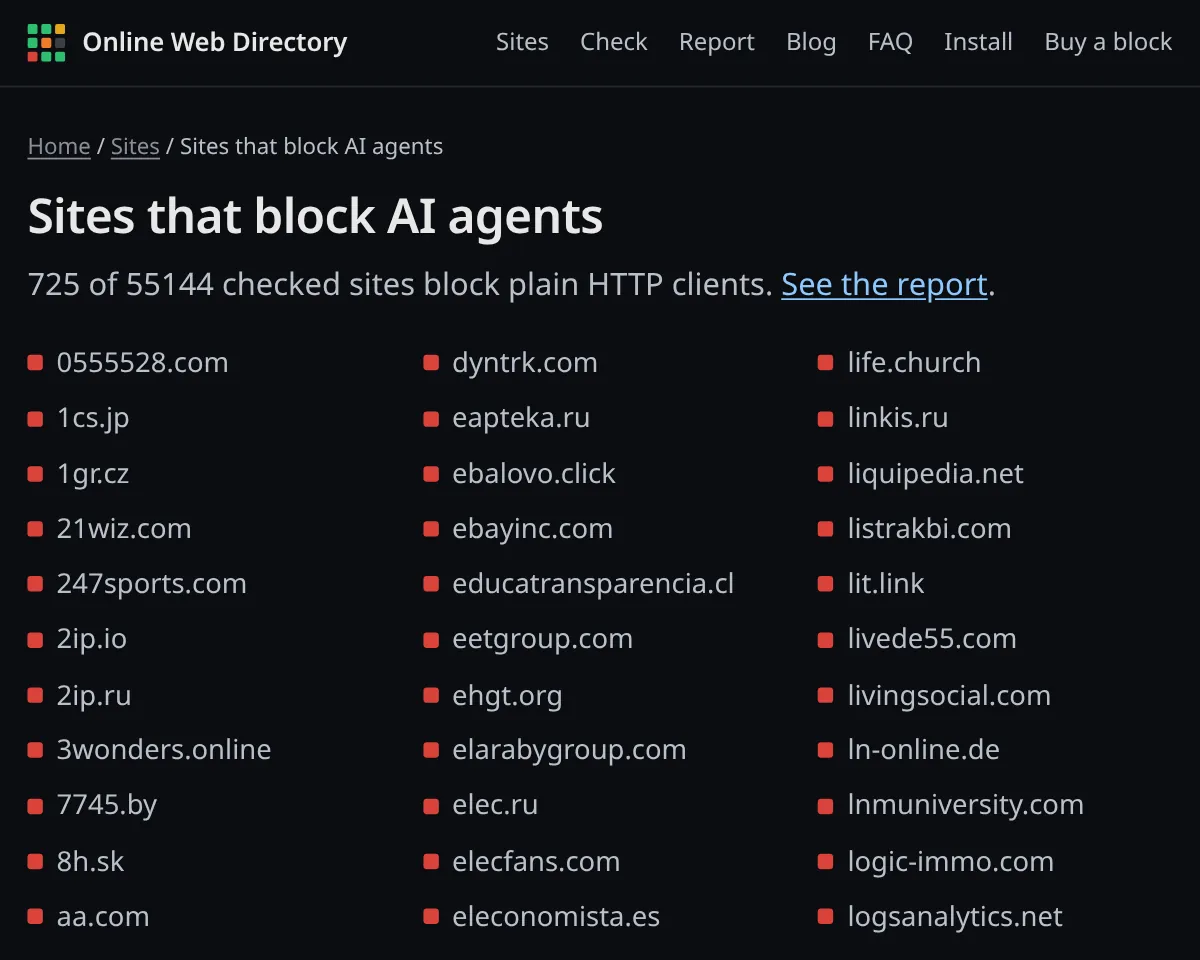
Online Web Directory ตรวจสอบว่าเว็บไซต์ตอบสนองไคลเอนต์ HTTP ธรรมดาอย่างไร และ robots.txt เขียนว่าอะไร ค้นหาโดเมนของคุณ เช่น reddit.com หรือ nytimes.com หรือรันการตรวจความพร้อมฟรี รายชื่อเว็บไซต์ที่บล็อกเอเจนต์ AI แสดงโดเมนที่ปฏิเสธไคลเอนต์ธรรมดา
วิธีควบคุม AI crawler: หกวิธี
เลือกตามเป้าหมายของคุณ เว็บไซต์ส่วนใหญ่ต้องการรักษาทราฟฟิกจากการค้นหาด้วย AI ตัดสินเรื่องการฝึกเป็นกรณีไป และปล่อยเอเจนต์ที่ผู้ใช้สั่งงานไว้ตามเดิม
วิธีที่ 1: บล็อกครอว์เลอร์สำหรับการฝึก แต่คงการค้นหาด้วย AI ไว้ (robots.txt)
นี่คือนโยบายที่พบบ่อยที่สุดในเว็บไซต์ที่เราสุ่มตัวอย่าง เพิ่มสิ่งนี้ใน /robots.txt ที่รูทของทุกโฮสต์ที่คุณให้บริการ:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
เราทดสอบไฟล์นี้ด้วย Protego ซึ่งเป็นตัวแยกวิเคราะห์ตาม RFC 9309 ผลสำหรับพาธ /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
การวางบรรทัด User-agent หลายบรรทัดซ้อนบนชุดกฎเดียวถูกต้องตาม RFC 9309 โปรดทราบว่ากลุ่มการค้นหาด้วย AI ไม่ได้รับกฎ /wp-admin/ จากกลุ่ม * หากต้องการให้เพิ่มไว้ที่นั่นด้วย
วิธีที่ 2: บล็อก AI crawler ทุกตัวที่มีเอกสาร (robots.txt)
หากคุณไม่ต้องการให้ AI ใช้งานเลย ให้เพิ่มโทเค็นการค้นหาและผู้ใช้ในกลุ่มที่ห้าม: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User และ DuckAssistBot เตรียมใจว่าจะหายไปจากคำตอบของ AI และจำไว้ว่าตัวดึงข้อมูลที่ผู้ใช้สั่งงานหลายตัวบอกว่า robots.txt อาจไม่มีผลกับพวกมัน นี่จึงเป็นการแสดงความต้องการ ไม่ใช่กำแพง
วิธีที่ 3: บังคับการบล็อกใน Nginx
หากต้องการปฏิเสธคำขอจริง ให้กรองที่เซิร์ฟเวอร์ การตั้งค่านี้ส่ง 403 ให้ครอว์เลอร์สำหรับการฝึกในทุกพาธ ยกเว้น robots.txt เพื่อให้พวกมันยังอ่านกฎของคุณได้ บล็อก map อยู่ในคอนเท็กซ์ http:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
เราทดสอบกับ Nginx 1.26.3 เมื่อ 20 พฤศจิกายน 2026: nginx -t ผ่าน GPTBot ได้ 403 ที่ / และ 200 ที่ /robots.txt ขณะที่ Chrome และ OAI-SearchBot ได้ 200 ทั้งสองที่ การใช้ return เพียงคำสั่งเดียวภายใน if เป็นหนึ่งในการใช้งานที่ Nginx ระบุว่าปลอดภัย
วิธีที่ 4: บังคับการบล็อกใน Apache (.htaccess)
กฎเดียวกันสำหรับ Apache ด้วย mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
ทดสอบบน Apache 2.4.71 ที่ตั้ง AllowOverride All: GPTBot ได้ 403 ที่หน้าแรกและ 200 ที่ robots.txt ส่วน Chrome และ OAI-SearchBot ได้ 200 แฟล็ก [F] ส่ง 403 Forbidden
วิธีที่ 5: ใช้นโยบาย AI crawler ของ CDN
หากคุณใช้ Cloudflare ก็ไม่ต้องดูแลรายชื่อเอง ในการตั้งค่า Security ให้กรองด้วย “Bot traffic” แล้วเปิด AI Crawler and Agent access policies Cloudflare ให้คุณตั้งการทำงานแยกกันสำหรับทราฟฟิก Search, Agent และ Training เอกสารระบุว่าโดเมนใหม่มีค่าเริ่มต้นเป็น “Allow (do not block)” ทั้งสามแบบ และ “Disallow” สำหรับ Training จะแก้ไขเพียง robots.txt เว้นแต่จะเปิด Bot Preference Sync แดชบอร์ด AI Crawl Control ของ Cloudflare ยังแสดงว่าครอว์เลอร์ใดเข้าชมและทำตาม robots.txt หรือไม่ จาก 62,088 เว็บไซต์ในทะเบียนของเรา 6,966 แห่ง (11.2%) แสดงหน้าท้าทายของ Cloudflare ต่อเครื่องมือตรวจสอบของเรา
วิธีที่ 6: ตรวจสอบก่อน แล้วจึงอนุญาต
กฎยูสเซอร์เอเจนต์บล็อกบอทที่ซื่อสัตย์และปล่อยบอทที่ไม่ซื่อสัตย์ผ่านไป หากคุณบล็อกที่ edge ให้ใช้กฎคู่กับการตรวจ IP (ดูขั้นตอนที่ 4 ด้านบน) และอนุญาตเอเจนต์การค้นหาและผู้ใช้ที่ตรวจสอบแล้ว Anthropic เตือนว่าการบล็อก IP ของบริษัทอาจใช้เป็นการไม่ยินยอมได้ไม่น่าเชื่อถือ เพราะจะทำให้ ClaudeBot อ่าน robots.txt ของคุณไม่ได้ ใช้ robots.txt สำหรับนโยบาย และใช้การตรวจ IP เพื่อจับตัวปลอม
ไฟล์ robots.txt 2,124 ไฟล์บอกอะไรเกี่ยวกับ AI crawler
เมื่อ 20 พฤศจิกายน 2026 ระหว่าง 08:01 ถึง 08:03 AEDT เราสุ่มเลือก 3,000 โฮสต์จาก 62,088 เว็บไซต์ในชุดข้อมูลเปิดของ Online Web Directory และดึง /robots.txt จากเซิร์ฟเวอร์ของเรา มี 2,124 แห่งที่ส่งคืนไฟล์ที่แยกวิเคราะห์ได้ โทเค็นจะนับว่า “ระบุชื่อ” ถ้ามีบรรทัด User-agent ของตัวเอง และ “บล็อกทั้งหมด” ถ้ากลุ่มนั้นมี Disallow: / โดยไม่มี Allow: /
| โทเค็น robots.txt | ระบุชื่อ | บล็อกทั้งหมด |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (เก่า) |
15.6% | 13.3% |
Claude-Web (เก่า) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
สี่ข้อค้นพบที่โดดเด่น:
- เว็บไซต์ส่วนใหญ่ไม่พูดถึง AI crawler เลย 629 จาก 2,124 ไฟล์ (29.6%) ระบุโทเค็นเฉพาะ AI อย่างน้อยหนึ่งตัว ไฟล์ที่ระบุมักระบุหลายตัว: ค่ามัธยฐานคือ 12 โทเค็น และ 357 ไฟล์ระบุ 10 ตัวขึ้นไป ซึ่งเป็นสัญญาณของรายการบล็อกที่คัดลอกมา
- การฝึกถูกบล็อก การค้นหาไม่ถูกบล็อก GPTBot ถูกบล็อกทั้งหมดบ่อยกว่า OAI-SearchBot หกเท่า (16.9% เทียบกับ 2.8%)
- robots.txt กับการเข้าถึงจริงไม่ตรงกัน จาก 358 เว็บไซต์ที่บล็อก GPTBot ทั้งหมดใน robots.txt มี 284 แห่ง (79%) ที่ “เปิด” ในการตรวจการเข้าถึงของ OWD เอง หมายความว่าไม่มีอะไรที่เซิร์ฟเวอร์หยุดไคลเอนต์ธรรมดาเลย
- การห้ามทั้งหมดพบได้น้อย มีเพียง 13 ไฟล์ (0.6%) ที่ห้ามทุกอย่างสำหรับทุกยูสเซอร์เอเจนต์
ทะเบียนในภาพรวมเล่าเรื่องเดียวกันจากอีกด้าน นี่คือผลการเข้าถึงของทั้ง 62,088 เว็บไซต์ ตรวจล่าสุดระหว่าง 11 ตุลาคมถึง 19 พฤศจิกายน 2026:
| สิ่งที่ไคลเอนต์ HTTP ธรรมดาพบ | จำนวนเว็บไซต์ | สัดส่วน |
|---|---|---|
| เปิด | 50,844 | 81.9% |
| การท้าทายบอท | 7,821 | 12.6% |
| ถูกบล็อก | 3,060 | 4.9% |
| จำกัดอัตรา | 199 | 0.3% |
| ต้องเข้าสู่ระบบ | 150 | 0.2% |
| ต้องจ่ายเงิน | 14 | 0.0% |
ดาวน์โหลดชุดข้อมูลเต็ม (CC BY 4.0) จาก onlinewebdirectory.net/exports/sites.csv หรือดูรายงานการเข้าถึงของเอเจนต์ AI
ข้อผิดพลาดและการตอบสนองที่เกี่ยวข้อง
- 403 Forbidden เซิร์ฟเวอร์ CDN หรือไฟร์วอลล์ของคุณปฏิเสธคำขอ ไม่เคยเกิดจาก robots.txt เอง และไม่ถาวร: เปลี่ยนกฎแล้วคำขอถัดไปอาจสำเร็จ
- 429 Too Many Requests การจำกัดอัตรา Reddit ส่งรหัสนี้ให้คำขอ ClaudeBot ของเรา Anthropic รองรับ
Crawl-delayซึ่งเป็นทางเลือกที่นุ่มนวลกว่าสำหรับ ClaudeBot - 202 พร้อมเนื้อหาว่าง หรือหน้าท้าทาย 503 มักเป็นการท้าทายด้วย JavaScript หรือ CAPTCHA ครอว์เลอร์แก้ไม่ได้ สำหรับพวกมันหน้านั้นจึงถูกบล็อกแม้ไม่มีการส่ง 403
- robots.txt ส่งคืน 4xx ตาม RFC 9309 การตอบสนอง 400-499 หมายความว่าไฟล์ “ไม่พร้อมใช้งาน” และครอว์เลอร์เข้าถึงได้ทุกอย่าง ในตัวอย่างของเรา 314 จาก 3,000 เว็บไซต์ (10.5%) ตอบคำขอ robots.txt ด้วย 403 ซึ่งครอว์เลอร์ที่ทำตามกฎจะตีความว่าไม่มีกฎเลย
- robots.txt ส่งคืน 5xx หรือหมดเวลา RFC 9309 ระบุว่าครอว์เลอร์ต้องถือว่าห้ามทั้งหมด การล่มของ robots.txt จึงอาจบล็อกครอว์เลอร์ทุกตัวอย่างเงียบ ๆ รวมถึง Googlebot
- robots.txt ใหญ่กว่า 500 KiB RFC 9309 กำหนดให้ครอว์เลอร์แยกวิเคราะห์เพียง 500 KiB แรก กฎหลังจากนั้นจึงอาจถูกละเลย
หากคุณเผยแพร่ไฟล์ llms.txt สำหรับเอเจนต์ AI ให้ตรวจสอบว่าบอทที่คุณอนุญาตดึงไฟล์ได้จริง คู่มือ llms.txt ของเราแสดงวิธีทดสอบ
สรุป
รายชื่อ AI crawler ที่แม่นยำเริ่มจากเอกสารของผู้ให้บริการเอง ไม่ใช่รายชื่ออื่น ปัจจุบันหมายถึงยูสเซอร์เอเจนต์ประมาณ 20 ตัวจาก 9 บริษัท ในสามประเภท ได้แก่ ครอว์เลอร์สำหรับการฝึก ครอว์เลอร์สำหรับการค้นหาด้วย AI และเอเจนต์ที่ผู้ใช้สั่งงาน บวกโทเค็นควบคุมสองตัว (Google-Extended และ Applebot-Extended) ที่ไม่เคยรวบรวมข้อมูล เว็บไซต์ส่วนใหญ่ที่ดำเนินการจะบล็อกการฝึกและคงการค้นหาไว้ และ robots.txt เป็นเพียงคำขอ หากต้องการบล็อกจริง ให้บังคับที่เซิร์ฟเวอร์หรือ CDN และตรวจสอบ IP
เอเจนต์ AI ค้นหาเว็บไซต์ใน Online Web Directory ก่อนเข้าชมอยู่แล้ว หากบันทึกเว็บไซต์ของคุณไม่ถูกต้อง หรือคุณต้องการให้เอเจนต์รู้จัก API เซิร์ฟเวอร์ MCP หรือสิทธิ์ AI ของคุณ อ้างสิทธิ์เว็บไซต์ของคุณในราคา $25 คุณสามารถรันการตรวจความพร้อมฟรีก่อนได้
คำถามที่พบบ่อย
ยูสเซอร์เอเจนต์ของ ChatGPT คืออะไร?
ChatGPT ใช้สามตัว GPTBot เก็บข้อมูลการฝึก OAI-SearchBot จัดทำดัชนีหน้าเว็บสำหรับการค้นหาของ ChatGPT และ ChatGPT-User ดึงหน้าเว็บเมื่อผู้ใช้ขอ โทเค็น robots.txt ของพวกมันคือ GPTBot, OAI-SearchBot และ ChatGPT-User
การบล็อก GPTBot ทำให้เว็บไซต์ของฉันหายจากการค้นหาของ ChatGPT หรือไม่?
ไม่ OpenAI ควบคุมการค้นหาผ่าน OAI-SearchBot คุณสามารถห้าม GPTBot เพื่อไม่ยินยอมให้ฝึก และยังอนุญาต OAI-SearchBot เพื่อให้หน้าเว็บปรากฏและถูกอ้างอิงในการค้นหาของ ChatGPT ได้
Google-Extended เป็นครอว์เลอร์หรือไม่?
ไม่ใช่ Google ระบุว่า Google-Extended ไม่มียูสเซอร์เอเจนต์แยก Googlebot เป็นผู้รวบรวมข้อมูล และโทเค็น Google-Extended ควบคุมเพียงว่าเนื้อหานั้นใช้ฝึกและเป็นข้อมูลอ้างอิงของ Gemini ได้หรือไม่ ไม่มีผลต่ออันดับใน Google Search
AI crawler ทำตาม robots.txt หรือไม่?
ครอว์เลอร์สำหรับการฝึกและการค้นหาที่มีเอกสารในรายชื่อนี้ระบุว่าทำตาม ตัวดึงข้อมูลที่ผู้ใช้สั่งงาน เช่น ChatGPT-User, Perplexity-User และ Meta-ExternalFetcher ระบุว่า robots.txt อาจไม่มีผลเพราะมีคนขอหน้านั้น ส่วนสเครเปอร์ที่ไม่มีเอกสารอาจไม่สนใจเลย
จะรู้ได้อย่างไรว่าบอทเป็น GPTBot หรือ ClaudeBot จริง?
ตรวจสอบ IP ต้นทาง OpenAI เผยแพร่ช่วง IP ใน gptbot.json, searchbot.json และ chatgpt-user.json ส่วน Perplexity, DuckDuckGo, Mistral และ Google ก็เผยแพร่ของตัวเอง ยูสเซอร์เอเจนต์ที่ตรงกันแต่มาจาก IP ที่ไม่อยู่ในรายการคือตัวปลอม
แหล่งที่มา
- OpenAI, Overview of OpenAI crawlers (เข้าถึงเมื่อ 20 พ.ย. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers และ user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies และ AI Crawl Control
- Online Web Directory, ชุดข้อมูลเว็บไซต์แบบเปิด (62,088 เว็บไซต์ ส่งออกเมื่อ 20 พ.ย. 2026) และตัวอย่าง robots.txt จาก 3,000 โฮสต์ของเรา