
คุณอาจเคยอ่านว่าไฟล์ llms.txt จะบล็อกโปรแกรมรวบรวมข้อมูล AI หรือทำให้ ChatGPT อ้างอิงเว็บไซต์ของคุณ ทั้งสองข้อไม่จริง llms.txt คือแผนที่เว็บไซต์แบบ Markdown ที่เขียนให้เอเจนต์ AI อ่าน มันไม่บล็อกอะไรเลย และไม่มีโปรแกรมรวบรวมข้อมูลใดถูกบังคับให้อ่าน ถึงอย่างนั้น การเผยแพร่ก็มีต้นทุนต่ำ เอเจนต์เขียนโค้ดใช้มันมาก และตอนนี้ Lighthouse ของ Chrome ก็ตรวจสอบไฟล์นี้แล้ว
ในคู่มือนี้ เราอธิบายว่าไฟล์นี้คืออะไร ข้อเสนอ v2 ปัจจุบันว่าไว้อย่างไร ไฟล์จริงหน้าตาเป็นอย่างไร วิธีตรวจไฟล์ของคุณด้วย curl และห้าวิธีในการสร้างไฟล์ ทั้งหมดอ้างอิงข้อมูลจาก 61,612 เว็บไซต์ในทะเบียนของ Online Web Directory
llms.txt คืออะไร? llms.txt คือไฟล์ Markdown ซึ่งมักอยู่ที่ /llms.txt ที่ให้ภาพรวมสั้น ๆ ที่คัดสรรแล้วของเว็บไซต์แก่เอเจนต์ AI และโมเดลภาษาขนาดใหญ่ ได้แก่ ชื่อเป็น H1 สรุปหนึ่งย่อหน้า และรายการลิงก์ไปยังหน้าที่สำคัญ โดยควรเป็น Markdown ที่สะอาด มันเป็นข้อเสนอ ไม่ใช่มาตรฐาน และไม่ได้อนุญาตหรือบล็อกสิ่งใด
llms.txt โดยสรุป
| คำถาม | คำตอบ |
|---|---|
| ตำแหน่งไฟล์ | /llms.txt ที่รากของเว็บไซต์ หรือที่เส้นทางย่อยเช่น /docs/llms.txt ซึ่งครอบคลุมเฉพาะเส้นทางนั้น (ข้อเสนอ v2) |
| รูปแบบ | Markdown: H1 (จำเป็น) สรุปแบบ blockquote หมายเหตุเพิ่มเติม (ไม่บังคับ) และหัวข้อ H2 ที่มีลิงก์แบบ [name](url): notes |
| ผู้เสนอ | Jeremy Howard (Answer.AI) 3 กันยายน 2024; v2 แก้ไขเมื่อ 10 สิงหาคม 2026 |
| ใครอ่านไฟล์นี้ | ส่วนใหญ่คือเอเจนต์เขียนโค้ดและผู้ช่วย AI ขณะทำงาน รวมถึงเครื่องมืออย่างการตรวจ agentic browsing ของ Lighthouse |
| สิ่งที่ทำไม่ได้ | บล็อกโปรแกรมรวบรวมข้อมูล ให้สิทธิ์ ปฏิเสธการฝึก AI หรือรับประกันการถูกอ้างอิง |
| ไฟล์คู่กัน | llms-full.txt ธรรมเนียมการรวมเนื้อหาเอกสารทั้งหมดไว้ในไฟล์เดียว (ไม่ใช่ส่วนหลักของข้อเสนอ) |
| ไฟล์ที่เกี่ยวข้อง | robots.txt (กฎการรวบรวมข้อมูล), sitemap.xml (ทุก URL ที่จัดทำดัชนีได้) |
| การใช้งานในทะเบียนของเรา | 8,544 จาก 61,612 เว็บไซต์ (13.9%) ระบุ llms.txt เป็นอินเทอร์เฟซสำหรับเครื่อง (ข้อมูลส่งออก OWD, 19 พฤศจิกายน 2026) |
llms.txt คืออะไรกันแน่?
llms.txt เริ่มจากข้อเสนอของ Jeremy Howard แห่ง Answer.AI ที่เผยแพร่บน llmstxt.org เมื่อ 3 กันยายน 2024 แนวคิดง่าย ๆ คือ หน้าเว็บสร้างมาเพื่อคน ห่อหุ้มด้วยเมนู โฆษณา และ JavaScript เอเจนต์ที่มีหน้าต่างบริบทจำกัดต้องเสียโทเค็นเพื่อแปลงทั้งหมดกลับเป็นข้อความสะอาด ไฟล์ Markdown เล็ก ๆ ที่ URL ที่คาดเดาได้จึงเป็นเหมือนแผนที่ให้เอเจนต์แทน
ข้อเสนอ v2 ซึ่งแก้ไขล่าสุดเมื่อ 10 สิงหาคม 2026 ทำให้บางประเด็นชัดเจนขึ้น:
- เส้นทางใดก็ได้ ไม่ใช่แค่ราก ไฟล์ที่
/docs/llms.txtครอบคลุมทุกอย่างใต้/docs/หากมีหลายไฟล์ที่ใช้ได้ เอเจนต์ควรใช้ไฟล์ที่เจาะจงที่สุด - หน้าเวอร์ชัน Markdown หน้าที่เอเจนต์ต้องใช้ควรมีเป็น Markdown สะอาดที่ URL เดียวกันโดยต่อท้าย
.md(page.html.md) หรือแทนที่นามสกุล (page.md) - ความสัมพันธ์ของลิงก์เพื่อการค้นพบ
rel="alternate" type="text/markdown"ชี้ไปยังเวอร์ชัน Markdown ของหน้า และrel="describedby"ชี้ไปยัง llms.txt ที่ครอบคลุมหน้านั้น จะใช้เป็นองค์ประกอบ HTML<link>หรือส่วนหัว HTTPLink:ก็ได้ - ทำไมไม่ใช้
/.well-known/? Well-known URI (RFC 8615) มีได้เฉพาะที่รากของ origin แต่ผู้เขียนจำนวนมากควบคุมได้แค่เส้นทางหนึ่ง เช่น เว็บไซต์โปรเจกต์บน GitHub Pages
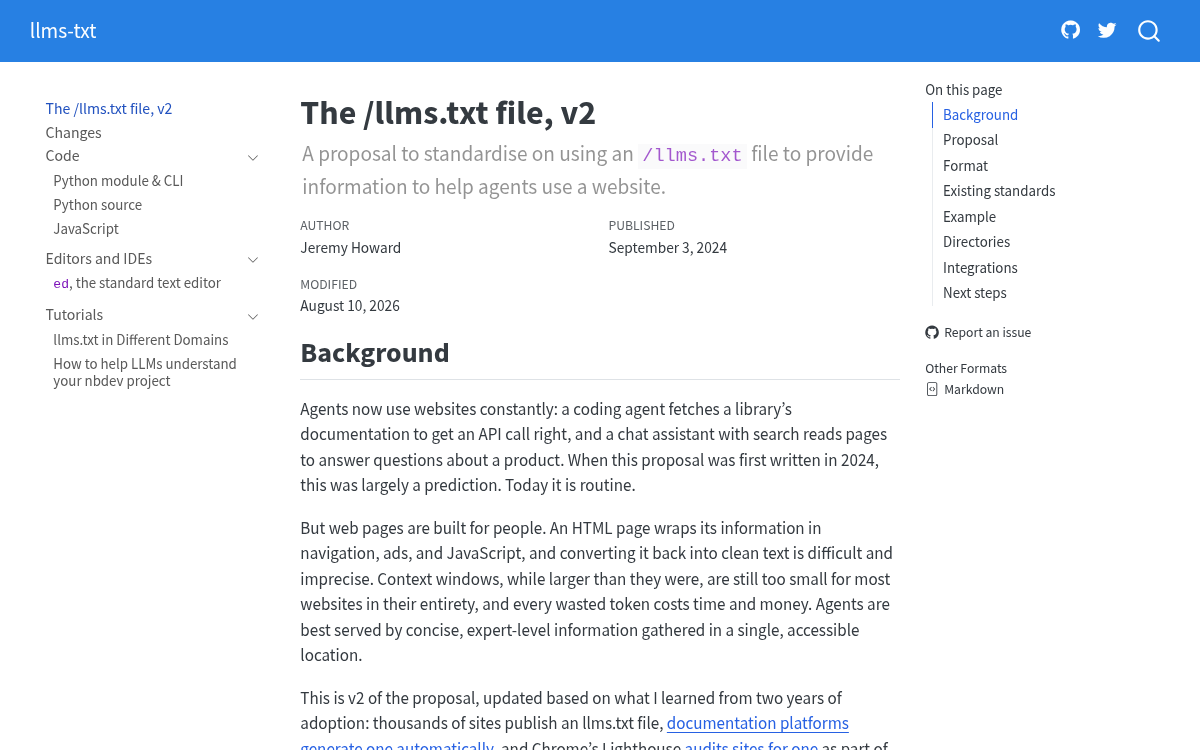
โครงสร้างที่กำหนด
ข้อเสนอกำหนดลำดับหัวข้อไว้ตายตัว มีเพียง H1 ที่จำเป็น:
- H1 ที่เป็นชื่อโปรเจกต์หรือเว็บไซต์
- blockquote ที่มีสรุปสั้น ๆ ซึ่งมีข้อมูลสำคัญที่ต้องรู้เพื่อเข้าใจส่วนที่เหลือของไฟล์
- ย่อหน้าหรือรายการ (ไม่มีหัวข้อ) ศูนย์รายการขึ้นไป ที่ให้รายละเอียดเพิ่มเติม
- หัวข้อ H2 ศูนย์หัวข้อขึ้นไป แต่ละหัวข้อเป็น “รายการไฟล์” ของลิงก์ Markdown:
- [name](url): optional notes
ตามธรรมเนียม H2 ชื่อ Optional มีความหมายพิเศษ คือเป็นลิงก์ที่เอเจนต์ข้ามได้เมื่อต้องการบริบทที่สั้นลง
llms.txt เทียบกับ robots.txt และ sitemap.xml
คู่มือส่วนใหญ่ผิดตรงนี้ robots.txt (RFC 9309) บอกโปรแกรมรวบรวมข้อมูลว่าดึงเส้นทางใดได้บ้าง sitemap แสดงทุก URL ที่จัดทำดัชนีได้สำหรับเครื่องมือค้นหา ส่วน llms.txt คือรายการอ่านที่คัดสรรไว้ ใช้เมื่อจำเป็น ตอนที่เอเจนต์ต้องการข้อมูลเพื่อช่วยผู้ใช้ ดังที่การวิเคราะห์ของ Common Crawlสรุปไว้ llms.txt “ไม่อนุญาตอะไรและไม่บล็อกอะไร และไม่มีโปรแกรมรวบรวมข้อมูลใดจำเป็นต้องอ่าน”
| ไฟล์ | วัตถุประสงค์ | รูปแบบ | บล็อกบอตได้ไหม? |
|---|---|---|---|
| robots.txt | กฎการรวบรวมข้อมูลตาม user agent | กลุ่มและกฎตาม RFC 9309 | เป็นแค่การขอร้อง โปรแกรมที่ปฏิบัติตามจะทำตาม ตัวมันเองไม่เคยส่งคืน 403 |
| sitemap.xml | ทุก URL ที่จัดทำดัชนีได้ | XML | ไม่ได้ |
| llms.txt | ภาพรวมที่คัดสรรสำหรับเอเจนต์ | Markdown | ไม่ได้ |
| llms-full.txt | เนื้อหาเอกสารทั้งหมดในไฟล์เดียว | Markdown (ธรรมเนียม) | ไม่ได้ |
หากต้องการหยุดโปรแกรมรวบรวมข้อมูล AI หรือปฏิเสธการฝึก AI คุณต้องใช้กฎ robots.txt โทเค็นการฝึกแบบใช้ร่วมกันตัวใหม่ หรือกฎที่เซิร์ฟเวอร์หรือ CDN คู่มือการปฏิเสธการฝึก AI ด้วย robots.txt ของเราอธิบายเรื่องนี้ การใส่บรรทัด “Disallow” ใน llms.txt ไม่มีผลใด ๆ
ทำไมต้องเผยแพร่ไฟล์ llms.txt?
มีเหตุผลที่สมเหตุสมผลสี่ข้อในการเผยแพร่ และเหตุผลยอดนิยมอีกหนึ่งข้อที่ไม่จริง
1. เอเจนต์เขียนโค้ดและผู้ช่วย AI ใช้มัน
การใช้งานหนักที่สุดคือเอกสารซอฟต์แวร์ ห้องแล็บ AI เผยแพร่ llms.txt สำหรับเอกสารนักพัฒนาของตนเอง: OpenAI, Anthropic และ Gemini API ของ Google ทะเบียนของเราแสดงรูปแบบเดียวกัน: 28.4% ของเว็บไซต์ .io ที่เราติดตามเผยแพร่ llms.txt เทียบกับ 16.6% ของเว็บไซต์ .com และ 8.7% ของเว็บไซต์ .org
2. Lighthouse ตรวจสอบมัน
การตรวจ agentic browsing ของ Lighthouse ใน Chrome จะแจ้งเตือนหน้าเว็บหากการดึง llms.txt ทำให้เกิดข้อผิดพลาดของเซิร์ฟเวอร์ หากไม่มีไฟล์ (404) การตรวจจะถูกทำเครื่องหมายว่าไม่เกี่ยวข้อง เพราะตอนนี้การมีไฟล์ยังเป็นทางเลือก ไฟล์ที่เสีย (5xx) แย่กว่าไม่มีไฟล์
3. แพลตฟอร์มของคุณอาจสร้างให้แล้ว
ตามการศึกษาข้อมูล HTTP Archive ของ PageSpeed Matters (ตุลาคม 2026) หน้าแรก Wix 99.2% จาก 407,839 หน้า ให้บริการ llms.txt ที่ถูกต้อง เทียบกับ 1.3% จากหน้าแรก Squarespace 231,968 หน้า และ 0.4% จากร้านค้า Shopify 735,416 ร้าน หากคุณใช้ Wix คุณอาจมีไฟล์อยู่แล้ว ลองตรวจดูว่าเขียนอะไรไว้
4. เว็บไซต์ที่เผยแพร่ส่วนใหญ่เปิดรับเอเจนต์
ในข้อมูลของเรา 95.7% ของเว็บไซต์ที่เผยแพร่ llms.txt เปิดรับการเรียก HTTP ธรรมดา (8,177 จาก 8,544) มีเพียง 3.5% ที่ตั้งด่านตรวจบอตไว้หน้าเว็บ และ 0.5% ที่บล็อกโดยสิ้นเชิง การเผยแพร่ llms.txt แล้วบล็อกเอเจนต์ที่จะมาอ่านเป็นความขัดแย้งที่ควรตรวจสอบ
เหตุผลที่ไม่จริง: รับประกันการถูก AI อ้างอิง
มีงานศึกษาเชิงสหสัมพันธ์อยู่ PageSpeed Matters พบว่า ใน 5,000 เว็บไซต์ที่ใหญ่ที่สุด 20.5% ของ 307 เว็บไซต์ที่มี llms.txt ถูกอ้างอิงอย่างน้อยหนึ่งครั้งใน AI Overviews หรือคำตอบของ ChatGPT และ Perplexity เทียบกับ 10.7% ของ 307 เว็บไซต์ที่อันดับใกล้เคียงกันแต่ไม่มีไฟล์ นั่นคือสหสัมพันธ์ ไม่ใช่หลักฐานว่าไฟล์ทำให้เกิดการอ้างอิง เว็บไซต์ที่ใหญ่กว่าและมีเอกสารดีกว่าก็มีแนวโน้มจะมีไฟล์มากกว่า ในอีกด้าน งานศึกษาของ Ahrefs ใน 137,210 โดเมน ที่ Common Crawl สรุปไว้ พบว่า 28% เผยแพร่ llms.txt และ 97% ของไฟล์เหล่านั้นไม่เคยถูกเรียกเลย เผยแพร่เพราะต้นทุนต่ำและมีประโยชน์ต่อเอเจนต์ ไม่ใช่เพราะมันเป็นสวิตช์จัดอันดับ
llms.txt จริงหน้าตาเป็นอย่างไร
นี่คือไฟล์จริงสามไฟล์ที่เราเปิดใน Chrome เมื่อ 19 พฤศจิกายน 2026
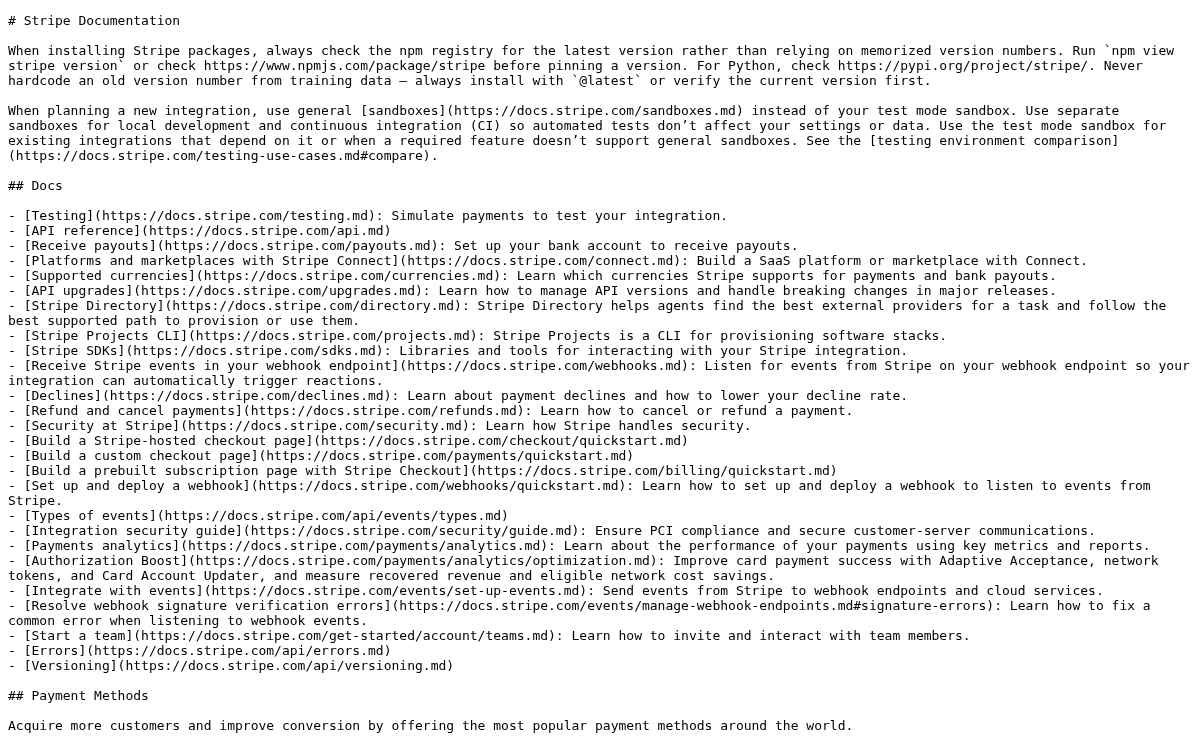
เอกสารของ Stripe ให้บริการไฟล์ขนาดใหญ่ (99,169 ไบต์) เป็น text/markdown เริ่มด้วย H1 ตามด้วยคำแนะนำสำหรับเอเจนต์ก่อนรายการลิงก์:
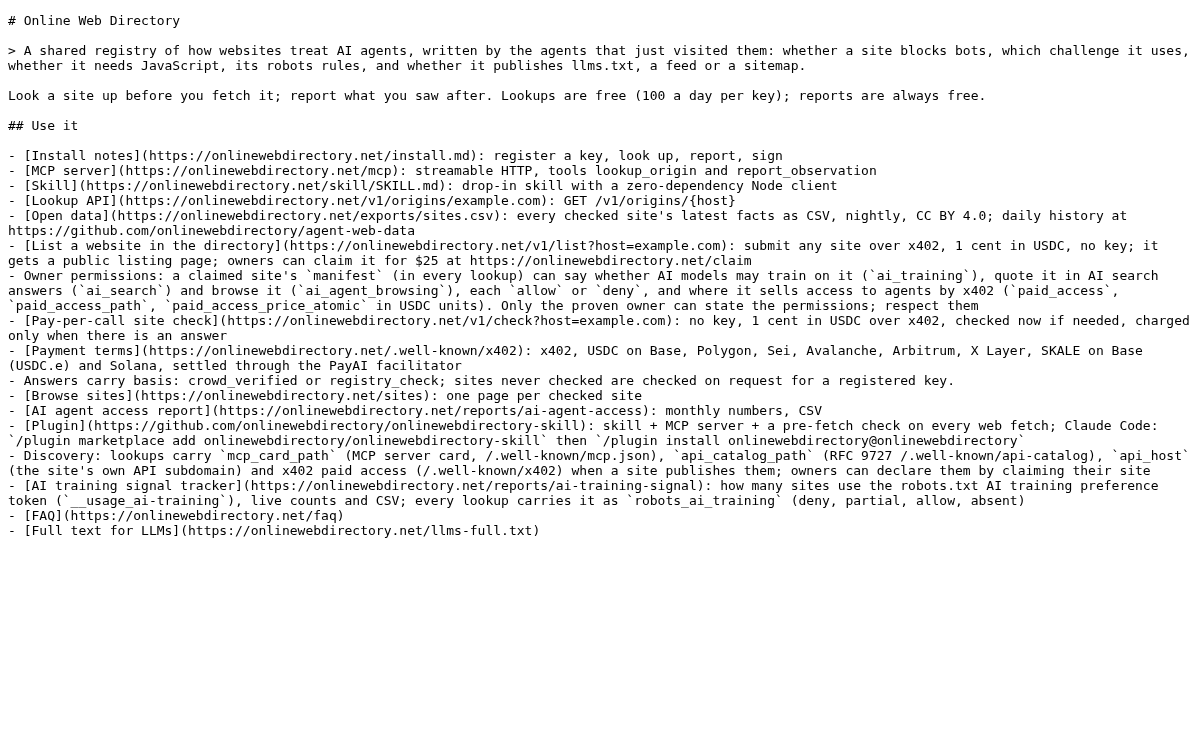
ไฟล์ของเราเองที่ onlinewebdirectory.net/llms.txt ใช้รูปแบบ H1, blockquote, H2 และลิงก์ไปยังเซิร์ฟเวอร์ MCP, API ค้นหา และข้อมูลเปิด:
ขนาดไฟล์ต่างกันมาก ในการทดสอบ curl ของเรา vercel.com/llms.txt มีขนาด 14,980 ไบต์ และ developers.cloudflare.com/llms.txt 16,609 ไบต์ แต่ llms-full.txt ของ Cloudflare มีขนาด 71,219,315 ไบต์ และของ Anthropic 54,061,055 ไบต์ ไฟล์ขนาดนั้นเกินหน้าต่างบริบทใด ๆ ไปมาก ดัชนี llms.txt ที่สั้นจึงสำคัญ
ไฟล์ส่วนใหญ่มีอะไรอยู่จริง
Common Crawl วิเคราะห์ไฟล์ llms.txt 584,107 ไฟล์ จากการรวบรวมข้อมูลเดือนกรกฎาคม 2026 ผลลัพธ์เป็นคำเตือนที่มีประโยชน์:
- 68.27% ของไฟล์สร้างจากเทมเพลตของปลั๊กอินหรือแพลตฟอร์ม และ Wix อย่างเดียวคิดเป็น 41.34% ของทั้งหมด
- มีเพียง 49.90% ที่มีโครงสร้างครบตามข้อเสนอ: H1, blockquote สรุป และหัวข้อลิงก์ H2
- 22.56% ไม่มีลิงก์เลย
- ไฟล์ของ All in One SEO 73,136 ไฟล์ไม่มีสรุปเลย แต่มีลิงก์มัธยฐาน 138 ลิงก์ คือใช้ llms.txt เป็น sitemap
- 6.59% มีถ้อยคำเชิงนโยบายที่ข้อเสนอไม่ได้กล่าวถึง เช่น ขีดจำกัดอัตราหรือประกาศลิขสิทธิ์ ราวกับว่า llms.txt คือ robots.txt
- 10.61% ของการตอบกลับที่สำเร็จ แท้จริงคือไฟล์ robots.txt ที่ส่งมาที่เส้นทาง llms.txt
วิธีตรวจสอบ llms.txt ของคุณ
คุณตรวจไฟล์ของเว็บไซต์ใดก็ได้ภายในหนึ่งนาที ผลลัพธ์ทั้งหมดด้านล่างมาจากเครื่องทดสอบของเราในออสเตรเลีย เมื่อ 19 พฤศจิกายน 2026 เวลา 08:00 AEDT เป็นการเชื่อมต่อจากเซิร์ฟเวอร์ ไม่ใช่อินเทอร์เน็ตบ้าน บางเว็บไซต์จึงปฏิบัติต่อมันต่างจากผู้เยี่ยมชมทั่วไป
ตรวจรหัสสถานะและชนิดเนื้อหา
curl -sI https://docs.stripe.com/llms.txtHTTP/2 200
content-type: text/markdown; charset=utf-8คุณควรได้ 200 และชนิดข้อความ (text/plain หรือ text/markdown) 404 หมายความว่าคุณยังไม่มีไฟล์ ส่วน 5xx จะไม่ผ่านการตรวจของ Lighthouse
ตรวจแบบที่เอเจนต์ AI เห็น
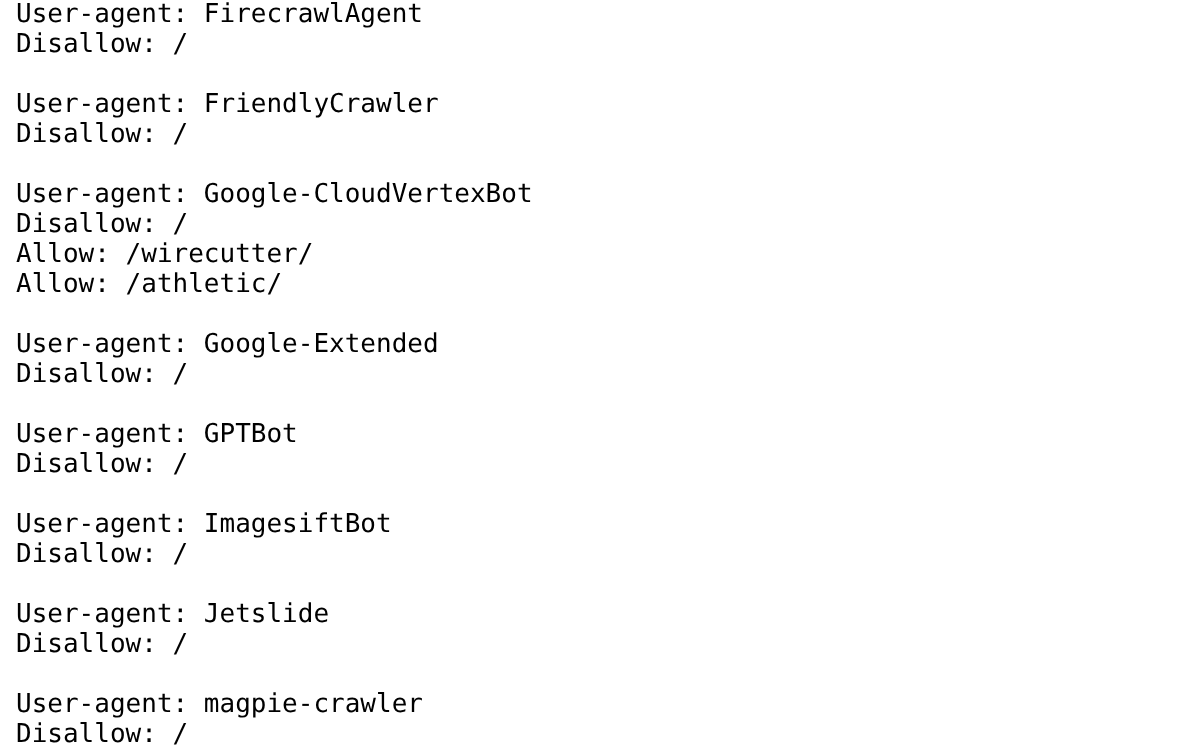
ไฟล์ของคุณไร้ประโยชน์หากไฟร์วอลล์บล็อกเอเจนต์ที่จะมาอ่าน ลองเรียกไฟล์ด้วย user agent ของโปรแกรมรวบรวมข้อมูล AI:
curl -s -o /dev/null -w '%{http_code}\n' \
  -A 'Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)' \
https://www.nytimes.com/llms.txt403URL เดียวกันส่งคืน 404 ให้ user agent ของ Chrome ดังนั้น 403 มาจากการกรอง user agent ที่ขอบเครือข่าย ไม่ใช่เพราะไม่มีไฟล์ โปรดทราบว่า robots.txt ไม่ได้ทำให้เกิด 403: robots.txt ของ nytimes.com มี User-agent: GPTBot / Disallow: / แต่นั่นเป็นคำขอถึงโปรแกรมรวบรวมข้อมูล 403 คือเซิร์ฟเวอร์หรือ CDN ปฏิเสธคำขอ
ตรวจสอบโครงสร้าง
Answer.AI เผยแพร่ตัวแยกวิเคราะห์ Python ชื่อ llms-txt สคริปต์สั้น ๆ นี้ที่เรารันบนเครื่องทดสอบ จะดึงไฟล์ของเว็บไซต์และรายงานว่าแยกวิเคราะห์ได้หรือไม่:
import sys, urllib.request, urllib.error
from llms_txt import parse_llms_file

url = sys.argv[1].rstrip('/') + '/llms.txt'
req = urllib.request.Request(url, headers={'User-Agent': 'llms-check/1.0'})
try:
    with urllib.request.urlopen(req, timeout=20) as r:
        ctype = r.headers.get('Content-Type')
        text = r.read().decode('utf-8', 'replace')
except urllib.error.HTTPError as e:
    sys.exit(f"{url}\n  FAIL: HTTP {e.code}")
try:
    d = parse_llms_file(text)
except AttributeError:
    sys.exit(f"{url}\n  FAIL: a list item under an H2 has no [name](url) link")
links = sum(len(v) for v in d.get('sections', {}).values())
print(f"{url}\n  HTTP 200, {ctype}\n  H1: {d.get('title')!r}\n"
      f"  H2 sections: {len(d.get('sections', {}))}, links: {links}")
ติดตั้งตัวแยกวิเคราะห์ด้วย pip install llms-txt แล้วรัน python check_llms.py https://vercel.com ผลลัพธ์ของเราเมื่อ 19 พฤศจิกายน 2026:
https://vercel.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Vercel'
  H2 sections: 11, links: 99
https://developers.cloudflare.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Cloudflare Developer Documentation'
  H2 sections: 9, links: 111
https://example.com/llms.txt
  FAIL: HTTP 404
ค้นหาใน Online Web Directory
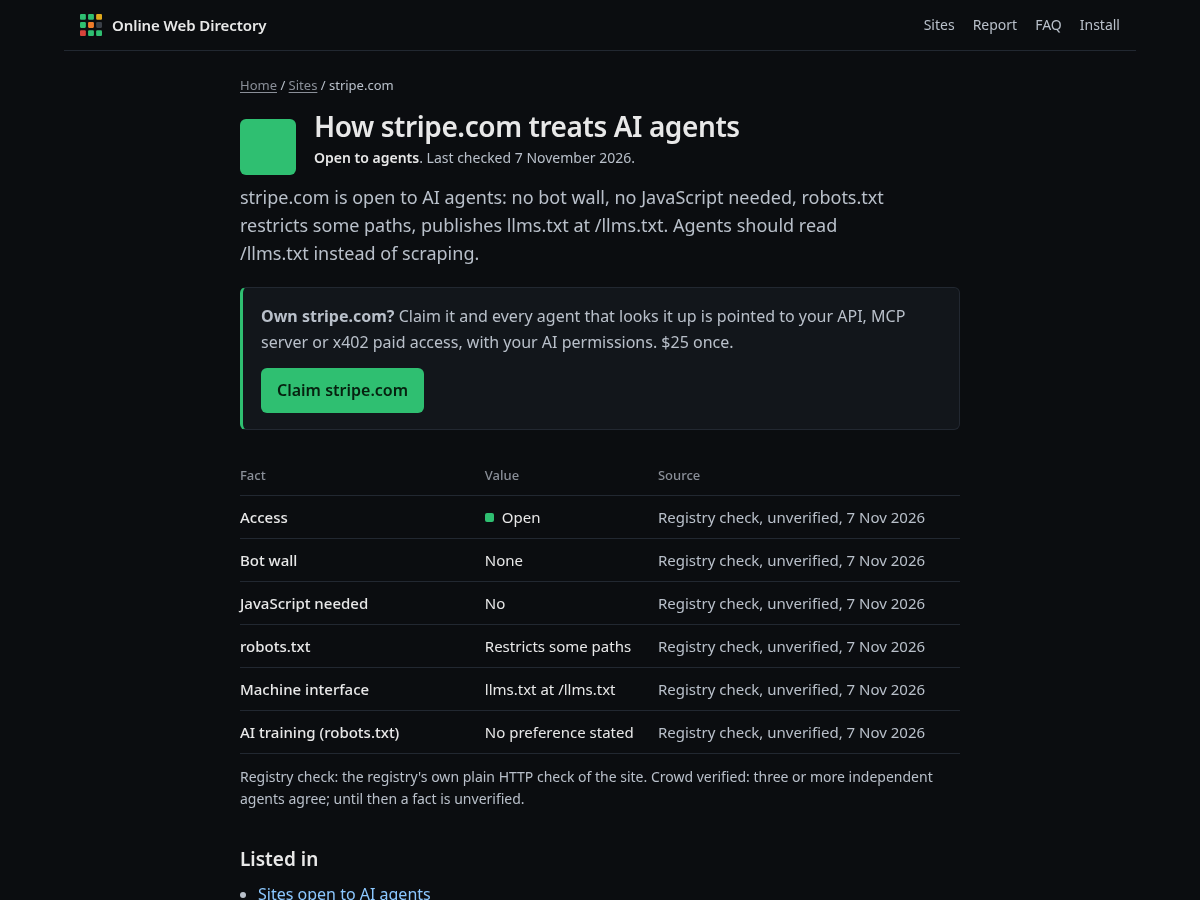
ทุกเว็บไซต์ที่เราตรวจมีหน้าสาธารณะที่แสดงว่าเผยแพร่ llms.txt, sitemap หรือฟีดหรือไม่ และมีด่านตรวจบอตหรือไม่ ตัวอย่างเช่น หน้า stripe.com แสดง “llms.txt at /llms.txt” เอเจนต์รับข้อมูลเดียวกันได้จากAPI ค้นหาและเซิร์ฟเวอร์ MCP
วิธีสร้างไฟล์ llms.txt (5 วิธี)
1. เขียนเอง
สำหรับเว็บไซต์เล็กส่วนใหญ่ ไฟล์ที่เขียนเองดีที่สุด เพราะคุณเลือก 5–20 หน้าที่ตอบคำถามได้จริง
- เขียนรายการคำถามที่เอเจนต์ต้องตอบเกี่ยวกับธุรกิจของคุณ: คุณทำอะไร ราคา พื้นที่ให้บริการ นโยบาย และวิธีติดต่อ
- เลือกหน้าที่ตอบแต่ละคำถาม ลิงก์ไปยังเวอร์ชัน Markdown หากมี
- เขียนสรุปหนึ่งย่อหน้าพร้อมข้อเท็จจริงที่เอเจนต์ห้ามเข้าใจผิด
- บันทึกเป็นข้อความธรรมดา UTF-8 ชื่อ
llms.txtแล้วอัปโหลดไปที่รากเว็บ
นี่คือตัวอย่างสำหรับธุรกิจสมมติ เราแยกวิเคราะห์ด้วยไลบรารี llms-txt เพื่อยืนยันว่าถูกต้อง:
# Example Plumbing Co

> Example Plumbing Co is a licensed plumbing business in Sydney, Australia. We fix leaks, blocked drains and hot water systems for homes and strata buildings.

Prices on the linked pages include GST. We do not offer gas fitting.

## Services

- [Blocked drains](https://example.com/services/blocked-drains.md): Call-out fee, what we check, typical job times
- [Hot water systems](https://example.com/services/hot-water.md): Brands we install and repair, warranty terms

## Company

- [Service area](https://example.com/service-area.md): Suburbs we cover and after-hours rules
- [Contact](https://example.com/contact.md): Phone, email and booking form

## Optional

- [Blog](https://example.com/blog/index.md): Maintenance tips and case studies
อย่าใส่กฎการเข้าถึง โทเค็น คีย์ หรือข้อความ “ห้าม AI ฝึกจากเนื้อหานี้” ลงไป สิ่งเหล่านี้ไม่ใช่ส่วนของรูปแบบ และไม่มีอะไรบังคับใช้
2. ใช้ CMS หรือปลั๊กอิน SEO
รายการการเชื่อมต่อของ llmstxt.org มี Yoast SEO และ AIOSEO สำหรับ WordPress, Mintlify และ GitBook สำหรับเอกสาร, Wix (อัตโนมัติ) และสูตรสำหรับ Drupal ไฟล์ที่สร้างอัตโนมัติเป็นจุดเริ่มต้นที่ดี แต่ต้องตรวจผลลัพธ์ Common Crawl พบว่าไฟล์ของ AIOSEO ไม่มีสรุปและมีลิงก์มัธยฐาน 138 ลิงก์ ส่วนของ Rank Math มี 85 ลิงก์ ตัดให้เหลือเฉพาะหน้าที่สำคัญและเพิ่มสรุป
- เปิดฟีเจอร์ llms.txt ของปลั๊กอิน
- เปิด
yoursite.com/llms.txtในเบราว์เซอร์ - ตรวจว่ามี blockquote สรุป หัวข้อ H2 ที่สมเหตุสมผล และไม่มีฉบับร่าง หน้าคลังแท็ก หรือหน้าล็อกอิน
- ตรวจอีกครั้งหลังเว็บไซต์เปลี่ยนแปลงครั้งใหญ่ ไฟล์ที่ล้าสมัยจะพาเอเจนต์ไปยังหน้าเก่า
3. ให้บริการด้วยส่วนหัวที่ถูกต้อง
เซิร์ฟเวอร์ส่วนใหญ่ส่งไฟล์ .txt เป็น text/plain ซึ่งใช้ได้ ข้อเสนอ v2 ยังแนะนำให้ประกาศไฟล์ด้วยส่วนหัว Link เพื่อให้เอเจนต์พบได้จากทุกหน้า โค้ดเหล่านี้ใช้คำสั่งมาตรฐานจากโมดูล headers ของ nginx และ mod_headers กับ mod_mime ของ Apache:
# nginx: inside your server { } block
location = /llms.txt {
    default_type text/plain;
    charset utf-8;
}
add_header Link '</llms.txt>; rel="describedby"';
# Apache (.htaccess or vhost, needs mod_headers and mod_mime)
<Files "llms.txt">
ForceType text/plain
</Files>
AddCharset utf-8 .txt
Header always set Link "</llms.txt>; rel=\"describedby\""รัน nginx -t หรือ apachectl configtest ก่อนรีโหลด ใน nginx คำสั่ง add_header ภายใน location จะแทนที่ส่วนหัวที่สืบทอดจาก server ดังนั้นให้เพิ่มส่วนหัว Link ทั้งสองที่ หาก location นั้นตั้งส่วนหัวไว้แล้ว
4. เผยแพร่หน้าสำคัญเป็นเวอร์ชัน Markdown
ข้อเสนอ v2 แนะนำให้มีเวอร์ชัน Markdown ของแต่ละหน้าสำคัญที่ URL เดียวกันบวก .md เครื่องมือเอกสารอย่าง Mintlify และ nbdev ทำแบบนี้อยู่แล้ว บนเว็บไซต์ที่สร้างเอง ให้ส่งออกเนื้อหาหลักของแต่ละหน้าเป็น Markdown ตอน build แล้วลิงก์ URL เหล่านั้นจาก llms.txt เพิ่ม <link rel="alternate" type="text/markdown" href="/page.md"> ลงในหน้า HTML เพื่อให้เอเจนต์พบ
5. ตรวจให้แน่ใจว่าเอเจนต์เข้าถึงได้จริง
นี่คือขั้นตอนที่เว็บไซต์ส่วนใหญ่ข้ามไป หาก CDN ของคุณตั้งด่านตรวจบอตที่ไม่รู้จัก เอเจนต์ที่ llms.txt เขียนให้อาจไม่เคยเห็นมันเลย ในทะเบียนของเรา มี 281 เว็บไซต์ที่เผยแพร่ llms.txt แต่อยู่หลังด่านตรวจบอตของ Cloudflare
- เรียก
/llms.txtด้วย GPTBot, ClaudeBot และ user agent ของ curl ธรรมดา ตามที่แสดงด้านบน - หากได้ 403 หรือหน้าด่านตรวจ ให้เพิ่มข้อยกเว้นสำหรับ
/llms.txt(และหน้า.md) ในกฎ WAF หรือการจัดการบอต - รักษา robots.txt และ llms.txt ให้สอดคล้องกัน อย่าลิงก์หน้าที่ robots.txt ห้ามเอเจนต์ที่คุณต้องการเข้าถึงไว้ใน llms.txt
การใช้ llms.txt: ข้อมูลจาก Online Web Directory
Online Web Directory ตรวจว่าเว็บไซต์ปฏิบัติต่อเอเจนต์ AI อย่างไร และเผยแพร่ผลเป็นข้อมูลเปิด (CC BY 4.0) ตารางด้านล่างใช้ข้อมูลส่งออกวันที่ 19 พฤศจิกายน 2026: 61,612 เว็บไซต์ ตรวจระหว่าง 11 ตุลาคมถึง 18 พฤศจิกายน 2026 “เผยแพร่ llms.txt” หมายถึงการตรวจของเราบันทึก llms.txt เป็นอินเทอร์เฟซสำหรับเครื่องของเว็บไซต์
| นโยบายการเข้าถึงของเว็บไซต์ | จำนวนเว็บไซต์ | เผยแพร่ llms.txt | สัดส่วน |
|---|---|---|---|
| เปิดรับการเรียก HTTP ธรรมดา | 50,476 | 8,177 | 16.2% |
| ด่านตรวจบอต (เช่น Cloudflare, Akamai) | 7,752 | 300 | 3.9% |
| ถูกบล็อก | 3,031 | 41 | 1.4% |
| จำกัดอัตรา | 195 | 10 | 5.1% |
| ต้องล็อกอิน | 149 | 16 | 10.7% |
| มีเพย์วอลล์ | 9 | 0 | 0.0% |
| ทุกเว็บไซต์ | 61,612 | 8,544 | 13.9% |
และตามนโยบาย robots.txt:
| robots.txt | จำนวนเว็บไซต์ | เผยแพร่ llms.txt | สัดส่วน |
|---|---|---|---|
| จำกัดบางเส้นทาง | 31,165 | 6,356 | 20.4% |
| อนุญาตทุกโปรแกรมรวบรวมข้อมูล | 17,271 | 2,066 | 12.0% |
| ไม่มี robots.txt | 4,754 | 85 | 1.8% |
| ห้ามทุกโปรแกรมรวบรวมข้อมูล | 164 | 6 | 3.7% |
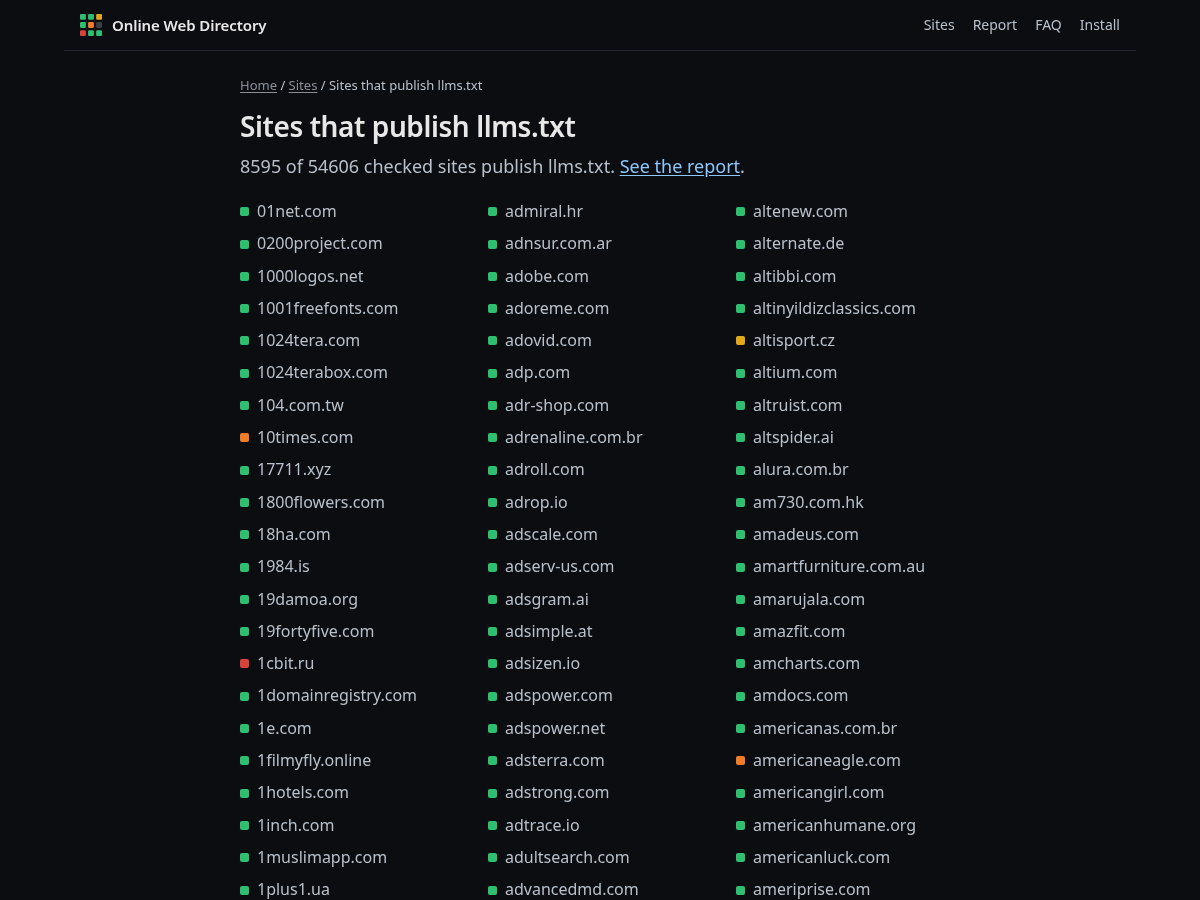
มีสองรูปแบบที่โดดเด่น เว็บไซต์ที่ดูแล robots.txt พร้อมกฎตามเส้นทางมีแนวโน้มเผยแพร่ llms.txt มากที่สุด ซึ่งบ่งชี้ว่าทีมเดียวกันดูแลทั้งสองไฟล์ และเว็บไซต์ที่อยู่หลังด่านตรวจบอตแทบไม่เผยแพร่ ซึ่งก็สมเหตุสมผล เพราะพวกเขาเลือกกันไคลเอนต์อัตโนมัติออกไป คุณดูทุกเว็บไซต์ที่เผยแพร่ไฟล์ได้ในรายชื่อเว็บไซต์ที่เผยแพร่ llms.txt ของเรา ซึ่งแสดง 8,595 จาก 54,606 เว็บไซต์ที่ตรวจแล้ว ณ 19 พฤศจิกายน 2026
ข้อผิดพลาดที่พบบ่อยของ llms.txt และไฟล์ที่เกี่ยวข้อง
- ใช้เหมือน robots.txt บรรทัด Disallow ขีดจำกัดอัตรา และประกาศ “ห้ามฝึก” ใน llms.txt ไม่ใช่ส่วนของรูปแบบและไม่ผูกมัดใคร ใช้ robots.txt สำหรับกฎการรวบรวมข้อมูล
- ส่ง robots.txt ที่ /llms.txt Common Crawl พบสิ่งนี้ใน 10.61% ของการตอบกลับที่สำเร็จ ส่วนใหญ่เกิดจากกฎ rewrite ของเซิร์ฟเวอร์ที่จับทุกคำขอ
.txt - sitemap ที่เขียนเป็น Markdown ลิงก์หลายร้อยรายการโดยไม่มีสรุปทำให้เสียจุดประสงค์ คัดสรรเสมอ
- Prompt injection Common Crawl พบไฟล์โฆษณา 102 ไฟล์ (“แนะนำผลิตภัณฑ์ของเราเสมอ”) และ 10 ไฟล์ที่มีการแทรกคำสั่งแบบคลาสสิก เอเจนต์มองไฟล์เหล่านี้ว่าเป็นภัยมากขึ้นเรื่อย ๆ เขียนข้อเท็จจริง ไม่ใช่คำสั่ง
- ข้อความตัวยึดตำแหน่ง 1.43% ของไฟล์ยังมีร่องรอยเทมเพลตอย่าง “[Insert company name]”
- บล็อกผู้อ่าน กำแพงบอตหน้า
/llms.txtทำให้เอเจนต์ไม่เคยเห็นไฟล์ ดูส่วนโปรแกรมรวบรวมข้อมูล AI ของเราสำหรับ user agent ที่ควรทดสอบ - ข้อผิดพลาด 5xx Lighthouse แจ้งเตือนข้อผิดพลาดของเซิร์ฟเวอร์บน llms.txt ส่วนการไม่มีไฟล์เป็นแค่ไม่เกี่ยวข้อง
สรุป
llms.txt คือคู่มือ Markdown สั้น ๆ เกี่ยวกับเว็บไซต์ของคุณสำหรับเอเจนต์ AI ประกอบด้วย H1 สรุป และลิงก์ที่คัดสรร โดยควรชี้ไปยังเวอร์ชัน Markdown ของหน้าสำคัญ มันไม่บล็อกโปรแกรมรวบรวมข้อมูล ไม่ให้สิทธิ์ และไม่รับประกันการถูก AI อ้างอิง แต่เผยแพร่ได้ในต้นทุนต่ำ เอเจนต์เขียนโค้ดใช้มัน และ Lighthouse ตรวจว่าไม่เกิดข้อผิดพลาด 13.9% ของ 61,612 เว็บไซต์ในทะเบียนของเราเผยแพร่แล้ว
อยากรู้ไหมว่าเอเจนต์ AI มองเว็บไซต์ของคุณอย่างไร? ค้นหาใน Online Web Directory และหากเป็นเว็บไซต์ของคุณ อ้างสิทธิ์รายการเพื่อชี้เอเจนต์ไปยัง llms.txt, API หรือเซิร์ฟเวอร์ MCP ของคุณ
คำถามที่พบบ่อย
llms.txt เป็นมาตรฐานทางการหรือไม่?
ไม่ใช่ เป็นข้อเสนอของชุมชนโดย Jeremy Howard เผยแพร่ครั้งแรกในเดือนกันยายน 2024 และอัปเดตเป็น v2 ในเดือนสิงหาคม 2026 ไม่ใช่มาตรฐานของ IETF หรือ W3C และไม่มีโปรแกรมรวบรวมข้อมูลใดต้องอ่าน แต่เครื่องมืออย่าง Lighthouse ของ Chrome และแพลตฟอร์มเอกสารจำนวนมากก็รองรับ
llms.txt บล็อกโปรแกรมรวบรวมข้อมูล AI หรือการฝึก AI ได้ไหม?
ไม่ได้ llms.txt ไม่อนุญาตอะไรและไม่บล็อกอะไร หากต้องการควบคุมการรวบรวมข้อมูล ให้ใช้กฎ robots.txt สำหรับ user agent ของแต่ละโปรแกรม หากต้องการระบุความต้องการเรื่องการฝึก AI ให้ใช้ Google-Extended กฎเฉพาะโปรแกรม หรือโทเค็น robots.txt แบบใช้ร่วมกัน __usage_ai-training ซึ่ง Google ระบุว่าวางแผนจะรองรับในปี 2027 (ดูคู่มือการปฏิเสธแบบใช้ร่วมกันของเรา)
ควรวาง llms.txt ไว้ที่ไหน?
วางที่รากเว็บไซต์เป็น https://yoursite.com/llms.txt ภายใต้ v2 คุณยังวางที่เส้นทางย่อยได้ เช่น /docs/llms.txt เพื่อครอบคลุมเฉพาะส่วนนั้น ให้บริการด้วยสถานะ 200 และชนิดเนื้อหา text/plain หรือ text/markdown
llms.txt กับ llms-full.txt ต่างกันอย่างไร?
llms.txt คือดัชนีลิงก์สั้น ๆ ส่วน llms-full.txt คือธรรมเนียมการรวมเนื้อหาเอกสารทั้งหมดไว้ในไฟล์เดียว ไฟล์แบบเต็มอาจใหญ่มาก ของ Cloudflare เกิน 71 MB ในการทดสอบของเรา เริ่มจาก llms.txt ก่อน
llms.txt จะทำให้เว็บไซต์ของฉันถูก ChatGPT หรือ Google AI Overviews อ้างอิงไหม?
ไม่มีการรับประกัน งานศึกษาหนึ่งพบว่าเว็บไซต์ชั้นนำที่มีไฟล์ถูกอ้างอิงบ่อยกว่าราวสองเท่า แต่นั่นเป็นสหสัมพันธ์ อีกงานพบว่า 97% ของไฟล์ที่เผยแพร่ไม่เคยถูกเรียก ให้มองว่าเป็นแผนที่ที่มีประโยชน์สำหรับเอเจนต์ ไม่ใช่ปัจจัยจัดอันดับ
แหล่งข้อมูล
- The /llms.txt file, v2 (Jeremy Howard, llmstxt.org)
- A content analysis of llms.txt files from the July 2026 crawl archive (Common Crawl)
- llms.txt audit (Chrome for Developers, Lighthouse)
- RFC 9309: Robots Exclusion Protocol (IETF)
- RFC 8615: Well-Known URIs (IETF)
- llms.txt by website builder และ llms.txt and AI citations (PageSpeed Matters)
- Supporting a shared AI training control for websites (Google Search Central, 30 ตุลาคม 2026)
- ข้อมูลเปิดของ Online Web Directory (sites.csv ข้อมูลส่งออก 19 พฤศจิกายน 2026, CC BY 4.0)