

La plupart des « listes de crawlers IA » que vous trouverez sont copiées les unes sur les autres, et beaucoup sont obsolètes. Elles citent encore Claude-Web comme crawler d’Anthropic, inventent un bot « Googlebot-Extended » ou affirment que Google-Extended explore vos pages. Ce n’est pas le cas. Google-Extended n’a pas de user agent propre ; c’est seulement un jeton robots.txt.
Cette liste se distingue sur deux points. Chaque user agent ci-dessous est vérifié dans la documentation de l’opérateur, au 20 novembre 2026. Et nous avons mesuré comment de vrais sites traitent ces bots : nous avons récupéré le robots.txt de 3 000 sites tirés au hasard dans le registre d’Online Web Directory et compté quels crawlers IA ils nomment et bloquent. Vous trouverez aussi des règles testées pour robots.txt, Nginx et Apache, ainsi qu’un script qui vérifie si un visiteur « GPTBot » vient vraiment d’OpenAI.
Qu’est-ce qu’une liste de crawlers IA ? Une liste de crawlers IA est un référentiel des bots que les entreprises d’IA utilisent pour récupérer des pages web, avec pour chaque bot son jeton robots.txt, sa chaîne user agent et sa fonction : collecter des données d’entraînement, indexer des pages pour la recherche IA ou récupérer une page en direct parce qu’un utilisateur l’a demandée. Elle sert à écrire des règles robots.txt, lire les journaux serveur et définir des règles de pare-feu.
Les crawlers IA en bref
| Question | Réponse courte |
|---|---|
| Combien de crawlers IA comptent ? | Environ 20 user agents documentés de 9 opérateurs (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), plus DuckDuckGo et une longue traîne de petits bots. |
| Types principaux | Crawlers d’entraînement, crawlers de recherche IA et agents ou fetchers déclenchés par l’utilisateur. Google-Extended et Applebot-Extended sont des jetons de contrôle, pas des crawlers. |
| Respectent-ils robots.txt ? | Les crawlers d’entraînement et de recherche documentés disent que oui. Les fetchers déclenchés par l’utilisateur (ChatGPT-User, Perplexity-User, les fetchers déclenchés par l’utilisateur de Google, Meta-ExternalFetcher) disent que robots.txt peut ne pas s’appliquer. |
| robots.txt peut-il renvoyer une erreur 403 ? | Non. robots.txt est une demande, pas un verrou. Une 403 vient de votre serveur, de votre CDN ou de votre pare-feu. |
| À quelle fréquence les sites les bloquent-ils ? | Dans notre échantillon du 20 nov. 2026, 16,9 % des fichiers robots.txt bloquent entièrement GPTBot, mais seulement 2,8 % bloquent entièrement OAI-SearchBot. |
| Comment vérifier un bot ? | Comparez l’IP de la requête à la liste d’IP publiée par l’opérateur (par exemple https://openai.com/gptbot.json). Un user agent se falsifie très facilement. |
La liste des crawlers IA (vérifiée en novembre 2026)
Le tableau indique chaque jeton robots.txt, qui l’exploite, ce qu’il fait selon l’opérateur et si l’opérateur affirme qu’il respecte robots.txt. La colonne « Type » utilise trois catégories : entraînement (collecte du contenu qui peut entraîner des modèles), recherche (indexe des pages pour qu’un produit d’IA puisse les citer plus tard) et utilisateur (récupère une page en temps réel parce qu’une personne l’a demandée). Nous avons écarté les bots dont l’opérateur ne publie aucune documentation vérifiable.
| Jeton robots.txt | Opérateur | Type | Rôle | Respecte robots.txt ? |
|---|---|---|---|---|
GPTBot |
OpenAI | Entraînement | Explore du contenu pouvant servir à entraîner les modèles de fondation d’OpenAI. | Oui |
OAI-SearchBot |
OpenAI | Recherche | Indexe des pages pour qu’elles puissent apparaître dans les résultats de recherche de ChatGPT. | Oui |
ChatGPT-User |
OpenAI | Utilisateur | Visite une page quand un utilisateur de ChatGPT ou d’un Custom GPT pose une question. | « Peut ne pas s’appliquer » |
OAI-AdsBot |
OpenAI | Contrôle des annonces | Contrôle les pages de destination soumises comme annonces ChatGPT ; pas utilisé pour l’entraînement. | Visite seulement les pages soumises |
ClaudeBot |
Anthropic | Entraînement | Collecte du contenu web pouvant contribuer à l’entraînement des modèles Claude. | Oui, et respecte Crawl-delay |
Claude-SearchBot |
Anthropic | Recherche | Indexe du contenu pour améliorer les résultats de recherche de Claude. | Oui |
Claude-User |
Anthropic | Utilisateur | Récupère des pages quand un utilisateur de Claude pose une question. | Oui, selon Anthropic |
Google-Extended |
Jeton de contrôle | Détermine si le contenu exploré par Google peut entraîner Gemini ou ancrer ses réponses. Pas de crawler distinct. | Jeton seulement | |
Google-CloudVertexBot |
Demandé par le propriétaire | Explore les sites dont les propriétaires créent des Vertex AI Agents ; aucun effet sur la recherche Google. | Oui | |
Google-Agent |
Utilisateur | Agents hébergés chez Google qui naviguent et agissent à la demande d’un utilisateur. | Déclenché par l’utilisateur : en général non | |
PerplexityBot |
Perplexity | Recherche | Indexe des pages pour les résultats de recherche de Perplexity ; pas utilisé pour l’entraînement. | Oui |
Perplexity-User |
Perplexity | Utilisateur | Récupère une page pendant la session Perplexity d’un utilisateur. | « L’ignore en général » |
Applebot-Extended |
Apple | Jeton de contrôle | Détermine si les pages explorées par Applebot peuvent entraîner les modèles de fondation d’Apple. N’explore rien. | Jeton seulement |
meta-externalagent |
Meta | Entraînement | Explore pour des usages comme l’entraînement de modèles d’IA ou l’indexation de contenu. | Oui |
meta-externalfetcher |
Meta | Utilisateur | Récupère des liens précis à la demande d’un utilisateur, y compris pour des tâches d’agent. | « Peut le contourner » |
Amazonbot |
Amazon | Entraînement | Améliore les produits et services d’Amazon ; peut servir à entraîner les modèles d’IA d’Amazon. | Oui |
Amzn-SearchBot |
Amazon | Recherche | Indexe des pages pour des expériences de recherche comme Alexa ; pas utilisé pour l’entraînement. | Oui |
Amzn-User |
Amazon | Utilisateur | Récupère des informations en direct pour répondre à un utilisateur, par exemple une requête Alexa. | « Peut ne pas tout suivre » |
CCBot |
Common Crawl | Données d’entraînement | Construit l’archive web ouverte de Common Crawl, source fréquente de données d’entraînement pour l’IA. | Oui |
MistralAI-Training |
Mistral AI | Entraînement | Explore du contenu pour constituer des jeux de données d’entraînement des modèles Mistral. | Oui |
MistralAI-Index |
Mistral AI | Recherche | Indexe du contenu pour la recherche Mistral ; pas utilisé pour l’entraînement. | Oui |
MistralAI-User |
Mistral AI | Utilisateur | Visite une page quand un utilisateur pose une question à Vibe, l’assistant de Mistral. | Oui, pour les requêtes utilisateur |
DuckAssistBot |
DuckDuckGo | Recherche | Explore des pages en temps réel pour les réponses assistées par IA de DuckDuckGo. | Oui (effectif après 72 heures) |
Les sources de chaque ligne sont en lien à la fin de l’article. Les citations de la dernière colonne viennent directement de la documentation de l’opérateur. Bytespider (ByteDance) manque volontairement : nous n’avons trouvé aucune page de ByteDance qui le documente, alors que 18,5 % des fichiers robots.txt de notre échantillon le nomment. Pour la même raison, nous ne décrivons pas la longue traîne de jetons comme cohere-ai, Diffbot ou omgili ; leur fréquence figure dans la partie données.
Les chaînes user agent complètes que vous verrez dans vos journaux
robots.txt fonctionne avec le jeton court, mais vos journaux d’accès affichent la chaîne complète. Voici les exemples publiés par les opérateurs. Les numéros de version changent : filtrez sur le jeton, pas sur la chaîne entière.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
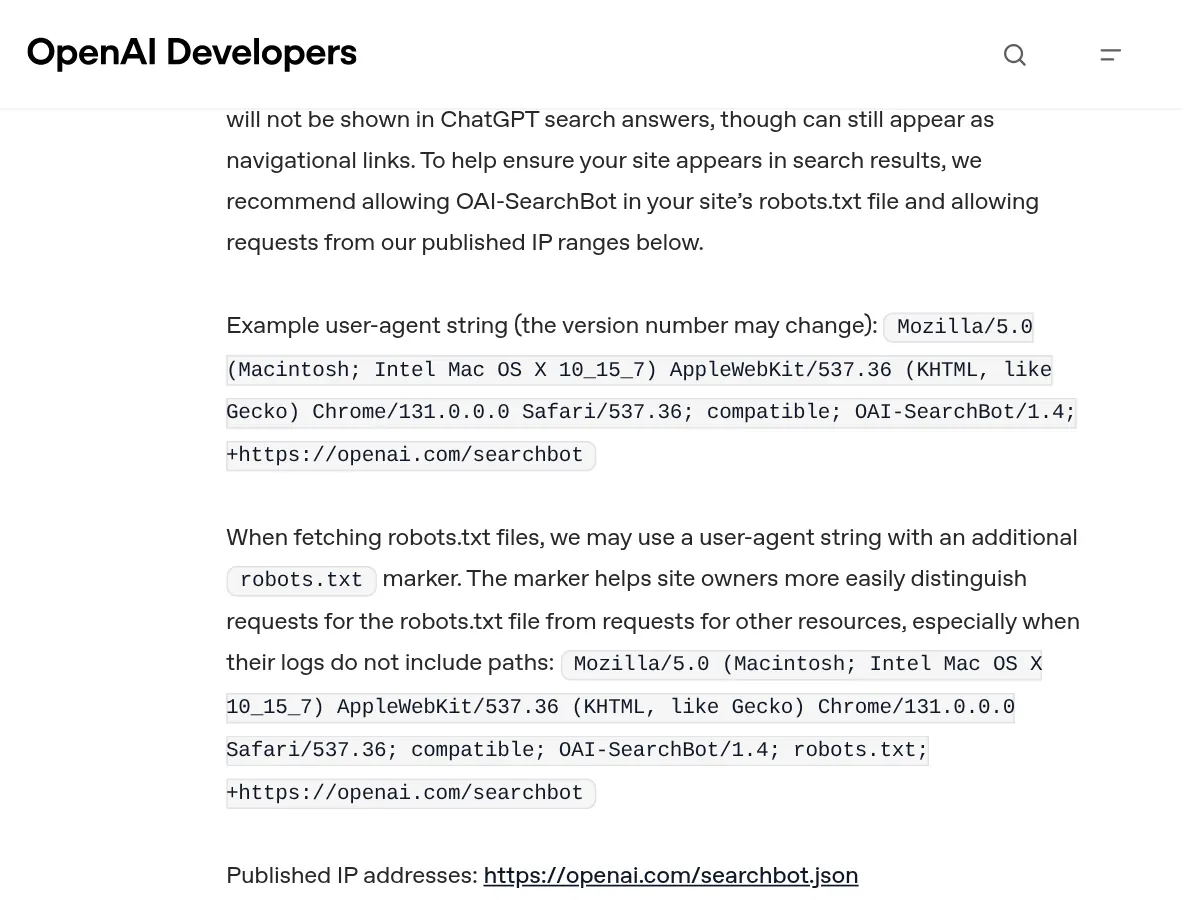
OpenAI précise aussi que GPTBot et OAI-SearchBot peuvent ajouter un marqueur robots.txt au user agent lorsqu’ils récupèrent votre robots.txt, pour que vous distinguiez ces requêtes dans des journaux sans chemins.
Trois types de crawlers IA, et pourquoi la différence compte
Bloquer les « bots IA » en un seul groupe est l’erreur la plus fréquente que nous voyons. Les trois types n’ont ni les mêmes coûts ni les mêmes avantages, et les opérateurs traitent robots.txt différemment pour chacun.
Crawlers d’entraînement
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot et MistralAI-Training collectent des pages qui peuvent finir dans des données d’entraînement. Les bloquer ne vous retire pas des résultats de recherche IA de la même entreprise : OpenAI indique que chacun de ses réglages robots.txt est indépendant, vous pouvez donc bloquer GPTBot tout en autorisant OAI-SearchBot. Dans notre échantillon, les crawlers d’entraînement sont le groupe le plus bloqué. 17,3 % des fichiers robots.txt bloquent entièrement CCBot, 16,9 % GPTBot et 15,9 % ClaudeBot.
Crawlers de recherche IA
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index et DuckAssistBot indexent des pages pour qu’un assistant puisse les trouver et les citer plus tard. Les bloquer peut vous exclure de ces réponses. Les propriétaires semblent le savoir : seuls 2,8 % des fichiers bloquent entièrement OAI-SearchBot et 5,8 % PerplexityBot, contre 16,9 % pour GPTBot.
Fetchers et agents déclenchés par l’utilisateur
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User et Google-Agent agissent pour une seule personne à la fois, comme un navigateur. Plusieurs opérateurs disent que robots.txt peut ne pas s’appliquer, car un humain a demandé la page. Ce sont aussi les bots qu’utilisent les agents d’achat et de réservation : les bloquer peut faire fuir de vrais clients. 5,9 % des fichiers de notre échantillon bloquent entièrement ChatGPT-User.
Des jetons de contrôle qui n’explorent rien
Google-Extended et Applebot-Extended ne visitent jamais votre site. Google et Apple explorent comme d’habitude avec Googlebot et Applebot, puis consultent ces jetons pour décider si le contenu peut entraîner leurs modèles. Selon Google, bloquer Google-Extended n’a aucun effet sur l’inclusion ni sur le classement dans la recherche Google. 14,1 % des fichiers analysés bloquent entièrement Google-Extended et 13,5 % Applebot-Extended. Google a aussi annoncé vouloir prendre en charge le signal commun d’entraînement IA (user-agent: __usage_ai-training) début 2027 ; nous l’expliquons dans notre guide sur l’opt-out de l’entraînement IA dans robots.txt.
D’anciens jetons qui remplissent encore les robots.txt
La page d’aide actuelle d’Anthropic ne cite que ClaudeBot, Claude-User et Claude-SearchBot. Pourtant, 15,6 % des fichiers analysés nomment encore anthropic-ai et 13,8 % Claude-Web. Des règles pour ces noms ne font pas de mal, mais si ce sont vos seules règles pour Anthropic, elles risquent de ne pas couvrir les bots qu’Anthropic documente aujourd’hui. Vérifiez que ClaudeBot est nommé explicitement.
À quoi ressemble l’accès des crawlers IA en pratique
La documentation des opérateurs fait foi pour les user agents. La page d’OpenAI, par exemple, liste chaque bot avec un exemple de chaîne user agent, des notes sur le marqueur robots.txt et un lien vers son fichier d’IP publié.
Ce qu’un site fait réellement de ces bots est une autre affaire. Nous avons demandé six pages d’accueil depuis notre serveur avec un user agent Chrome, le user agent GPTBot d’OpenAI et un user agent ClaudeBot. Notre serveur utilise une IP de centre de données, que beaucoup de protections anti-bots regardent avec méfiance ; depuis une connexion domestique, les résultats peuvent différer.
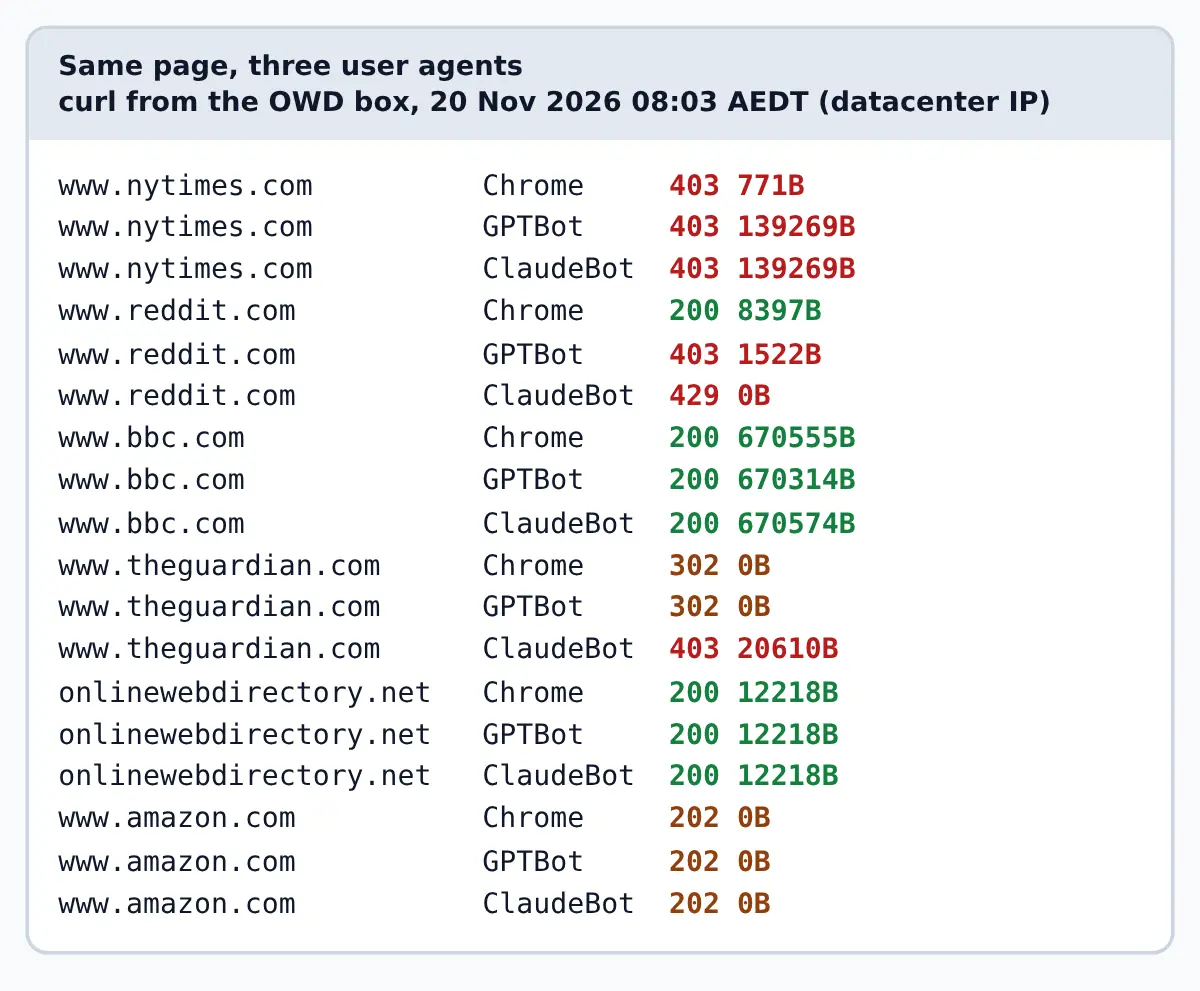
Trois cas de figure apparaissent. Reddit a servi Chrome mais a renvoyé 403 à GPTBot et 429 à ClaudeBot : un filtrage par user agent sur le serveur ou le CDN. Le New York Times a renvoyé 403 aux trois, ce qui suggère un blocage fondé sur notre IP ou l’empreinte de la requête, pas sur le user agent. Et bbc.com a renvoyé 200 à GPTBot alors que son robots.txt bloque GPTBot, ClaudeBot, CCBot, PerplexityBot et au moins cinq autres jetons IA. C’est la preuve la plus nette que robots.txt demande sans imposer. Amazon a répondu aux trois par un 202 au corps vide, une page de vérification intermédiaire plutôt qu’une vraie page.
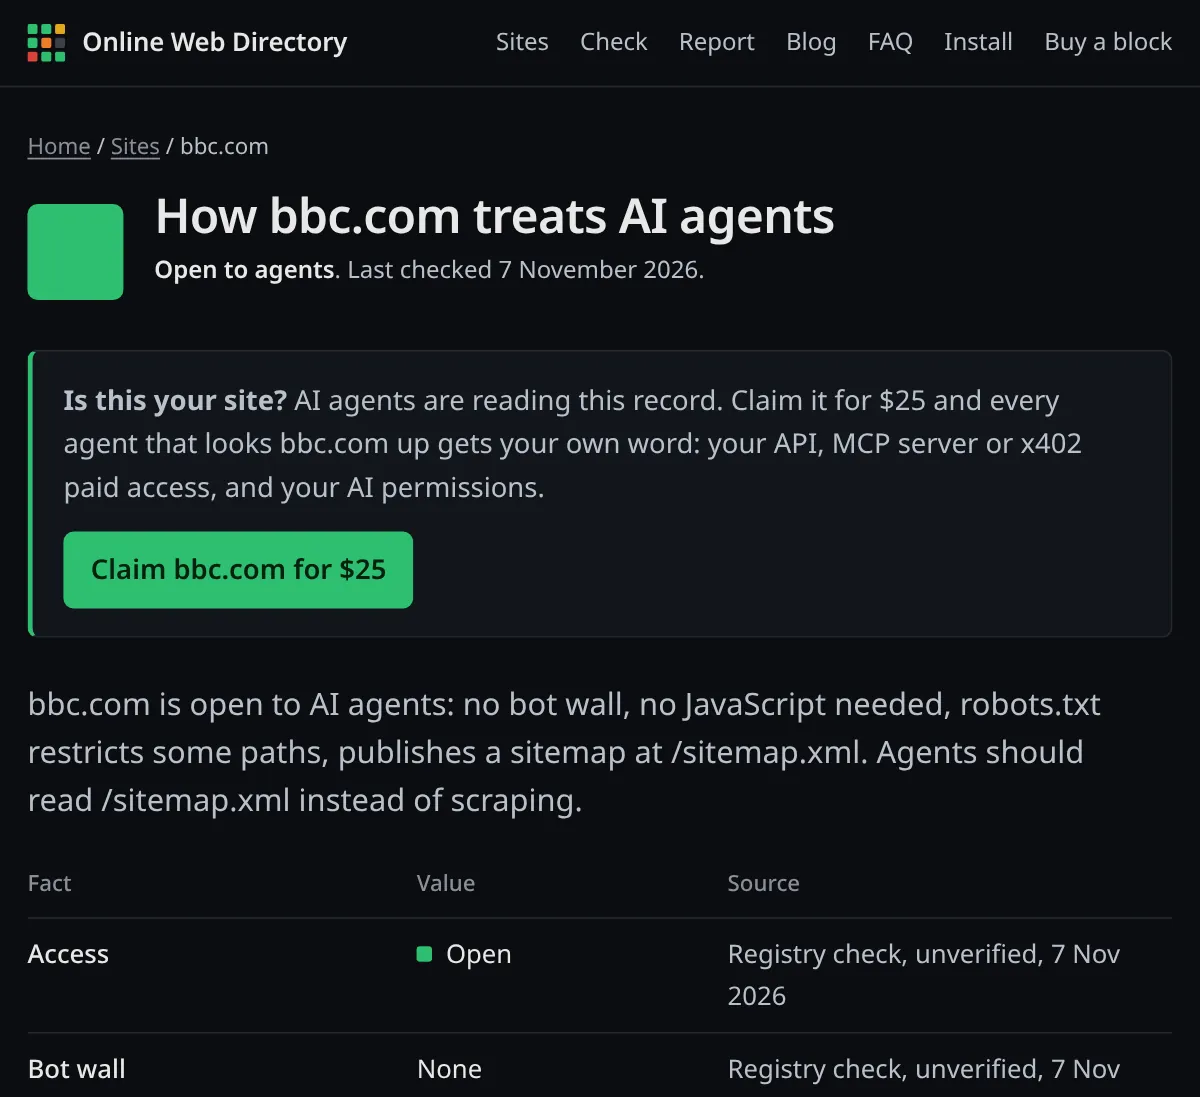
La fiche de chaque site dans Online Web Directory sépare ces deux couches : si les agents peuvent atteindre le site, et ce que dit son robots.txt.
Comment vérifier quels crawlers IA peuvent atteindre votre site
1. Lisez les groupes de votre robots.txt pour les jetons IA
Commencez par ce que vous demandez aux crawlers. Cette commande affiche chaque groupe qui nomme un jeton IA courant, avec la ligne suivante :
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Sortie réelle pour bbc.com le 20 novembre 2026 à 08:09 AEDT (réduite à quatre des neuf groupes) :
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Rappelez-vous qu’un crawler n’obéit qu’au groupe le plus spécifique correspondant à son jeton. Si vous nommez GPTBot dans son propre groupe, il ignore entièrement vos règles User-agent: * ; répétez donc les règles communes dans le groupe GPTBot.
2. Testez la réponse de votre serveur aux user agents IA
robots.txt peut dire « non » pendant que votre serveur dit encore « oui », ou l’inverse. Demandez la même page avec différents user agents et comparez les codes de statut :
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Remplacez l’URL par la vôtre. Un 403 ou un 429 pour GPTBot seul signale un filtrage par user agent. Un 403 pour les deux signale en général la réputation de l’IP ou un défi anti-bots. Testez depuis une connexion domestique et depuis un serveur : les vrais crawlers viennent d’IP de centres de données, le résultat serveur est donc plus proche de ce qu’ils voient.
3. Repérez les crawlers IA dans vos journaux d’accès
Comptez les requêtes par bot, puis vérifiez quels codes de statut chaque bot a reçus. Nous avons lancé ces commandes sur le journal d’accès d’un serveur Nginx de test le 20 novembre 2026 :
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
La seconde commande fonctionne avec le format de journal standard « combined », où le code de statut suit la ligne de requête entre guillemets. Un 200 pour GPTBot sur /robots.txt et un 403 partout ailleurs, c’est exactement ce que vous voulez quand vous bloquez les crawlers d’entraînement sur le serveur.
4. Vérifiez qu’un visiteur « GPTBot » vient vraiment d’OpenAI
N’importe qui peut envoyer un user agent GPTBot. OpenAI, Perplexity, DuckDuckGo, Mistral et Google publient des listes d’IP : vérifiez donc l’IP source. Ce script teste une IP avec les trois fichiers d’OpenAI :
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Sortie du 20 novembre 2026 à 08:12 AEDT :
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
Au moment de notre test, le fichier gptbot.json d’OpenAI contenait 18 plages IPv4, avec une date de création au 22 septembre 2026. Récupérez les fichiers à chaque fois au lieu de les figer dans votre code.
5. Cherchez votre site dans le registre
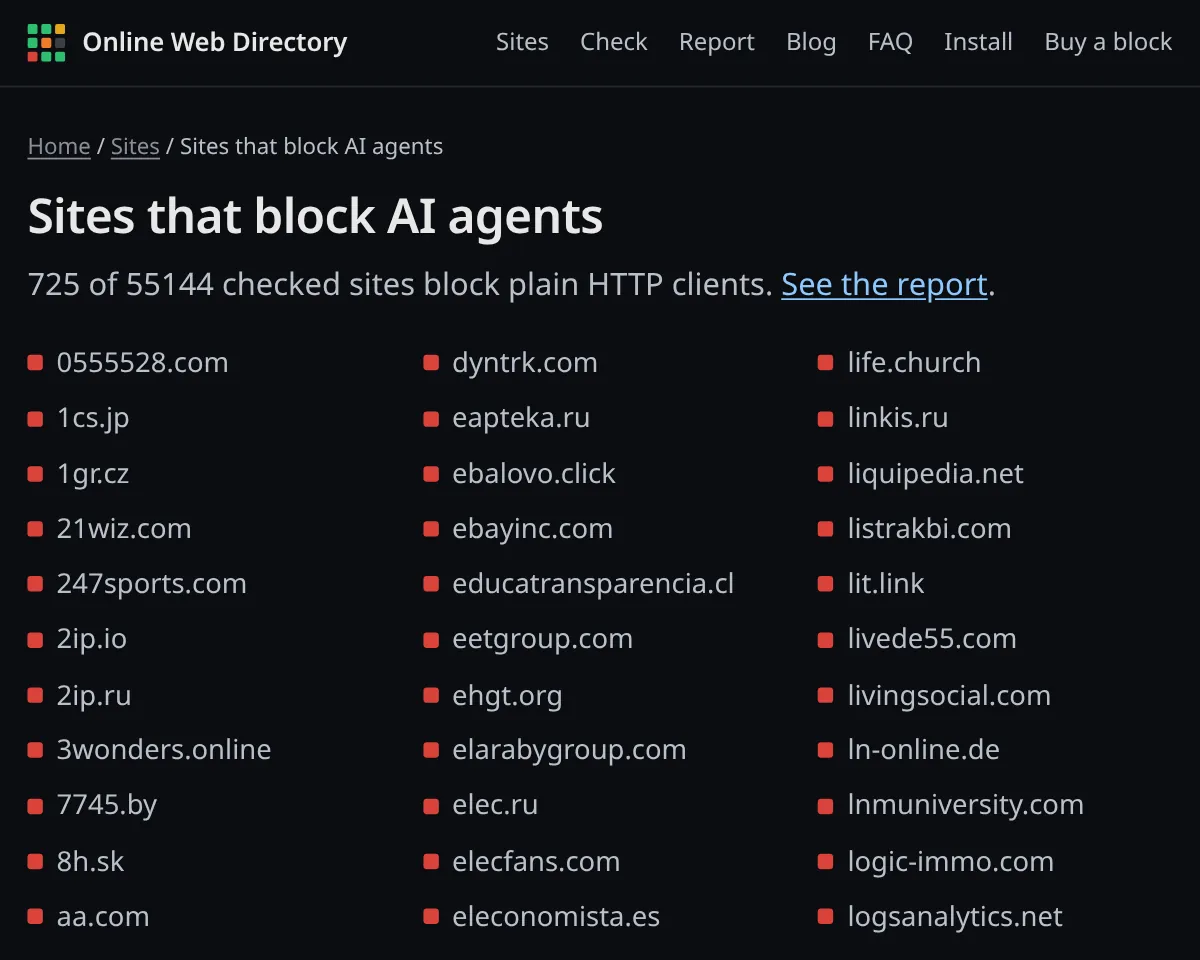
Online Web Directory vérifie comment les sites répondent aux clients HTTP simples et ce que dit leur robots.txt. Cherchez votre domaine, par exemple reddit.com ou nytimes.com, ou lancez le test de préparation gratuit. La liste des sites qui bloquent les agents IA montre quels domaines refusent les clients simples.
Contrôler les crawlers IA : six méthodes
Choisissez selon votre objectif. La plupart des sites veulent garder le trafic de la recherche IA, décider au cas par cas pour l’entraînement et laisser tranquilles les agents déclenchés par l’utilisateur.
Méthode 1 : bloquer les crawlers d’entraînement, garder la recherche IA (robots.txt)
C’est la politique la plus courante parmi les sites de notre échantillon. Ajoutez ceci au fichier /robots.txt à la racine de chaque hôte que vous servez :
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Nous avons testé ce fichier avec Protego, un analyseur conforme à la RFC 9309. Résultats pour le chemin /blog/ :
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Empiler plusieurs lignes User-agent au-dessus d’un même bloc de règles est valide selon la RFC 9309. Notez que le groupe de recherche IA n’hérite pas de la règle /wp-admin/ du groupe * ; ajoutez-la aussi si vous en avez besoin.
Méthode 2 : bloquer tous les crawlers IA documentés (robots.txt)
Si vous ne voulez aucun usage par l’IA, ajoutez les jetons de recherche et d’utilisateur au groupe bloqué : OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User et DuckAssistBot. Attendez-vous à disparaître des réponses IA. Et souvenez-vous que plusieurs fetchers déclenchés par l’utilisateur disent que robots.txt peut ne pas s’appliquer à eux : c’est une préférence affichée, pas un mur.
Méthode 3 : imposer le blocage dans Nginx
Pour refuser réellement les requêtes, filtrez sur le serveur. Cette configuration renvoie 403 aux crawlers d’entraînement sur tous les chemins sauf robots.txt, pour qu’ils puissent encore lire vos règles. Le bloc map se place dans le contexte http :
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Testée avec Nginx 1.26.3 le 20 novembre 2026 : nginx -t a réussi, GPTBot a reçu 403 sur / et 200 sur /robots.txt, tandis que Chrome et OAI-SearchBot ont reçu 200 sur les deux. Un simple return dans un if fait partie des usages que Nginx documente comme sûrs.
Méthode 4 : imposer le blocage dans Apache (.htaccess)
La même règle pour Apache avec mod_rewrite :
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Testé sur Apache 2.4.71 avec AllowOverride All : GPTBot a reçu 403 sur la page d’accueil et 200 sur robots.txt ; Chrome et OAI-SearchBot ont reçu 200. Le drapeau [F] renvoie 403 Forbidden.
Méthode 5 : utiliser les règles de crawlers IA de votre CDN
Sur Cloudflare, inutile de tenir une liste. Dans Security, Settings, filtrez sur « Bot traffic » et ouvrez AI Crawler and Agent access policies. Cloudflare permet de régler séparément les actions pour le trafic Search, Agent et Training. Sa documentation indique que les nouveaux domaines sont réglés par défaut sur « Allow (do not block) » pour les trois, et que « Disallow » pour Training ne modifie que robots.txt tant que Bot Preference Sync n’est pas activé. Le tableau de bord AI Crawl Control de Cloudflare montre aussi quels crawlers passent et s’ils respectent votre robots.txt. Sur les 62 088 sites de notre registre, 6 966 (11,2 %) ont présenté un défi Cloudflare à notre outil de vérification.
Méthode 6 : vérifier, puis autoriser
Les règles par user agent bloquent les bots honnêtes et laissent passer les malhonnêtes. Si vous bloquez en bordure, associez la règle à une vérification d’IP (voir l’étape 4) et laissez passer les agents de recherche et d’utilisateur vérifiés. Anthropic prévient que bloquer ses adresses IP peut ne pas fonctionner de façon fiable comme opt-out, car cela empêche ClaudeBot de lire votre robots.txt. Utilisez robots.txt pour la politique et les vérifications d’IP pour repérer les imposteurs.
Ce que 2 124 fichiers robots.txt disent des crawlers IA
Le 20 novembre 2026, entre 08:01 et 08:03 AEDT, nous avons tiré au hasard 3 000 hôtes parmi les 62 088 sites du jeu de données ouvert d’Online Web Directory et récupéré /robots.txt depuis notre serveur. 2 124 ont renvoyé un fichier exploitable. Un jeton est « nommé » s’il a sa propre ligne User-agent, et « entièrement bloqué » si ce groupe contient Disallow: / sans Allow: /.
| Jeton robots.txt | Nommé | Entièrement bloqué |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (ancien) |
15.6% | 13.3% |
Claude-Web (ancien) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Quatre constats ressortent :
- La plupart des sites ne mentionnent pas du tout les crawlers IA. 629 fichiers sur 2 124 (29,6 %) nomment au moins un jeton propre à l’IA. Ceux qui le font en nomment souvent beaucoup : la médiane est de 12 jetons, et 357 fichiers en nomment 10 ou plus, signe de listes de blocage copiées.
- L’entraînement est bloqué, la recherche non. GPTBot est entièrement bloqué six fois plus souvent qu’OAI-SearchBot (16,9 % contre 2,8 %).
- robots.txt et accès réel ne concordent pas. Sur les 358 sites qui bloquent entièrement GPTBot dans robots.txt, 284 (79 %) étaient « ouverts » lors du contrôle d’accès d’OWD : rien sur le serveur n’arrêtait un client simple.
- Les interdictions totales sont rares. Seuls 13 fichiers (0,6 %) interdisent tout à tous les user agents.
Le registre complet raconte la même histoire de l’autre côté. Voici les résultats d’accès des 62 088 sites, vérifiés pour la dernière fois entre le 11 octobre et le 19 novembre 2026 :
| Ce qu’a rencontré un client HTTP simple | Sites | Part |
|---|---|---|
| Ouvert | 50,844 | 81.9% |
| Défi anti-bots | 7,821 | 12.6% |
| Bloqué | 3,060 | 4.9% |
| Débit limité | 199 | 0.3% |
| Connexion requise | 150 | 0.2% |
| Paywall | 14 | 0.0% |
Téléchargez le jeu de données complet (CC BY 4.0) sur onlinewebdirectory.net/exports/sites.csv ou consultez le rapport sur l’accès des agents IA.
Erreurs et réponses associées
- 403 Forbidden. Votre serveur, CDN ou pare-feu a refusé la requête. Ce n’est jamais causé par robots.txt lui-même, et ce n’est pas permanent : changez la règle et la requête suivante peut aboutir.
- 429 Too Many Requests. Limitation de débit. Reddit a renvoyé ce code à notre requête ClaudeBot. Anthropic prend en charge
Crawl-delay, une solution plus douce pour ClaudeBot. - 202 au corps vide, ou page de défi 503. En général un défi JavaScript ou CAPTCHA. Les crawlers ne peuvent pas le résoudre : pour eux, la page est bloquée même sans 403.
- robots.txt renvoie un 4xx. Selon la RFC 9309, une réponse entre 400 et 499 signifie que le fichier est « indisponible » et que les crawlers peuvent tout explorer. Dans notre échantillon, 314 sites sur 3 000 (10,5 %) ont répondu 403 à notre demande de robots.txt, ce qu’un crawler conforme lirait comme une absence de règles.
- robots.txt renvoie un 5xx ou ne répond pas. La RFC 9309 impose alors aux crawlers de supposer une interdiction totale : une panne de robots.txt peut donc bloquer en silence tous les crawlers, Googlebot compris.
- robots.txt de plus de 500 Kio. La RFC 9309 n’oblige les crawlers qu’à analyser les 500 premiers Kio : les règles au-delà peuvent être ignorées.
Si vous publiez un fichier llms.txt pour les agents IA, assurez-vous que les bots autorisés peuvent vraiment le récupérer. Notre guide llms.txt explique comment le tester.
Résumé
Une liste fiable de crawlers IA part de la documentation des opérateurs, pas d’autres listes. Aujourd’hui, cela représente environ 20 user agents de 9 entreprises, en trois types : crawlers d’entraînement, crawlers de recherche IA et agents déclenchés par l’utilisateur, plus deux jetons de contrôle (Google-Extended et Applebot-Extended) qui n’explorent jamais. La plupart des sites qui agissent bloquent l’entraînement et gardent la recherche, et robots.txt n’est qu’une demande : si vous avez besoin d’un vrai blocage, imposez-le sur le serveur ou le CDN et vérifiez les IP.
Les agents IA consultent déjà les sites dans Online Web Directory avant de les visiter. Si la fiche de votre site est fausse, ou si vous voulez que les agents connaissent votre API, votre serveur MCP ou vos autorisations IA, revendiquez votre site pour 25 $. Vous pouvez d’abord lancer le test de préparation gratuit.
Questions fréquentes
Quel est le user agent de ChatGPT ?
ChatGPT en utilise trois. GPTBot collecte des données d’entraînement, OAI-SearchBot indexe des pages pour la recherche ChatGPT et ChatGPT-User récupère une page quand un utilisateur la demande. Leurs jetons robots.txt sont GPTBot, OAI-SearchBot et ChatGPT-User.
Bloquer GPTBot retire-t-il mon site de la recherche ChatGPT ?
Non. OpenAI pilote la recherche via OAI-SearchBot. Vous pouvez bloquer GPTBot pour refuser l’entraînement et autoriser OAI-SearchBot pour que vos pages apparaissent et soient citées dans la recherche ChatGPT.
Google-Extended est-il un crawler ?
Non. Google indique que Google-Extended n’a pas de user agent distinct. C’est Googlebot qui explore, et le jeton Google-Extended contrôle seulement si ce contenu peut servir à entraîner et ancrer Gemini. Il n’a aucun effet sur le classement dans la recherche Google.
Les crawlers IA respectent-ils robots.txt ?
Les crawlers d’entraînement et de recherche documentés dans cette liste disent que oui. Les fetchers déclenchés par l’utilisateur, comme ChatGPT-User, Perplexity-User et Meta-ExternalFetcher, disent que robots.txt peut ne pas s’appliquer, car une personne a demandé la page. Les scrapers non documentés peuvent l’ignorer complètement.
Comment savoir si un bot est vraiment GPTBot ou ClaudeBot ?
Vérifiez l’IP source. OpenAI publie ses plages dans gptbot.json, searchbot.json et chatgpt-user.json ; Perplexity, DuckDuckGo, Mistral et Google publient les leurs. Un user agent correspondant venant d’une IP non listée est un imposteur.
Sources
- OpenAI, Overview of OpenAI crawlers (consulté le 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers et user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies et AI Crawl Control
- Online Web Directory, jeu de données ouvert des sites (62 088 sites, exporté le 20 nov. 2026) et notre échantillon robots.txt de 3 000 hôtes