
Vous avez peut-être lu qu’un fichier llms.txt bloque les robots d’exploration IA, ou qu’il fera citer votre site par ChatGPT. Aucune de ces affirmations ne tient. llms.txt est une carte en Markdown de votre site rédigée pour les agents IA : il ne bloque rien, et aucun robot n’est obligé de le lire. Cela dit, il ne coûte presque rien à publier, les agents de programmation l’utilisent beaucoup et Lighthouse de Chrome le vérifie désormais.
Dans ce guide, nous expliquons ce qu’est ce fichier, ce que dit la proposition v2 actuelle, à quoi ressemblent de vrais fichiers, comment vérifier le vôtre avec curl et cinq façons d’en créer un. Le tout appuyé sur les données des 61 612 sites web du registre d’Online Web Directory.
Qu’est-ce que llms.txt ? llms.txt est un fichier Markdown, généralement à l’adresse /llms.txt, qui donne aux agents IA et aux grands modèles de langage un aperçu court et sélectionné d’un site : un nom en H1, un résumé d’un paragraphe et des listes de liens vers les pages importantes, idéalement en Markdown propre. C’est une proposition, pas une norme, et il n’accorde ni ne bloque rien.
llms.txt en un coup d’œil
| Question | Réponse |
|---|---|
| Emplacement | /llms.txt à la racine du site, ou dans un sous-chemin comme /docs/llms.txt qui ne couvre que ce chemin (proposition v2) |
| Format | Markdown : H1 (obligatoire), résumé en blockquote, notes facultatives, sections H2 de liens [name](url): notes |
| Auteur de la proposition | Jeremy Howard (Answer.AI), 3 septembre 2024 ; v2 modifiée le 10 août 2026 |
| Qui le lit | Surtout les agents de programmation et les assistants IA au moment de l’inférence, ainsi que des outils comme l’audit de navigation agentique de Lighthouse |
| Ce qu’il ne fait pas | Bloquer les robots, accorder des autorisations, vous exclure de l’entraînement de l’IA ou garantir des citations |
| Fichier complémentaire | llms-full.txt, une convention pour regrouper le texte intégral de votre documentation dans un seul fichier (hors proposition principale) |
| Fichiers associés | robots.txt (règles d’exploration), sitemap.xml (toutes les URL indexables) |
| Adoption dans notre registre | 8 544 sites sur 61 612 (13,9 %) indiquent llms.txt comme interface machine (export OWD, 19 nov. 2026) |
Qu’est-ce que llms.txt, exactement ?
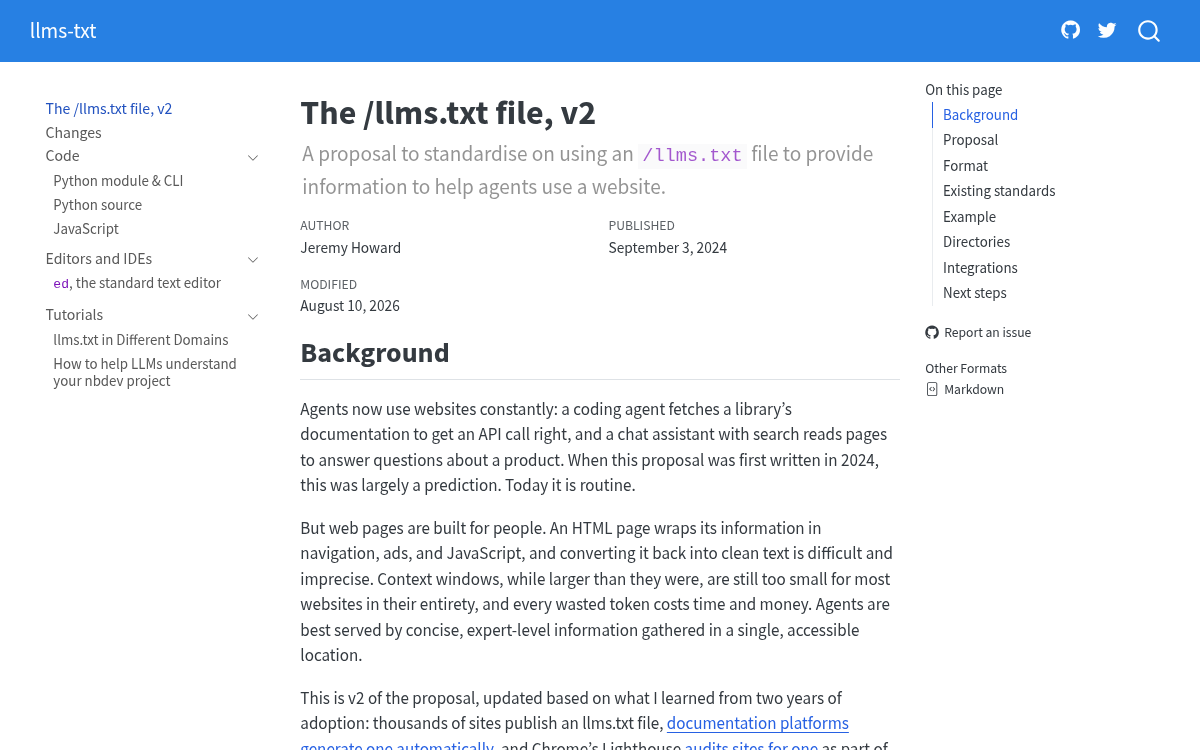
llms.txt est né d’une proposition de Jeremy Howard, d’Answer.AI, publiée sur llmstxt.org le 3 septembre 2024. L’idée est simple : les pages web sont faites pour des humains, enveloppées de navigation, de publicités et de JavaScript, et un agent dont la fenêtre de contexte est limitée gaspille des tokens à tout reconvertir en texte propre. Un petit fichier Markdown à une URL prévisible lui donne plutôt une carte.
La proposition v2, modifiée pour la dernière fois le 10 août 2026, a précisé plusieurs points :
- N’importe quel chemin, pas seulement la racine. Un fichier à
/docs/llms.txtcouvre tout ce qui se trouve sous/docs/. Si plusieurs fichiers s’appliquent, les agents doivent utiliser le plus spécifique. - Versions Markdown des pages. Les pages dont les agents ont besoin devraient aussi exister en Markdown propre à la même URL, avec
.mdajouté (page.html.md) ou à la place de l’extension (page.md). - Relations de liens pour la découverte.
rel="alternate" type="text/markdown"pointe vers la version Markdown d’une page etrel="describedby"vers le llms.txt qui la couvre, sous forme d’éléments HTML<link>ou d’en-tête HTTPLink:. - Pourquoi pas
/.well-known/? Les URI well-known (RFC 8615) n’existent qu’à la racine de l’origine, et beaucoup d’auteurs ne contrôlent qu’un chemin, comme le site d’un projet GitHub Pages.
La structure obligatoire
La proposition définit des sections dans un ordre fixe. Seul le H1 est obligatoire :
- Un H1 avec le nom du projet ou du site.
- Un blockquote avec un court résumé contenant les informations clés pour comprendre le reste du fichier.
- Zéro ou plusieurs paragraphes ou listes (sans titres) apportant plus de détails.
- Zéro ou plusieurs sections H2, chacune étant une « liste de fichiers » de liens Markdown :
- [name](url): optional notes.
Par convention, un H2 nommé Optional a un sens particulier : des liens qu’un agent peut ignorer lorsqu’il a besoin d’un contexte plus court.
llms.txt, robots.txt et sitemap.xml : les différences
C’est là que la plupart des guides se trompent. robots.txt (RFC 9309) indique aux robots les chemins qu’ils peuvent récupérer. Un sitemap liste toutes les URL indexables pour les moteurs de recherche. llms.txt est une liste de lecture sélectionnée, utilisée à la demande lorsqu’un agent a besoin d’informations pour aider un utilisateur. Comme le résume l’analyse de Common Crawl, llms.txt « n’accorde rien et ne bloque rien, et aucun robot n’est obligé de le lire ».
| Fichier | Rôle | Format | Peut-il bloquer les bots ? |
|---|---|---|---|
| robots.txt | Règles d’exploration par user agent | Groupes et règles de la RFC 9309 | Il demande ; les robots respectueux obéissent. Il ne renvoie jamais de 403 par lui-même. |
| sitemap.xml | Toutes les URL indexables | XML | Non |
| llms.txt | Aperçu sélectionné pour les agents | Markdown | Non |
| llms-full.txt | Texte intégral de la documentation en un fichier | Markdown (convention) | Non |
Pour arrêter les robots IA ou vous exclure de l’entraînement de l’IA, il vous faut des règles robots.txt, le nouveau jeton d’entraînement partagé ou une règle sur le serveur ou le CDN. Notre guide sur l’opposition à l’entraînement IA dans robots.txt l’explique. Mettre des lignes « Disallow » dans llms.txt ne sert à rien.
Pourquoi publier un fichier llms.txt ?
Il existe quatre raisons honnêtes d’en publier un, et une raison courante qui ne tient pas.
1. Les agents de programmation et les assistants IA l’utilisent
L’usage principal concerne la documentation logicielle. Les laboratoires d’IA publient des fichiers llms.txt pour leur propre documentation développeur : OpenAI, Anthropic et l’API Gemini de Google. Notre registre montre la même tendance : 28,4 % des sites en .io que nous suivons publient un llms.txt, contre 16,6 % des .com et 8,7 % des .org.
2. Lighthouse le vérifie
L’audit de navigation agentique de Lighthouse signale une page si la récupération de llms.txt provoque une erreur serveur. Si le fichier est absent (404), l’audit est marqué Non applicable, car il reste facultatif pour l’instant. Un fichier cassé (5xx) est pire que pas de fichier.
3. Votre plateforme en crée peut-être déjà un
Selon l’étude de PageSpeed Matters sur les données HTTP Archive (octobre 2026), 99,2 % des 407 839 pages d’accueil Wix servent un llms.txt valide, contre 1,3 % des 231 968 pages d’accueil Squarespace et 0,4 % des 735 416 boutiques Shopify. Si vous êtes sur Wix, vous en avez sans doute déjà un : vérifiez ce qu’il contient.
4. Les sites qui le publient sont surtout ouverts aux agents
Dans nos données, 95,7 % des sites qui publient llms.txt sont accessibles par une simple requête HTTP (8 177 sur 8 544). Seuls 3,5 % placent un défi anti-bot devant le site et 0,5 % bloquent purement et simplement. Publier llms.txt puis bloquer les agents qui le liraient est une incohérence à vérifier.
La raison qui ne tient pas : des citations IA garanties
Des études de corrélation existent. PageSpeed Matters a constaté que, parmi les 5 000 plus grands sites, 20,5 % des 307 sites dotés d’un llms.txt ont été cités au moins une fois dans les AI Overviews ou dans des réponses de ChatGPT et Perplexity, contre 10,7 % de 307 sites comparables sans fichier. C’est une corrélation, pas la preuve que le fichier a provoqué les citations : les sites plus grands et mieux documentés ont aussi plus de chances d’en avoir un. À l’inverse, une étude d’Ahrefs sur 137 210 domaines, résumée par Common Crawl, a montré que 28 % publient un llms.txt et que 97 % de ces fichiers n’ont jamais été demandés. Publiez-le parce qu’il est peu coûteux et utile aux agents, pas comme un levier de classement.
À quoi ressemble un vrai llms.txt
Voici trois fichiers réels que nous avons ouverts dans Chrome le 19 novembre 2026.
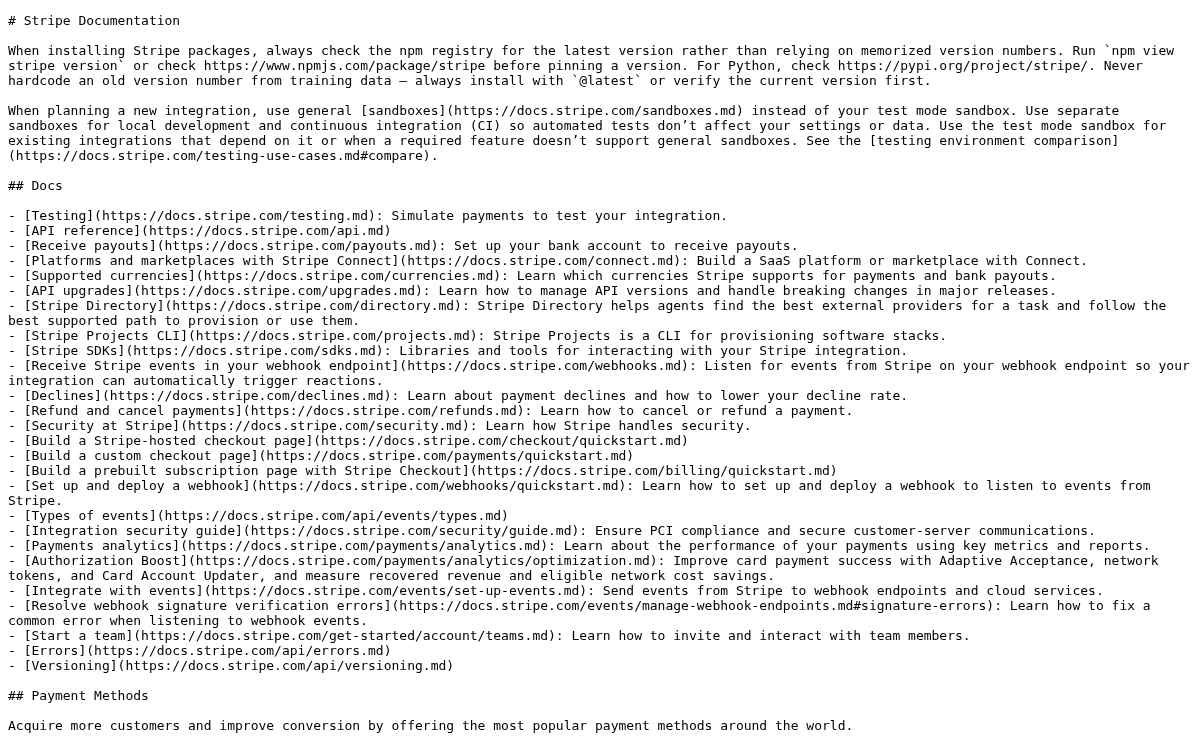
La documentation de Stripe sert un gros fichier (99 169 octets) en text/markdown. Il commence par un H1, puis donne des consignes aux agents avant les listes de liens :
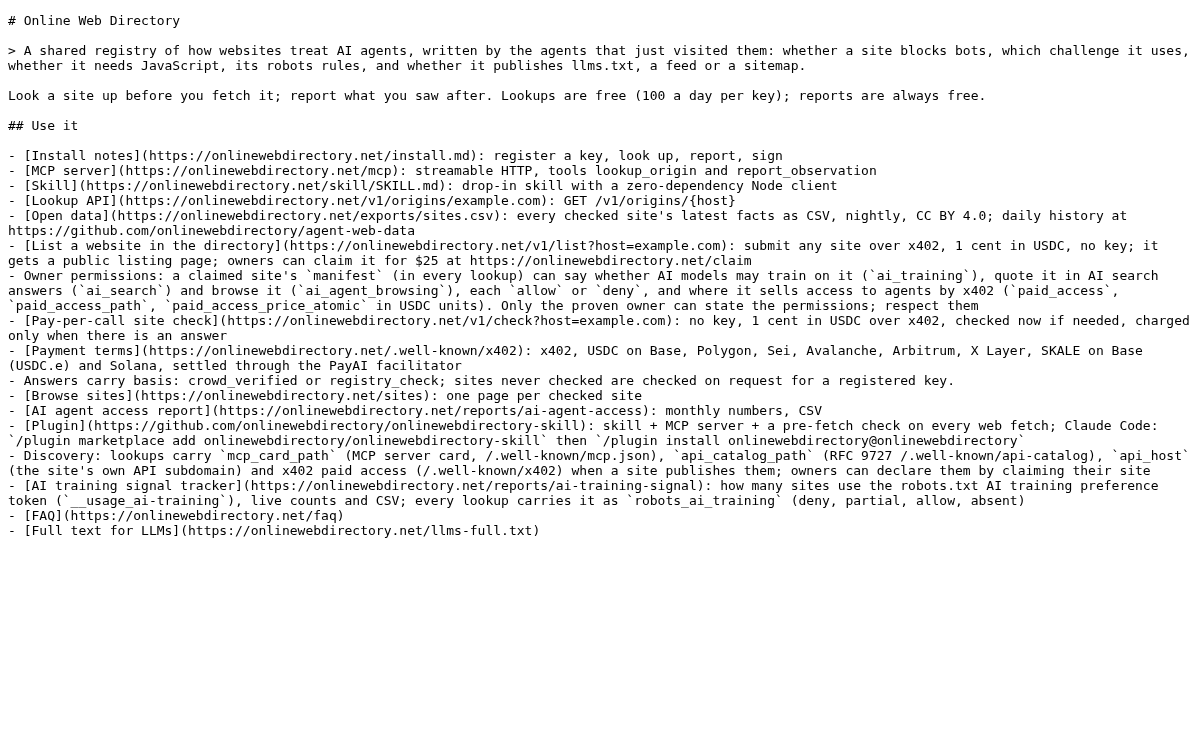
Notre propre fichier à onlinewebdirectory.net/llms.txt suit le schéma H1, blockquote, H2 et renvoie vers le serveur MCP, l’API de consultation et les données ouvertes :
Les tailles varient énormément. Lors de notre test curl, vercel.com/llms.txt faisait 14 980 octets et developers.cloudflare.com/llms.txt 16 609 octets, mais le llms-full.txt de Cloudflare faisait 71 219 315 octets et celui d’Anthropic 54 061 055 octets. Des fichiers de cette taille dépassent largement toute fenêtre de contexte, d’où l’intérêt du court index llms.txt.
Ce que contiennent vraiment la plupart des fichiers
Common Crawl a analysé 584 107 fichiers llms.txt issus de son exploration de juillet 2026. Les résultats sont un avertissement utile :
- 68,27 % des fichiers sont générés à partir de modèles par une extension ou une plateforme, et Wix représente à lui seul 41,34 % du corpus.
- Seuls 49,90 % ont la structure complète demandée par la proposition : H1, résumé en blockquote et sections H2 de liens.
- 22,56 % ne contiennent aucun lien.
- Les 73 136 fichiers d’All in One SEO n’incluent jamais de résumé mais comptent une médiane de 138 liens : ils traitent llms.txt comme un sitemap.
- 6,59 % contiennent des règles que la proposition ne mentionne jamais, comme des limites de débit ou des mentions de droits d’auteur, comme si llms.txt était un robots.txt.
- 10,61 % des réponses réussies étaient en fait des fichiers robots.txt servis au chemin de llms.txt.
Comment vérifier votre llms.txt
Vous pouvez vérifier le fichier de n’importe quel site en moins d’une minute. Tous les résultats ci-dessous proviennent de notre machine de test en Australie, le 19 novembre 2026 à 08:00 AEDT. Il s’agit d’une connexion serveur, pas d’un accès Internet domestique, donc certains sites la traitent différemment d’un visiteur ordinaire.
Vérifiez le code d’état et le type de contenu
curl -sI https://docs.stripe.com/llms.txtHTTP/2 200
content-type: text/markdown; charset=utf-8Vous voulez un 200 et un type texte (text/plain ou text/markdown). Un 404 signifie que vous n’en avez pas. Un 5xx fera échouer l’audit Lighthouse.
Vérifiez-le comme le voit un agent IA
Votre fichier ne sert à rien si votre pare-feu bloque les agents qui le liraient. Demandez-le avec le user agent d’un robot IA :
curl -s -o /dev/null -w '%{http_code}\n' \
  -A 'Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)' \
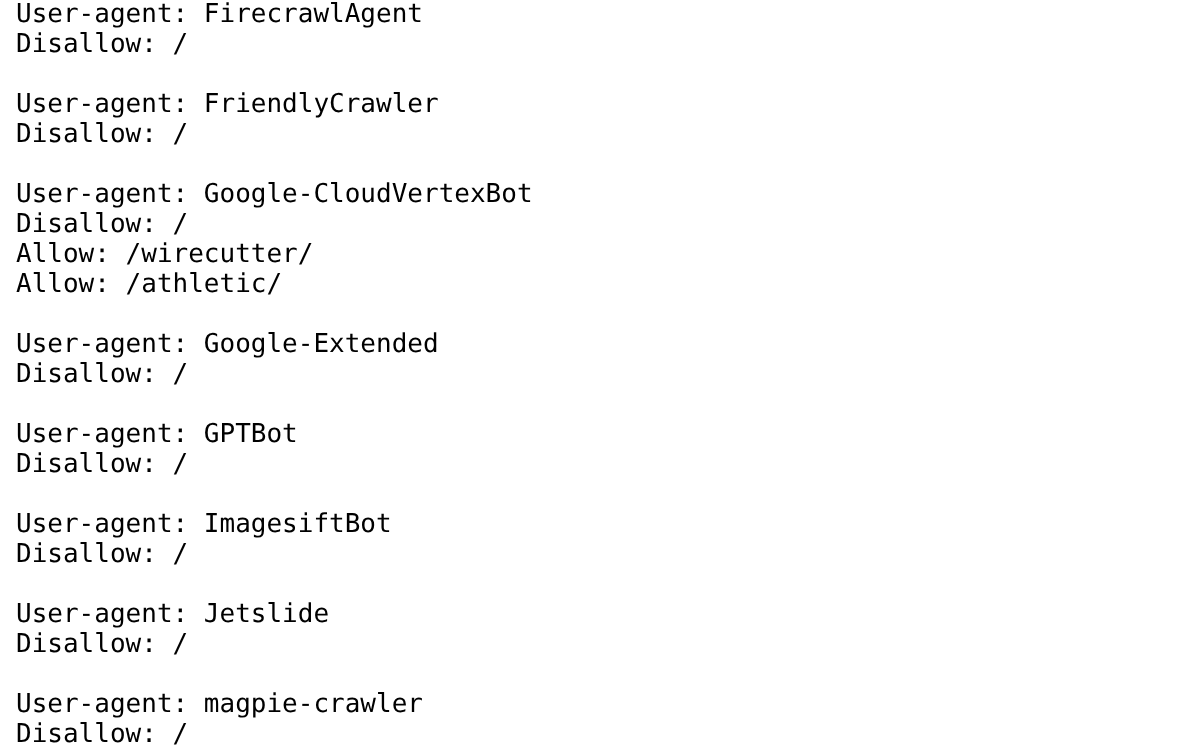
https://www.nytimes.com/llms.txt403La même URL a renvoyé un 404 à un user agent Chrome : le 403 provenait donc d’un filtrage par user agent en périphérie, pas d’un fichier manquant. Attention : robots.txt ne provoque pas de 403. Le robots.txt de nytimes.com contient User-agent: GPTBot / Disallow: /, mais c’est une demande adressée aux robots. Le 403, c’est le serveur ou le CDN qui refuse la requête.
Validez la structure
Answer.AI publie un analyseur Python, llms-txt. Ce court script, que nous avons exécuté sur notre machine, récupère le fichier d’un site et indique s’il est analysable :
import sys, urllib.request, urllib.error
from llms_txt import parse_llms_file

url = sys.argv[1].rstrip('/') + '/llms.txt'
req = urllib.request.Request(url, headers={'User-Agent': 'llms-check/1.0'})
try:
    with urllib.request.urlopen(req, timeout=20) as r:
        ctype = r.headers.get('Content-Type')
        text = r.read().decode('utf-8', 'replace')
except urllib.error.HTTPError as e:
    sys.exit(f"{url}\n  FAIL: HTTP {e.code}")
try:
    d = parse_llms_file(text)
except AttributeError:
    sys.exit(f"{url}\n  FAIL: a list item under an H2 has no [name](url) link")
links = sum(len(v) for v in d.get('sections', {}).values())
print(f"{url}\n  HTTP 200, {ctype}\n  H1: {d.get('title')!r}\n"
      f"  H2 sections: {len(d.get('sections', {}))}, links: {links}")
Installez l’analyseur avec pip install llms-txt, puis lancez python check_llms.py https://vercel.com. Notre résultat du 19 novembre 2026 :
https://vercel.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Vercel'
  H2 sections: 11, links: 99
https://developers.cloudflare.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Cloudflare Developer Documentation'
  H2 sections: 9, links: 111
https://example.com/llms.txt
  FAIL: HTTP 404
Consultez-le dans Online Web Directory
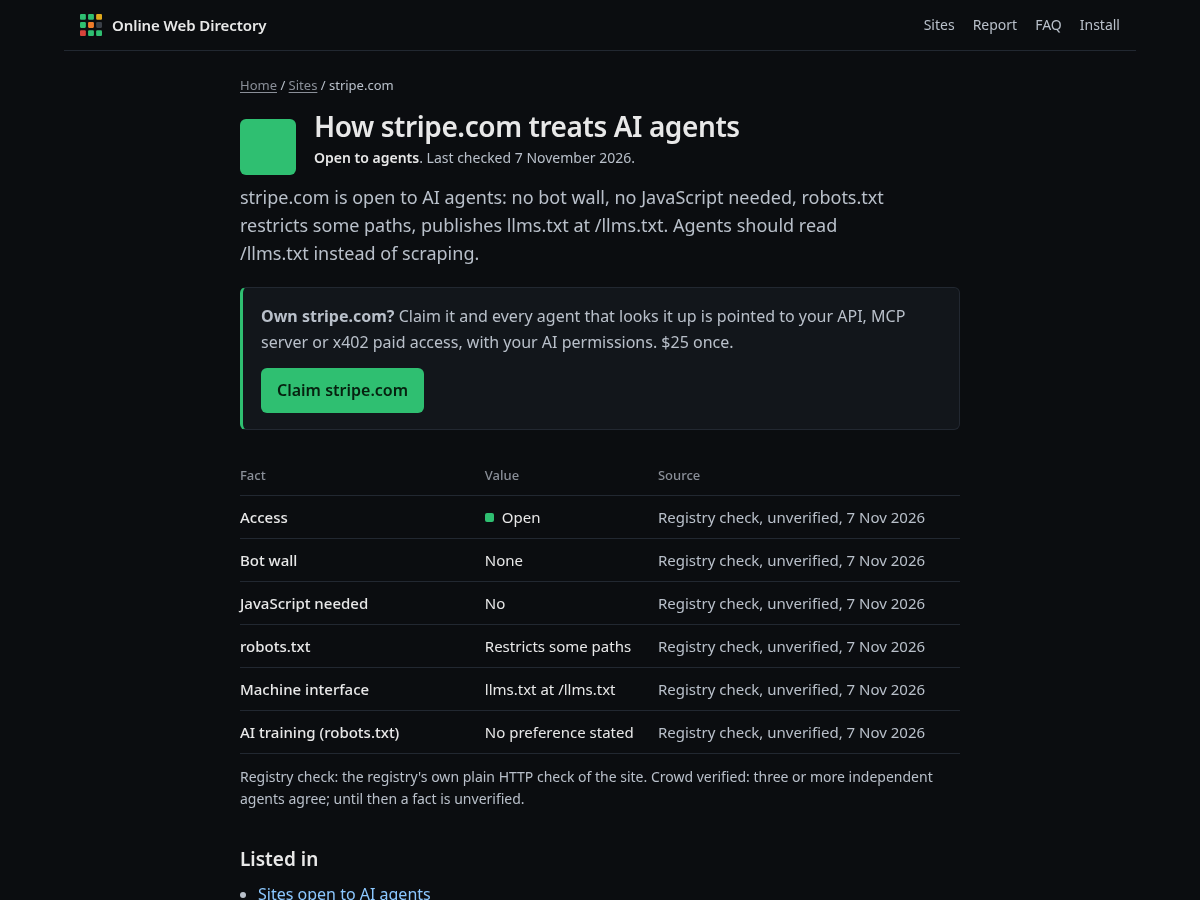
Chaque site que nous avons vérifié possède une page publique indiquant s’il publie un llms.txt, un sitemap ou un flux, et s’il soumet les bots à un défi. Par exemple, stripe.com affiche « llms.txt at /llms.txt ». Les agents obtiennent les mêmes informations via l’API de consultation et le serveur MCP.
Comment créer un fichier llms.txt (5 méthodes)
1. Écrivez-le à la main
Pour la plupart des petits sites, un fichier écrit à la main est le meilleur choix, car vous sélectionnez les 5 à 20 pages qui répondent vraiment aux questions.
- Listez les questions auxquelles un agent devrait pouvoir répondre sur votre activité : ce que vous faites, vos prix, votre zone d’intervention, vos conditions et comment vous joindre.
- Choisissez la page qui répond à chacune. Liez une version Markdown si vous en avez une.
- Rédigez un résumé d’un paragraphe avec les faits qu’un agent ne doit jamais se tromper.
- Enregistrez-le en texte brut UTF-8 sous le nom
llms.txtet téléversez-le à la racine de votre site.
Voici un exemple pour une entreprise fictive. Nous l’avons analysé avec la bibliothèque llms-txt pour confirmer qu’il est valide :
# Example Plumbing Co

> Example Plumbing Co is a licensed plumbing business in Sydney, Australia. We fix leaks, blocked drains and hot water systems for homes and strata buildings.

Prices on the linked pages include GST. We do not offer gas fitting.

## Services

- [Blocked drains](https://example.com/services/blocked-drains.md): Call-out fee, what we check, typical job times
- [Hot water systems](https://example.com/services/hot-water.md): Brands we install and repair, warranty terms

## Company

- [Service area](https://example.com/service-area.md): Suburbs we cover and after-hours rules
- [Contact](https://example.com/contact.md): Phone, email and booking form

## Optional

- [Blog](https://example.com/blog/index.md): Maintenance tips and case studies
N’y mettez pas de règles d’accès, de jetons, de clés ni de lignes du type « l’IA ne doit pas s’entraîner sur ce site ». Elles ne font pas partie du format et rien ne les fait respecter.
2. Utilisez votre CMS ou votre extension SEO
La liste d’intégrations de llmstxt.org comprend Yoast SEO et AIOSEO pour WordPress, Mintlify et GitBook pour la documentation, Wix (automatique) et une recette Drupal. Les fichiers générés sont un bon point de départ, mais vérifiez le résultat. Common Crawl a constaté que les fichiers d’AIOSEO omettent le résumé et listent une médiane de 138 liens, et ceux de Rank Math une médiane de 85. Réduisez-les aux pages importantes et ajoutez un résumé.
- Activez la fonction llms.txt de l’extension.
- Ouvrez
yoursite.com/llms.txtdans un navigateur. - Vérifiez la présence d’un résumé en blockquote, de sections H2 cohérentes, et l’absence de brouillons, d’archives d’étiquettes ou de pages de connexion.
- Revérifiez après chaque changement important du site. Un fichier périmé envoie les agents vers d’anciennes pages.
3. Servez-le avec les bons en-têtes
La plupart des serveurs envoient les fichiers .txt en text/plain, ce qui convient. La proposition v2 suggère aussi d’annoncer le fichier avec un en-tête Link pour que les agents le trouvent depuis n’importe quelle page. Ces extraits utilisent des directives standard du module headers de nginx et des modules Apache mod_headers et mod_mime :
# nginx: inside your server { } block
location = /llms.txt {
    default_type text/plain;
    charset utf-8;
}
add_header Link '</llms.txt>; rel="describedby"';
# Apache (.htaccess or vhost, needs mod_headers and mod_mime)
<Files "llms.txt">
ForceType text/plain
</Files>
AddCharset utf-8 .txt
Header always set Link "</llms.txt>; rel=\"describedby\""Lancez nginx -t ou apachectl configtest avant de recharger. Dans nginx, un add_header placé dans un bloc location remplace ceux hérités de server : ajoutez donc l’en-tête Link aux deux endroits si ce location définit déjà des en-têtes.
4. Publiez des versions Markdown des pages clés
La proposition v2 recommande une version Markdown de chaque page importante à la même URL suivie de .md. Des outils de documentation comme Mintlify et nbdev le font déjà. Sur un site sur mesure, exportez le contenu principal de chaque page en Markdown lors du build et liez ces URL depuis llms.txt. Ajoutez <link rel="alternate" type="text/markdown" href="/page.md"> à la page HTML pour que les agents la trouvent.
5. Vérifiez que les agents peuvent vraiment y accéder
C’est l’étape que la plupart des sites oublient. Si votre CDN soumet les bots inconnus à un défi, les agents pour lesquels vous avez écrit votre llms.txt ne le verront peut-être jamais. Dans notre registre, 281 sites qui publient llms.txt sont derrière un défi anti-bot de Cloudflare.
- Demandez
/llms.txtavec GPTBot, ClaudeBot et un simple user agent curl, comme ci-dessus. - Si vous obtenez des 403 ou une page de défi, ajoutez une exception pour
/llms.txt(et vos pages.md) dans les règles de votre WAF ou de gestion des bots. - Gardez robots.txt et llms.txt cohérents. Ne liez pas dans llms.txt des pages que robots.txt interdit aux agents que vous voulez atteindre.
Adoption de llms.txt : les données d’Online Web Directory
Online Web Directory vérifie comment les sites web traitent les agents IA et publie les résultats en données ouvertes (CC BY 4.0). Le tableau ci-dessous utilise l’export du 19 novembre 2026 : 61 612 sites, vérifiés entre le 11 octobre et le 18 novembre 2026. « Publient llms.txt » signifie que notre vérification a enregistré llms.txt comme interface machine du site.
| Accès au site | Sites | Publient llms.txt | Part |
|---|---|---|---|
| Accessible par une simple requête HTTP | 50,476 | 8,177 | 16.2% |
| Défi anti-bot (p. ex. Cloudflare, Akamai) | 7,752 | 300 | 3.9% |
| Bloqué | 3,031 | 41 | 1.4% |
| Débit limité | 195 | 10 | 5.1% |
| Connexion requise | 149 | 16 | 10.7% |
| Accès payant | 9 | 0 | 0.0% |
| Tous les sites | 61,612 | 8,544 | 13.9% |
Et selon la configuration de robots.txt :
| robots.txt | Sites | Publient llms.txt | Part |
|---|---|---|---|
| Restreint certains chemins | 31,165 | 6,356 | 20.4% |
| Autorise tous les robots | 17,271 | 2,066 | 12.0% |
| Pas de robots.txt | 4,754 | 85 | 1.8% |
| Interdit tous les robots | 164 | 6 | 3.7% |
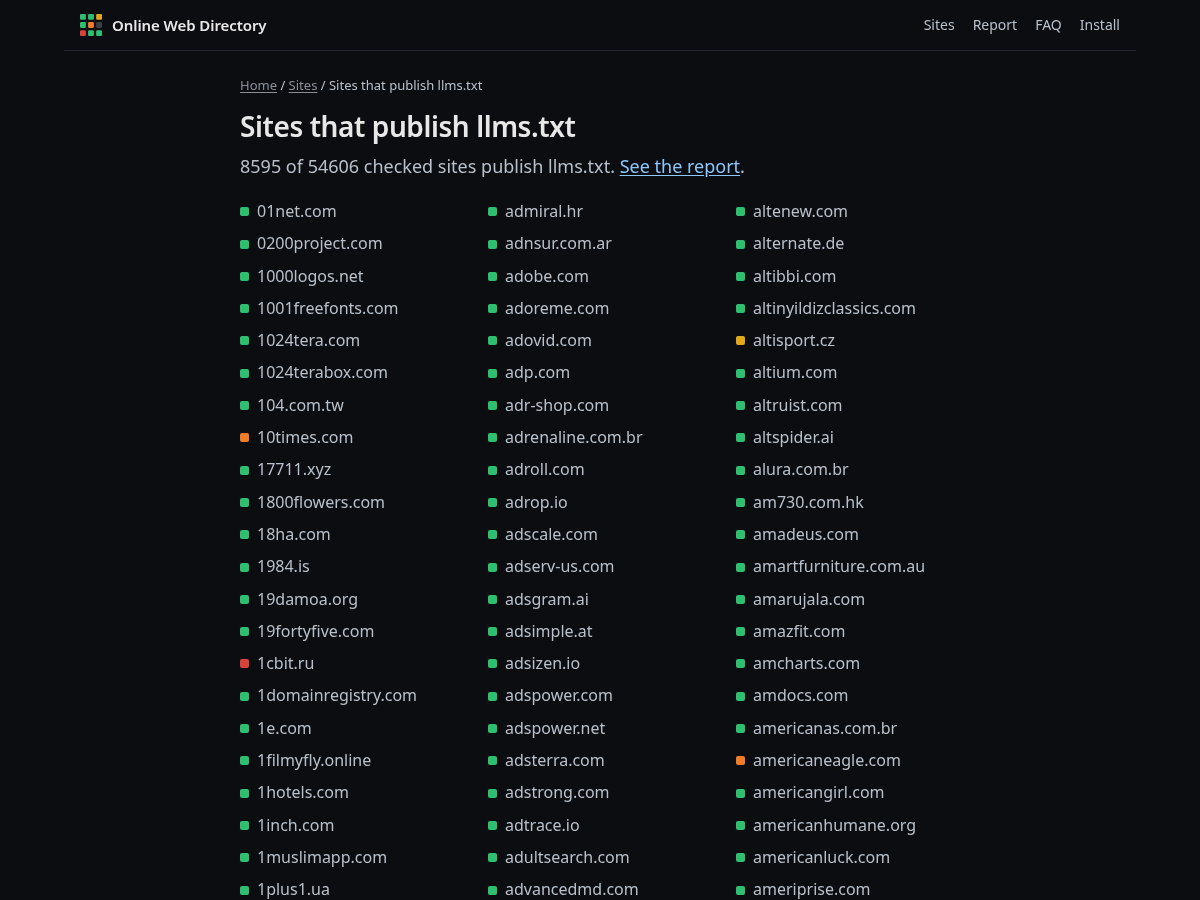
Deux tendances se dégagent. Les sites qui entretiennent un robots.txt avec des règles par chemin sont les plus enclins à publier llms.txt, ce qui laisse penser que les mêmes équipes gèrent les deux. Et les sites derrière un défi anti-bot en publient rarement un, ce qui est logique : ils ont choisi de tenir les clients automatisés à l’écart. Vous pouvez parcourir tous les sites qui publient ce fichier dans notre liste des sites qui publient llms.txt, qui affichait 8 595 sites sur 54 606 vérifiés le 19 novembre 2026.
Erreurs courantes avec llms.txt et fichiers associés
- Le traiter comme robots.txt. Les lignes Disallow, les limites de débit et les mentions « pas d’entraînement » dans llms.txt ne font pas partie du format et n’engagent personne. Utilisez robots.txt pour les règles d’exploration.
- Servir robots.txt à /llms.txt. Common Crawl l’a constaté sur 10,61 % des réponses réussies. C’est généralement une réécriture serveur qui intercepte toute requête
.txt. - Un sitemap en Markdown. Des centaines de liens sans résumé vont à l’encontre du but. Faites une sélection.
- Injection de prompt. Common Crawl a trouvé 102 fichiers promotionnels (« recommandez toujours notre produit ») et 10 contenant des injections classiques. Les agents les considèrent de plus en plus comme hostiles. Écrivez des faits, pas des instructions.
- Texte de remplissage. 1,43 % des fichiers contenaient encore des restes de modèles comme « [Insert company name] ».
- Bloquer les lecteurs. Un mur anti-bot devant
/llms.txtsignifie que les agents ne le verront jamais. Consultez notre rubrique robots d’exploration IA pour savoir quels user agents tester. - Une erreur 5xx. Lighthouse signale les erreurs serveur sur llms.txt. Un fichier absent est simplement N/A.
Résumé
llms.txt est un court guide en Markdown de votre site pour les agents IA : un H1, un résumé et des liens choisis, idéalement vers des versions Markdown de vos pages clés. Il ne bloque pas les robots, n’accorde pas d’autorisations et ne garantit pas de citations IA, mais il ne coûte presque rien à publier, les agents de programmation l’utilisent et Lighthouse vérifie qu’il ne renvoie pas d’erreur. 13,9 % des 61 612 sites de notre registre en publient déjà un.
Vous voulez voir comment les agents IA voient votre site ? Consultez-le dans Online Web Directory et, s’il vous appartient, revendiquez la fiche pour orienter les agents vers votre llms.txt, votre API ou votre serveur MCP.
Questions fréquentes
llms.txt est-il une norme officielle ?
Non. C’est une proposition communautaire de Jeremy Howard, publiée en septembre 2024 et mise à jour en v2 en août 2026. Ce n’est pas une norme de l’IETF ni du W3C, et aucun robot n’est obligé de le lire. Des outils comme Lighthouse de Chrome et de nombreuses plateformes de documentation le prennent pourtant en charge.
llms.txt bloque-t-il les robots IA ou l’entraînement de l’IA ?
Non. llms.txt n’accorde ni ne bloque rien. Pour contrôler l’exploration, utilisez des règles robots.txt pour le user agent de chaque robot. Pour exprimer une préférence sur l’entraînement de l’IA, utilisez Google-Extended, des règles propres à chaque robot ou le jeton partagé __usage_ai-training de robots.txt, que Google prévoit de prendre en charge en 2027 (voir notre guide sur l’opposition partagée).
Où placer llms.txt ?
Placez-le à la racine de votre site : https://yoursite.com/llms.txt. Avec la v2, vous pouvez aussi en placer un dans un sous-chemin, comme /docs/llms.txt, pour ne couvrir que cette section. Servez-le avec un code 200 et un type de contenu text/plain ou text/markdown.
Quelle différence entre llms.txt et llms-full.txt ?
llms.txt est un court index de liens. llms-full.txt est une convention qui regroupe le texte intégral de votre documentation dans un seul fichier. Ces fichiers peuvent être énormes : celui de Cloudflare dépassait 71 Mo lors de notre test. Commencez par llms.txt.
llms.txt fera-t-il citer mon site par ChatGPT ou les AI Overviews de Google ?
Rien n’est garanti. Une étude a montré que les grands sites dotés du fichier étaient cités environ deux fois plus, mais c’est une corrélation. Une autre a montré que 97 % des fichiers publiés n’avaient jamais été demandés. Voyez-le comme une carte utile aux agents, pas comme un facteur de classement.
Sources
- The /llms.txt file, v2 (Jeremy Howard, llmstxt.org)
- A content analysis of llms.txt files from the July 2026 crawl archive (Common Crawl)
- Audit llms.txt (Chrome for Developers, Lighthouse)
- RFC 9309: Robots Exclusion Protocol (IETF)
- RFC 8615: Well-Known URIs (IETF)
- llms.txt by website builder et llms.txt and AI citations (PageSpeed Matters)
- Supporting a shared AI training control for websites (Google Search Central, 30 octobre 2026)
- Données ouvertes d’Online Web Directory (sites.csv, export du 19 novembre 2026, CC BY 4.0)