

La mayoría de las «listas de crawlers de IA» que encontrarás están copiadas unas de otras, y muchas están desactualizadas. Siguen citando Claude-Web como el crawler de Anthropic, se inventan un bot «Googlebot-Extended» o te dicen que Google-Extended rastrea tus páginas. No lo hace. Google-Extended no tiene user agent propio; es solo un token de robots.txt.
Esta lista es distinta en dos aspectos. Cada user agent está contrastado con la documentación del propio operador, a 20 de noviembre de 2026. Y medimos cómo tratan a estos bots los sitios reales: descargamos el robots.txt de 3.000 sitios elegidos al azar del registro de Online Web Directory y contamos qué crawlers de IA nombran y bloquean. También tendrás reglas probadas para robots.txt, Nginx y Apache, y un script que comprueba si un visitante «GPTBot» viene de verdad de OpenAI.
¿Qué es una lista de crawlers de IA? Una lista de crawlers de IA es una referencia de los bots que usan las empresas de IA para descargar páginas web, con el token de robots.txt de cada bot, su cadena de user agent y su función: recopilar datos de entrenamiento, indexar páginas para la búsqueda con IA o descargar una página en directo porque un usuario lo pidió. Sirve para escribir reglas de robots.txt, leer registros del servidor y definir políticas de firewall.
Los crawlers de IA de un vistazo
| Pregunta | Respuesta corta |
|---|---|
| ¿Cuántos crawlers de IA importan? | Unos 20 user agents documentados de 9 operadores (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), además de DuckDuckGo y una larga cola de bots menores. |
| Tipos principales | Crawlers de entrenamiento, crawlers de búsqueda con IA y agentes o fetchers activados por el usuario. Google-Extended y Applebot-Extended son tokens de control, no crawlers. |
| ¿Respetan robots.txt? | Los crawlers de entrenamiento y de búsqueda documentados dicen que sí. Los fetchers activados por el usuario (ChatGPT-User, Perplexity-User, los fetchers activados por el usuario de Google, Meta-ExternalFetcher) dicen que robots.txt puede no aplicarse. |
| ¿Puede robots.txt devolver un 403? | No. robots.txt es una petición, no un candado. Un 403 viene de tu servidor, tu CDN o tu firewall. |
| ¿Con qué frecuencia los bloquean los sitios? | En nuestra muestra del 20 nov. 2026, el 16,9 % de los archivos robots.txt bloquea GPTBot por completo, pero solo el 2,8 % bloquea OAI-SearchBot. |
| ¿Cómo verifico un bot? | Compara la IP de la petición con la lista de IP publicada por el operador (por ejemplo https://openai.com/gptbot.json). Falsificar un user agent es trivial. |
La lista de crawlers de IA (verificada en noviembre de 2026)
La tabla muestra cada token de robots.txt, quién lo gestiona, qué hace según el operador y si el operador dice que respeta robots.txt. «Tipo» usa tres categorías: entrenamiento (recopila contenido que puede entrenar modelos), búsqueda (indexa páginas para que un producto de IA pueda citarlas después) y usuario (descarga una página en tiempo real porque una persona lo pidió). Hemos dejado fuera los bots cuyo operador no publica documentación que pudiéramos verificar.
| Token de robots.txt | Operador | Tipo | Qué hace | ¿Respeta robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Entrenamiento | Rastrea contenido que puede usarse para entrenar los modelos fundacionales de OpenAI. | Sí |
OAI-SearchBot |
OpenAI | Búsqueda | Indexa páginas para que puedan aparecer en los resultados de búsqueda de ChatGPT. | Sí |
ChatGPT-User |
OpenAI | Usuario | Visita una página cuando un usuario de ChatGPT o de un Custom GPT hace una pregunta. | «Puede no aplicarse» |
OAI-AdsBot |
OpenAI | Revisión de anuncios | Revisa las páginas de destino enviadas como anuncios de ChatGPT; no se usa para entrenar. | Solo visita páginas enviadas |
ClaudeBot |
Anthropic | Entrenamiento | Recopila contenido web que podría contribuir al entrenamiento de los modelos Claude. | Sí, y respeta Crawl-delay |
Claude-SearchBot |
Anthropic | Búsqueda | Indexa contenido para mejorar los resultados de búsqueda de Claude. | Sí |
Claude-User |
Anthropic | Usuario | Descarga páginas cuando un usuario de Claude hace una pregunta. | Sí, según Anthropic |
Google-Extended |
Token de control | Decide si el contenido que rastrea Google puede entrenar Gemini o fundamentar sus respuestas. No es un crawler aparte. | Solo token | |
Google-CloudVertexBot |
Solicitado por el propietario | Rastrea sitios cuyos propietarios crean Vertex AI Agents; no afecta a la Búsqueda de Google. | Sí | |
Google-Agent |
Usuario | Agentes en la infraestructura de Google que navegan y actúan a petición de un usuario. | Activado por el usuario: en general, no | |
PerplexityBot |
Perplexity | Búsqueda | Indexa páginas para los resultados de búsqueda de Perplexity; no se usa para entrenar. | Sí |
Perplexity-User |
Perplexity | Usuario | Descarga una página durante la sesión de Perplexity de un usuario. | «En general lo ignora» |
Applebot-Extended |
Apple | Token de control | Decide si las páginas que rastreó Applebot pueden entrenar los modelos fundacionales de Apple. No rastrea. | Solo token |
meta-externalagent |
Meta | Entrenamiento | Rastrea para usos como entrenar modelos de IA o indexar contenido. | Sí |
meta-externalfetcher |
Meta | Usuario | Descarga enlaces concretos a petición de un usuario, incluidas tareas de agentes. | «Puede saltárselo» |
Amazonbot |
Amazon | Entrenamiento | Mejora los productos y servicios de Amazon; puede usarse para entrenar modelos de IA de Amazon. | Sí |
Amzn-SearchBot |
Amazon | Búsqueda | Indexa páginas para experiencias de búsqueda como Alexa; no se usa para entrenar. | Sí |
Amzn-User |
Amazon | Usuario | Descarga información en directo para responder a un usuario, por ejemplo una consulta a Alexa. | «Puede no seguir todas» |
CCBot |
Common Crawl | Datos de entrenamiento | Construye el archivo web abierto de Common Crawl, una fuente habitual de datos de entrenamiento de IA. | Sí |
MistralAI-Training |
Mistral AI | Entrenamiento | Rastrea contenido para crear conjuntos de datos con los que entrenar los modelos de Mistral. | Sí |
MistralAI-Index |
Mistral AI | Búsqueda | Indexa contenido para la búsqueda de Mistral; no se usa para entrenar. | Sí |
MistralAI-User |
Mistral AI | Usuario | Visita una página cuando un usuario hace una pregunta a Vibe, el asistente de Mistral. | Sí, para peticiones de usuarios |
DuckAssistBot |
DuckDuckGo | Búsqueda | Rastrea páginas en tiempo real para las respuestas asistidas por IA de DuckDuckGo. | Sí (surte efecto a las 72 horas) |
Las fuentes de cada fila están enlazadas al final del artículo. Las citas de la última columna salen directamente de la documentación del operador. Bytespider (ByteDance) falta a propósito: no encontramos ninguna página de ByteDance que lo documente, aunque el 18,5 % de los archivos robots.txt de nuestra muestra lo nombra. Por la misma razón no describimos la larga cola de tokens como cohere-ai, Diffbot u omgili; en la sección de datos verás con qué frecuencia los nombran los sitios.
Cadenas completas de user agent que verás en los registros
robots.txt trabaja con el token corto, pero tus registros de acceso muestran la cadena completa. Estos son los ejemplos que publican los operadores. Los números de versión cambian, así que filtra por el token, no por la cadena entera.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
OpenAI también indica que GPTBot y OAI-SearchBot pueden añadir una marca robots.txt al user agent cuando descargan tu robots.txt, para que distingas esas peticiones en registros que no guardan rutas.
Tres tipos de crawler de IA y por qué importa la diferencia
Bloquear los «bots de IA» como un solo grupo es el error más común que vemos. Los tres tipos tienen costes y beneficios distintos, y los operadores tratan robots.txt de forma diferente en cada caso.
Crawlers de entrenamiento
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot y MistralAI-Training recopilan páginas que pueden acabar en datos de entrenamiento de modelos. Bloquearlos no te saca de los resultados de búsqueda con IA de la misma empresa: OpenAI dice que cada uno de sus ajustes de robots.txt es independiente, así que puedes bloquear GPTBot y seguir permitiendo OAI-SearchBot. En nuestra muestra, los crawlers de entrenamiento son el grupo más bloqueado. El 17,3 % de los archivos robots.txt bloquea CCBot por completo, el 16,9 % GPTBot y el 15,9 % ClaudeBot.
Crawlers de búsqueda con IA
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index y DuckAssistBot indexan páginas para que un asistente pueda encontrarlas y citarlas después. Bloquearlos puede dejarte fuera de esas respuestas. Los propietarios parecen saberlo: solo el 2,8 % de los archivos bloquea OAI-SearchBot por completo y el 5,8 % PerplexityBot, frente al 16,9 % de GPTBot.
Fetchers y agentes activados por el usuario
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User y Google-Agent actúan para una persona cada vez, como lo haría un navegador. Varios operadores dicen que robots.txt puede no aplicarse porque una persona pidió la página. Son también los bots que usan los agentes de compras y reservas, así que bloquearlos puede ahuyentar a clientes reales. El 5,9 % de los archivos de nuestra muestra bloquea ChatGPT-User por completo.
Tokens de control que no rastrean
Google-Extended y Applebot-Extended nunca visitan tu sitio. Google y Apple rastrean como siempre con Googlebot y Applebot, y luego consultan estos tokens para decidir si el contenido puede entrenar sus modelos. Según Google, bloquear Google-Extended no afecta a la inclusión ni al posicionamiento en la Búsqueda de Google. El 14,1 % de los archivos analizados bloquea Google-Extended por completo y el 13,5 % Applebot-Extended. Google también ha dicho que prevé admitir la señal compartida de entrenamiento de IA (user-agent: __usage_ai-training) a principios de 2027; lo explicamos en nuestra guía sobre la exclusión del entrenamiento de IA en robots.txt.
Tokens antiguos que siguen llenando los robots.txt
La página de ayuda actual de Anthropic solo menciona ClaudeBot, Claude-User y Claude-SearchBot. Aun así, el 15,6 % de los archivos analizados sigue nombrando anthropic-ai y el 13,8 % Claude-Web. Las reglas para esos nombres no hacen daño, pero si son tus únicas reglas para Anthropic, puede que no cubran los bots que Anthropic documenta hoy. Comprueba que ClaudeBot aparece de forma explícita.
Cómo se ve en la práctica el acceso de los crawlers de IA
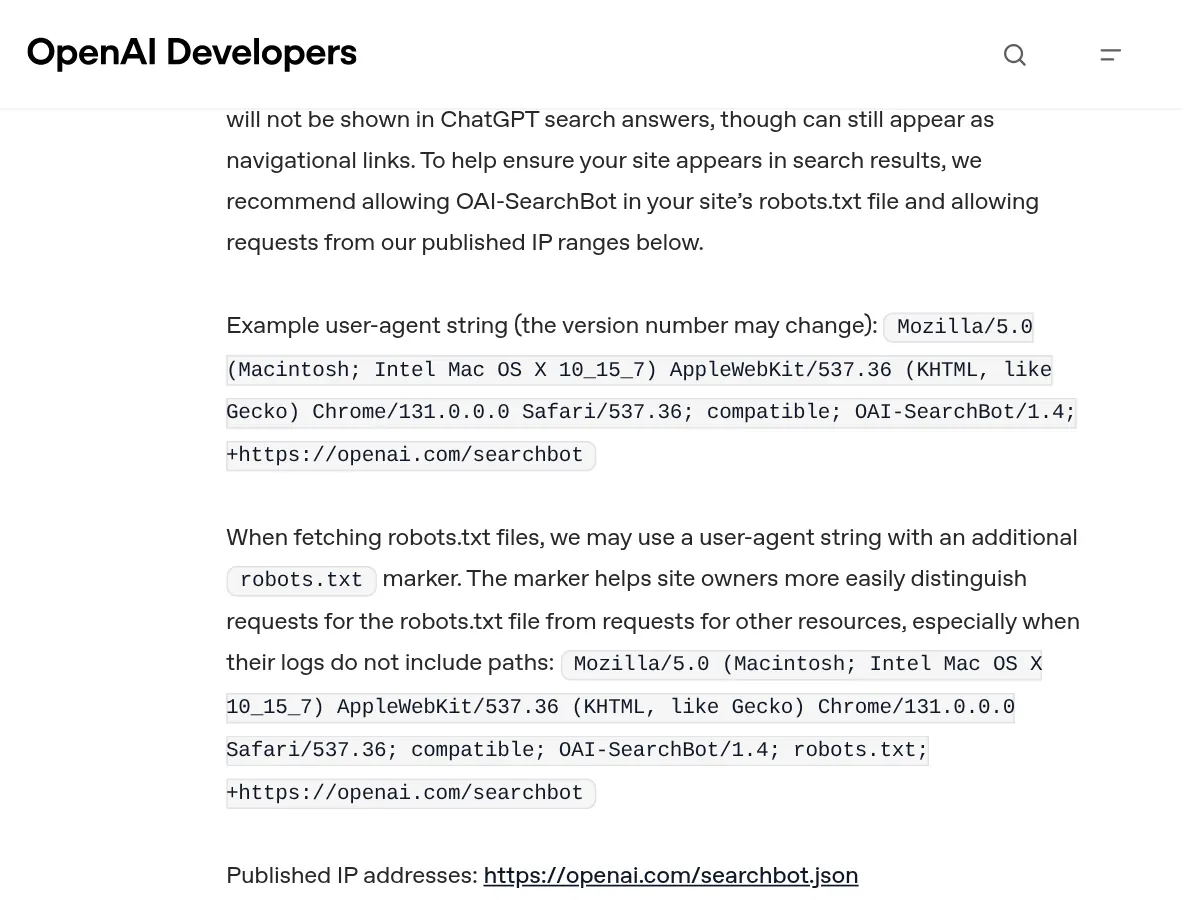
La documentación de los operadores es la fuente fiable para los user agents. La página de OpenAI, por ejemplo, lista cada bot con una cadena de user agent de ejemplo, notas sobre la marca de robots.txt y un enlace a su archivo de IP publicado.
Lo que un sitio hace de verdad con estos bots es otra cuestión. Pedimos seis páginas de inicio desde nuestro servidor con un user agent de Chrome, el user agent GPTBot de OpenAI y un user agent de ClaudeBot. Nuestro servidor está en una IP de centro de datos, que muchas defensas contra bots miran con recelo, así que desde una conexión doméstica los resultados pueden variar.
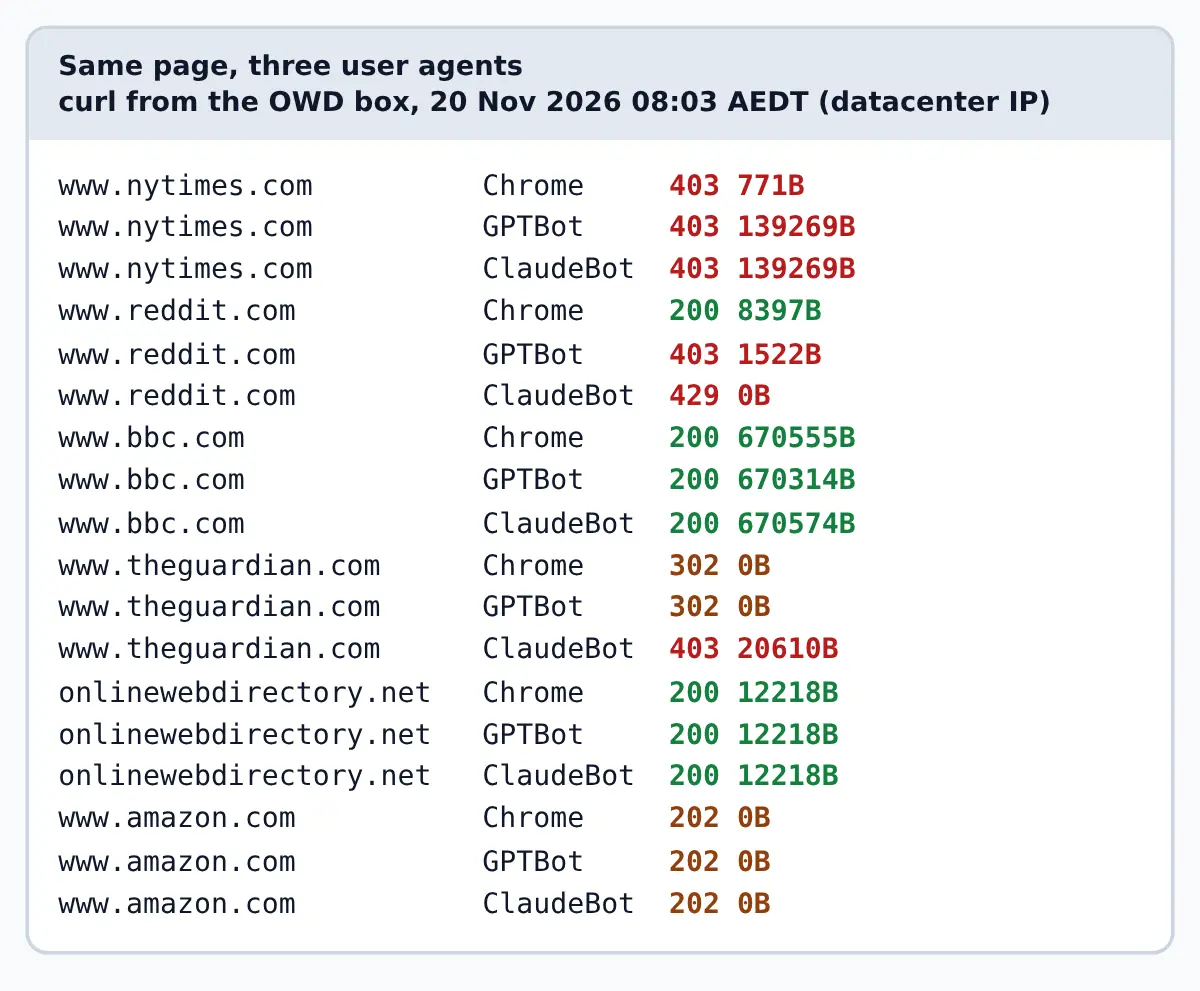
Aparecen tres patrones. Reddit sirvió la página a Chrome, pero devolvió 403 a GPTBot y 429 a ClaudeBot: filtrado por user agent en el servidor o la CDN. The New York Times devolvió 403 a los tres, lo que sugiere que el bloqueo se basaba en nuestra IP o en la huella de la petición, no en el user agent. Y bbc.com devolvió 200 a GPTBot aunque su robots.txt bloquea GPTBot, ClaudeBot, CCBot, PerplexityBot y al menos otros cinco tokens de IA. Es la prueba más clara de que robots.txt pide y no impone. Amazon respondió a los tres con un 202 y el cuerpo vacío, una página intermedia de verificación en lugar de una página real.
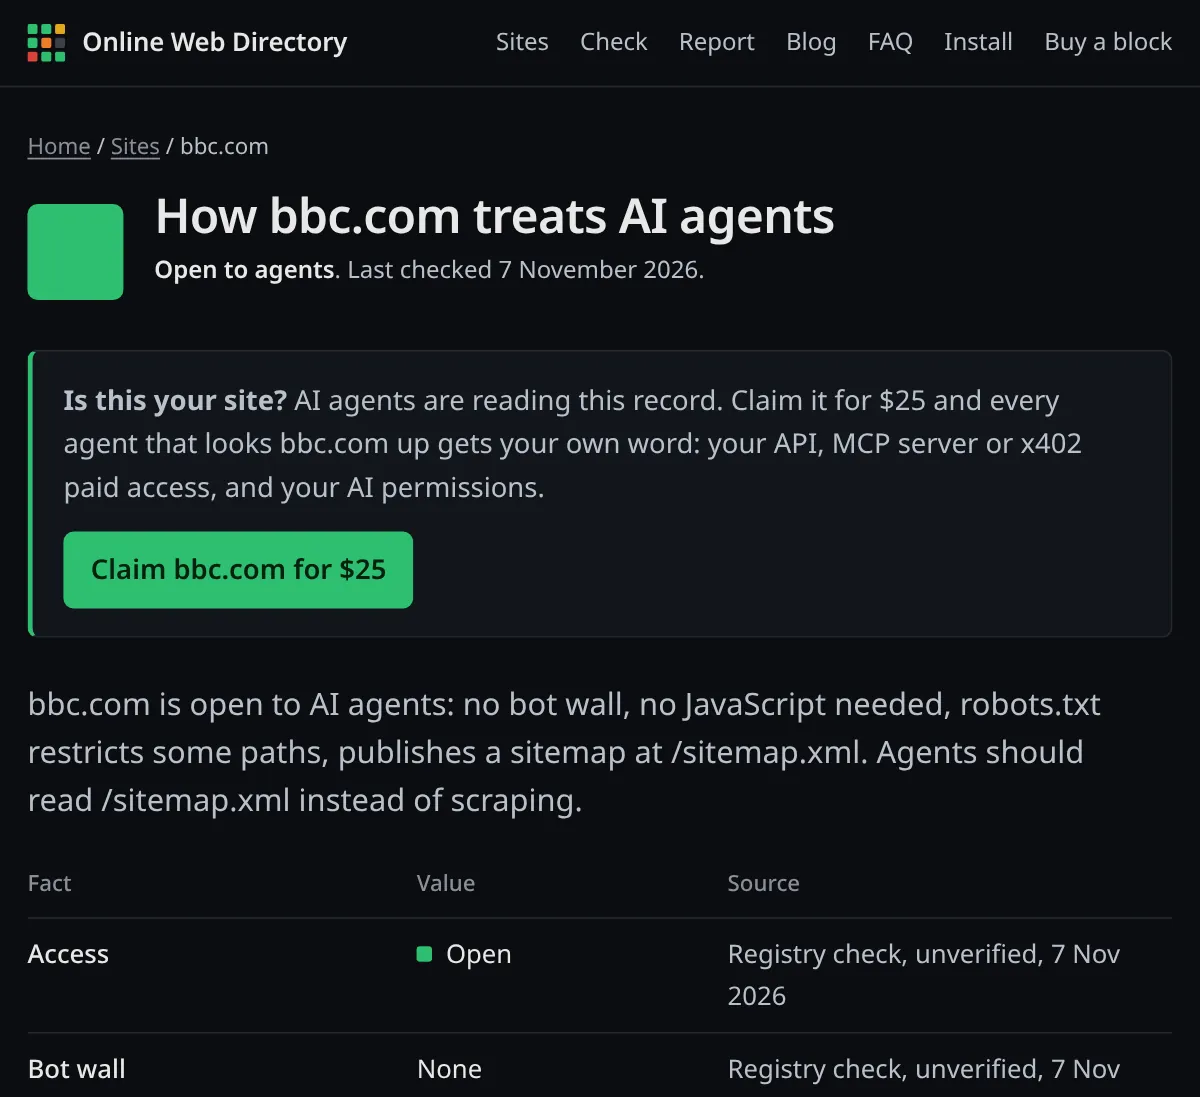
La ficha de cada sitio en Online Web Directory separa estas dos capas: si los agentes pueden llegar al sitio y qué dice su robots.txt.
Cómo comprobar qué crawlers de IA pueden llegar a tu sitio
1. Lee los grupos de tu robots.txt para tokens de IA
Empieza por lo que les pides a los crawlers. Este comando muestra cada grupo que nombra un token de IA habitual, con la línea siguiente:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Salida real para bbc.com el 20 de noviembre de 2026 a las 08:09 AEDT (recortada a cuatro de los nueve grupos):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Recuerda que un crawler solo obedece el grupo más específico que coincide con su token. Si nombras GPTBot en su propio grupo, ignorará por completo tus reglas de User-agent: *, así que repite las reglas comunes dentro del grupo de GPTBot.
2. Prueba cómo responde tu servidor a los user agents de IA
robots.txt puede decir «no» mientras tu servidor sigue diciendo «sí», o al revés. Pide la misma página con distintos user agents y compara los códigos de estado:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Sustituye la URL por la tuya. Un 403 o 429 solo para GPTBot indica filtrado por user agent. Un 403 para ambos suele indicar reputación de IP o un desafío antibots. Hazlo desde una conexión doméstica y desde un servidor: los crawlers reales vienen de IP de centros de datos, así que el resultado del servidor se parece más a lo que ven ellos.
3. Encuentra crawlers de IA en tus registros de acceso
Cuenta las visitas por bot y después revisa qué códigos de estado recibió cada uno. Ejecutamos estos comandos sobre el registro de acceso de un servidor Nginx de prueba el 20 de noviembre de 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
El segundo comando funciona con el formato de registro estándar «combined», en el que el código de estado va después de la línea de petición entre comillas. Un 200 de GPTBot en /robots.txt y un 403 en todo lo demás es justo lo que buscas cuando bloqueas los crawlers de entrenamiento en el servidor.
4. Verifica que un visitante «GPTBot» es realmente OpenAI
Cualquiera puede enviar un user agent de GPTBot. OpenAI, Perplexity, DuckDuckGo, Mistral y Google publican listas de IP, así que comprueba la IP de origen. Este script contrasta una IP con los tres archivos de OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Salida del 20 de noviembre de 2026 a las 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
En el momento de la prueba, el gptbot.json de OpenAI tenía 18 rangos IPv4 con fecha de creación del 22 de septiembre de 2026. Descarga los archivos cada vez en lugar de copiarlos en tu configuración.
5. Busca tu sitio en el registro
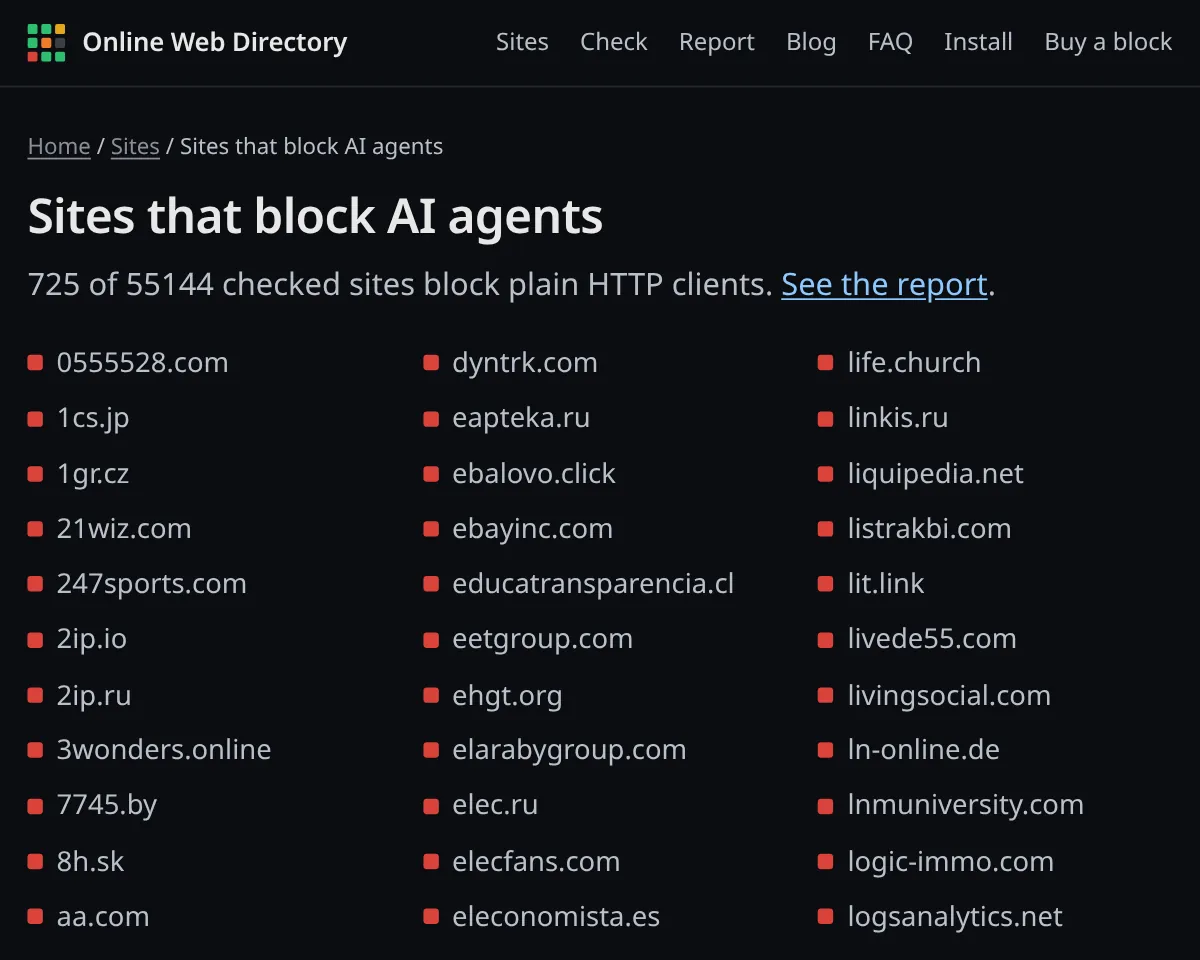
Online Web Directory comprueba cómo responden los sitios a los clientes HTTP básicos y qué dice su robots.txt. Busca tu dominio, por ejemplo reddit.com o nytimes.com, o usa la comprobación de preparación gratuita. La lista de sitios que bloquean agentes de IA muestra qué dominios rechazan a los clientes básicos.
Cómo controlar los crawlers de IA: seis métodos
Elige según lo que quieras. La mayoría de los sitios quiere conservar el tráfico de la búsqueda con IA, decidir caso por caso sobre el entrenamiento y no tocar a los agentes activados por el usuario.
Método 1: Bloquear los crawlers de entrenamiento y mantener la búsqueda con IA (robots.txt)
Es la política más común entre los sitios de nuestra muestra. Añade esto a /robots.txt en la raíz de cada host que sirvas:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Probamos este archivo con Protego, un analizador conforme a RFC 9309. Resultados para la ruta /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Apilar varias líneas User-agent sobre un mismo bloque de reglas es válido según RFC 9309. Ten en cuenta que el grupo de búsqueda con IA no hereda la regla /wp-admin/ del grupo *; añádela también allí si la necesitas.
Método 2: Bloquear todos los crawlers de IA documentados (robots.txt)
Si no quieres ningún uso por parte de la IA, añade los tokens de búsqueda y de usuario al grupo de bloqueo: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User y DuckAssistBot. Cuenta con desaparecer de las respuestas de IA. Y recuerda que varios fetchers activados por el usuario dicen que robots.txt puede no aplicarse a ellos: es una declaración de preferencias, no un muro.
Método 3: Imponer el bloqueo en Nginx
Para rechazar peticiones de verdad, filtra en el servidor. Esta configuración devuelve 403 a los crawlers de entrenamiento en todas las rutas salvo robots.txt, para que puedan seguir leyendo tus reglas. El bloque map va en el contexto http:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
La probamos con Nginx 1.26.3 el 20 de noviembre de 2026: nginx -t pasó, GPTBot recibió 403 en / y 200 en /robots.txt, y Chrome y OAI-SearchBot recibieron 200 en ambas. Un único return dentro de if es uno de los usos que Nginx documenta como seguros.
Método 4: Imponer el bloqueo en Apache (.htaccess)
La misma regla para Apache con mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Probado en Apache 2.4.71 con AllowOverride All: GPTBot recibió 403 en la página de inicio y 200 en robots.txt; Chrome y OAI-SearchBot recibieron 200. La bandera [F] envía 403 Forbidden.
Método 5: Usar las políticas de crawlers de IA de tu CDN
Si usas Cloudflare, no necesitas mantener una lista. En Security, Settings, filtra por «Bot traffic» y abre AI Crawler and Agent access policies. Cloudflare permite fijar acciones distintas para el tráfico Search, Agent y Training. Su documentación dice que los dominios nuevos usan por defecto «Allow (do not block)» en los tres, y que «Disallow» para Training solo edita robots.txt salvo que Bot Preference Sync esté activado. El panel AI Crawl Control de Cloudflare también muestra qué crawlers visitan y si respetan tu robots.txt. De los 62.088 sitios de nuestro registro, 6.966 (11,2 %) mostraron un desafío de Cloudflare a nuestro comprobador.
Método 6: Verificar y luego permitir
Las reglas por user agent bloquean a los bots honestos y dejan pasar a los deshonestos. Si bloqueas en el edge, combina la regla con una comprobación de IP (ver el paso 4) y deja pasar a los agentes de búsqueda y de usuario verificados. Anthropic advierte de que bloquear sus direcciones IP puede no funcionar de forma fiable como exclusión, porque impide que ClaudeBot lea tu robots.txt. Usa robots.txt para la política y las comprobaciones de IP para detectar impostores.
Qué dicen 2.124 archivos robots.txt sobre los crawlers de IA
El 20 de noviembre de 2026, entre las 08:01 y las 08:03 AEDT, elegimos al azar 3.000 hosts de los 62.088 sitios del conjunto de datos abierto de Online Web Directory y descargamos /robots.txt desde nuestro servidor. 2.124 devolvieron un archivo analizable. Un token cuenta como «nombrado» si tiene su propia línea User-agent, y como «bloqueado por completo» si ese grupo tiene Disallow: / sin Allow: /.
| Token de robots.txt | Nombrado | Bloqueado por completo |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (antiguo) |
15.6% | 13.3% |
Claude-Web (antiguo) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Destacan cuatro hallazgos:
- La mayoría de los sitios no menciona los crawlers de IA. 629 de 2.124 archivos (29,6 %) nombran al menos un token específico de IA. Los que lo hacen suelen nombrar muchos: la mediana es de 12 tokens, y 357 archivos nombran 10 o más, señal de listas de bloqueo copiadas.
- Se bloquea el entrenamiento, no la búsqueda. GPTBot se bloquea por completo seis veces más que OAI-SearchBot (16,9 % frente a 2,8 %).
- robots.txt y el acceso real no coinciden. De los 358 sitios que bloquean GPTBot por completo en robots.txt, 284 (79 %) estaban «abiertos» en la comprobación de acceso propia de OWD: nada en el servidor detuvo a un cliente básico.
- Los vetos generales son raros. Solo 13 archivos (0,6 %) bloquean todo para todos los user agents.
El registro completo cuenta la misma historia desde el otro lado. Estos son los resultados de acceso de los 62.088 sitios, comprobados por última vez entre el 11 de octubre y el 19 de noviembre de 2026:
| Qué encontró un cliente HTTP básico | Sitios | Porcentaje |
|---|---|---|
| Abierto | 50,844 | 81.9% |
| Desafío antibots | 7,821 | 12.6% |
| Bloqueado | 3,060 | 4.9% |
| Limitado por tasa | 199 | 0.3% |
| Requiere inicio de sesión | 150 | 0.2% |
| Muro de pago | 14 | 0.0% |
Descarga el conjunto de datos completo (CC BY 4.0) en onlinewebdirectory.net/exports/sites.csv o consulta el informe de acceso de agentes de IA.
Errores y respuestas relacionados
- 403 Forbidden. Tu servidor, CDN o firewall rechazó la petición. Nunca lo causa robots.txt, y no es permanente: cambia la regla y la siguiente petición puede funcionar.
- 429 Too Many Requests. Limitación de tasa. Reddit devolvió este código a nuestra petición como ClaudeBot. Anthropic admite
Crawl-delay, una alternativa más suave para ClaudeBot. - 202 con el cuerpo vacío o una página de desafío 503. Suele ser un desafío de JavaScript o CAPTCHA. Los crawlers no pueden resolverlos, así que para ellos la página está bloqueada aunque no se envíe un 403.
- robots.txt devuelve 4xx. Según RFC 9309, una respuesta de 400 a 499 significa que el archivo «no está disponible» y los crawlers pueden acceder a todo. En nuestra muestra, 314 de 3.000 sitios (10,5 %) respondieron con 403 a nuestra petición de robots.txt, algo que un crawler conforme interpretaría como ninguna regla.
- robots.txt devuelve 5xx o no responde. RFC 9309 dice que los crawlers deben asumir entonces un bloqueo total, así que una caída del robots.txt puede bloquear sin avisar a todos los crawlers, Googlebot incluido.
- robots.txt de más de 500 KiB. RFC 9309 solo obliga a los crawlers a procesar los primeros 500 KiB, así que las reglas posteriores pueden ignorarse.
Si publicas un archivo llms.txt para agentes de IA, asegúrate de que los bots que permites pueden descargarlo. Nuestra guía de llms.txt explica cómo comprobarlo.
Resumen
Una lista fiable de crawlers de IA empieza por la documentación de los propios operadores, no por otras listas. Hoy son unos 20 user agents de 9 empresas en tres tipos: crawlers de entrenamiento, crawlers de búsqueda con IA y agentes activados por el usuario, además de dos tokens de control (Google-Extended y Applebot-Extended) que nunca rastrean. La mayoría de los sitios que actúan bloquea el entrenamiento y mantiene la búsqueda, y robots.txt es solo una petición: si necesitas un bloqueo real, impónlo en el servidor o la CDN y verifica las IP.
Los agentes de IA ya consultan los sitios en Online Web Directory antes de visitarlos. Si la ficha de tu sitio es incorrecta, o quieres que los agentes conozcan tu API, tu servidor MCP o tus permisos de IA, reclama tu sitio por 25 $. Antes puedes hacer la comprobación de preparación gratuita.
Preguntas frecuentes
¿Cuál es el user agent de ChatGPT?
ChatGPT usa tres. GPTBot recopila datos de entrenamiento, OAI-SearchBot indexa páginas para la búsqueda de ChatGPT y ChatGPT-User descarga una página cuando un usuario lo pide. Sus tokens de robots.txt son GPTBot, OAI-SearchBot y ChatGPT-User.
¿Bloquear GPTBot saca mi sitio de la búsqueda de ChatGPT?
No. OpenAI controla la búsqueda mediante OAI-SearchBot. Puedes bloquear GPTBot para excluirte del entrenamiento y seguir permitiendo OAI-SearchBot para que tus páginas aparezcan y se citen en la búsqueda de ChatGPT.
¿Google-Extended es un crawler?
No. Google dice que Google-Extended no tiene un user agent propio. Googlebot hace el rastreo, y el token Google-Extended solo controla si ese contenido puede usarse para entrenar y fundamentar Gemini. No afecta al posicionamiento en la Búsqueda de Google.
¿Los crawlers de IA respetan robots.txt?
Los crawlers de entrenamiento y de búsqueda documentados en esta lista dicen que sí. Los fetchers activados por el usuario, como ChatGPT-User, Perplexity-User y Meta-ExternalFetcher, dicen que robots.txt puede no aplicarse porque una persona pidió la página. Los scrapers no documentados pueden ignorarlo por completo.
¿Cómo sé si un bot es de verdad GPTBot o ClaudeBot?
Comprueba la IP de origen. OpenAI publica rangos en gptbot.json, searchbot.json y chatgpt-user.json; Perplexity, DuckDuckGo, Mistral y Google publican los suyos. Un user agent que coincide desde una IP que no figura en la lista es un impostor.
Fuentes
- OpenAI, Overview of OpenAI crawlers (consultado el 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers y user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies y AI Crawl Control
- Online Web Directory, conjunto de datos abierto de sitios (62.088 sitios, exportado el 20 nov. 2026) y nuestra muestra de robots.txt de 3.000 hosts