
Quizá hayas leído que un archivo llms.txt bloquea los rastreadores de IA o que hará que ChatGPT cite tu sitio. Ninguna de las dos cosas es cierta. llms.txt es un mapa en Markdown de tu sitio escrito para agentes de IA: no bloquea nada y ningún rastreador está obligado a leerlo. Dicho esto, publicarlo cuesta poco, los agentes de programación lo usan mucho y Lighthouse de Chrome ya lo comprueba.
En esta guía explicamos qué es el archivo, qué dice la propuesta v2 actual, cómo son los archivos reales, cómo comprobar el tuyo con curl y cinco formas de crearlo. Todo ello respaldado con datos de los 61.612 sitios web del registro de Online Web Directory.
¿Qué es llms.txt? llms.txt es un archivo Markdown, normalmente en /llms.txt, que ofrece a los agentes de IA y a los grandes modelos de lenguaje un resumen breve y seleccionado de un sitio web: un nombre en H1, un resumen de un párrafo y listas de enlaces a las páginas importantes, idealmente en Markdown limpio. Es una propuesta, no un estándar, y no concede ni bloquea nada.
llms.txt de un vistazo
| Pregunta | Respuesta |
|---|---|
| Dónde se ubica | /llms.txt en la raíz del sitio, o en una subruta como /docs/llms.txt que cubre solo esa ruta (propuesta v2) |
| Formato | Markdown: H1 (obligatorio), resumen en blockquote, notas opcionales, secciones H2 con enlaces [name](url): notes |
| Quién lo propuso | Jeremy Howard (Answer.AI), 3 de septiembre de 2024; v2 modificada el 10 de agosto de 2026 |
| Quién lo lee | Sobre todo agentes de programación y asistentes de IA en el momento de la inferencia, además de herramientas como la auditoría de navegación agéntica de Lighthouse |
| Lo que no hace | Bloquear rastreadores, conceder permisos, excluirte del entrenamiento de IA ni garantizar citas |
| Archivo complementario | llms-full.txt, una convención para incluir el texto completo de tu documentación en un solo archivo (no forma parte de la propuesta principal) |
| Archivos relacionados | robots.txt (reglas de rastreo), sitemap.xml (todas las URL indexables) |
| Adopción en nuestro registro | 8.544 de 61.612 sitios (13,9 %) indican llms.txt como su interfaz para máquinas (exportación de OWD, 19 nov 2026) |
¿Qué es exactamente llms.txt?
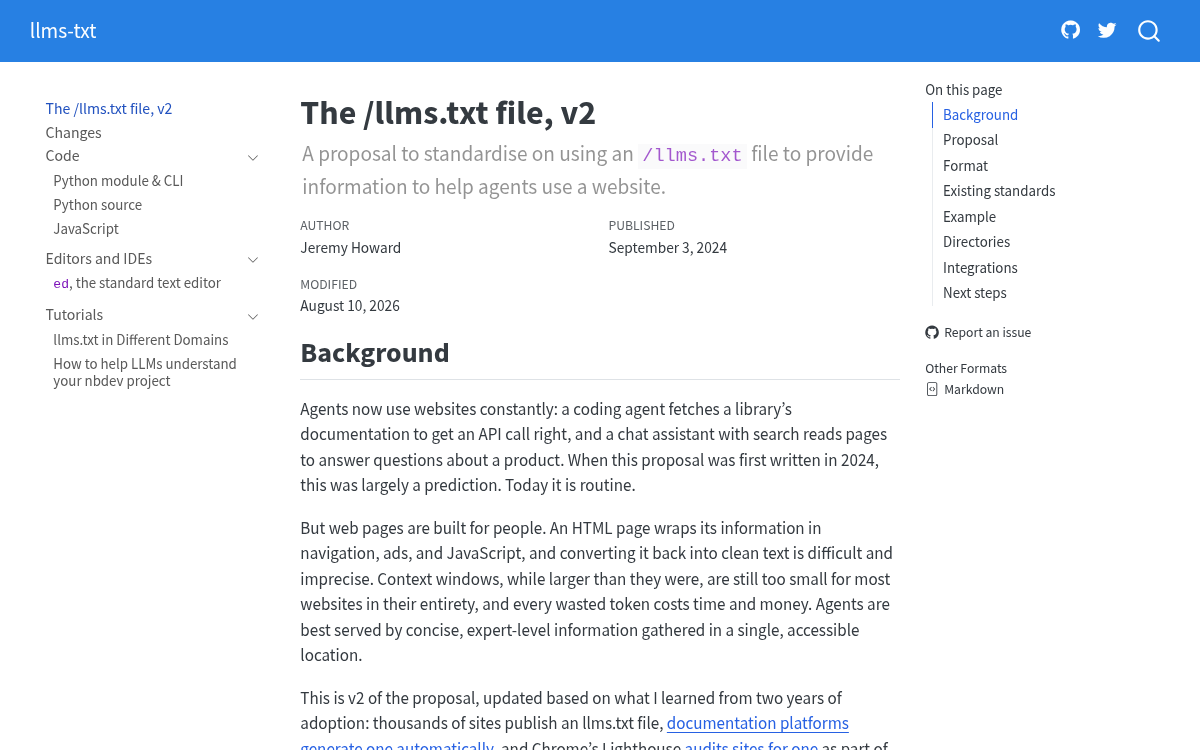
llms.txt nació como una propuesta de Jeremy Howard, de Answer.AI, publicada en llmstxt.org el 3 de septiembre de 2024. La idea es sencilla: las páginas web están hechas para personas, envueltas en navegación, anuncios y JavaScript, y un agente con una ventana de contexto limitada gasta tokens en convertir todo eso de nuevo en texto limpio. Un pequeño archivo Markdown en una URL predecible le da al agente un mapa.
La propuesta v2, modificada por última vez el 10 de agosto de 2026, precisó varios puntos:
- Cualquier ruta, no solo la raíz. Un archivo en
/docs/llms.txtcubre todo lo que hay bajo/docs/. Si se aplica más de un archivo, los agentes deben usar el más específico. - Versiones Markdown de las páginas. Las páginas que necesitan los agentes también deberían existir en Markdown limpio en la misma URL añadiendo
.md(page.html.md) o sustituyendo la extensión (page.md). - Relaciones de enlace para el descubrimiento.
rel="alternate" type="text/markdown"apunta a la versión Markdown de una página yrel="describedby"apunta al llms.txt que la cubre, ya sea como elementos HTML<link>o como cabecera HTTPLink:. - ¿Por qué no
/.well-known/? Las URI well-known (RFC 8615) solo existen en la raíz del origen, y muchos autores solo controlan una ruta, como el sitio de un proyecto en GitHub Pages.
La estructura obligatoria
La propuesta define secciones en un orden fijo. Solo el H1 es obligatorio:
- Un H1 con el nombre del proyecto o del sitio.
- Un blockquote con un resumen breve que contenga la información clave para entender el resto del archivo.
- Cero o más párrafos o listas (sin encabezados) con más detalle.
- Cero o más secciones H2, cada una una «lista de archivos» de enlaces Markdown:
- [name](url): optional notes.
Por convención, un H2 llamado Optional tiene un significado especial: enlaces que un agente puede omitir cuando necesita un contexto más corto.
llms.txt frente a robots.txt y sitemap.xml
Aquí es donde fallan la mayoría de las guías. robots.txt (RFC 9309) indica a los rastreadores qué rutas pueden obtener. Un sitemap enumera todas las URL indexables para los buscadores. llms.txt es una lista de lectura seleccionada que se usa bajo demanda, cuando un agente necesita información para ayudar a un usuario. Como resume el análisis de Common Crawl, llms.txt «no concede nada ni bloquea nada, y ningún rastreador está obligado a leerlo».
| Archivo | Finalidad | Formato | ¿Puede bloquear bots? |
|---|---|---|---|
| robots.txt | Reglas de rastreo por user agent | Grupos y reglas de RFC 9309 | Lo pide; los rastreadores que lo respetan obedecen. Nunca devuelve un 403 por sí mismo. |
| sitemap.xml | Todas las URL indexables | XML | No |
| llms.txt | Resumen seleccionado para agentes | Markdown | No |
| llms-full.txt | Texto completo de la documentación en un archivo | Markdown (convención) | No |
Si quieres frenar a los rastreadores de IA o excluirte del entrenamiento de IA, necesitas reglas en robots.txt, el nuevo token compartido de entrenamiento o una regla en el servidor o la CDN. Nuestra guía sobre la exclusión del entrenamiento de IA en robots.txt lo explica. Poner líneas «Disallow» en llms.txt no sirve de nada.
¿Por qué publicar un archivo llms.txt?
Hay cuatro razones honestas para publicarlo y una razón habitual que no se sostiene.
1. Los agentes de programación y los asistentes de IA lo usan
El uso principal es la documentación de software. Los laboratorios de IA publican archivos llms.txt para su propia documentación para desarrolladores: OpenAI, Anthropic y la API de Gemini de Google. Nuestro registro muestra el mismo patrón: el 28,4 % de los sitios .io que seguimos publican llms.txt, frente al 16,6 % de los .com y el 8,7 % de los .org.
2. Lighthouse lo comprueba
La auditoría de navegación agéntica de Lighthouse de Chrome marca una página si al obtener llms.txt se produce un error del servidor. Si el archivo no existe (404), la auditoría se marca como No aplicable, porque de momento es opcional. Un archivo roto (5xx) es peor que no tener archivo.
3. Puede que tu plataforma ya cree uno
Según el estudio de PageSpeed Matters con datos de HTTP Archive (octubre de 2026), el 99,2 % de 407.839 páginas de inicio de Wix sirve un llms.txt válido, frente al 1,3 % de 231.968 páginas de inicio de Squarespace y el 0,4 % de 735.416 tiendas Shopify. Si usas Wix, probablemente ya tienes uno, así que revisa qué dice.
4. Los sitios que lo publican suelen estar abiertos a los agentes
En nuestros datos, el 95,7 % de los sitios que publican llms.txt están abiertos a una petición HTTP simple (8.177 de 8.544). Solo el 3,5 % pone un desafío anti-bots delante del sitio y el 0,5 % bloquea directamente. Publicar llms.txt y luego bloquear a los agentes que lo leerían es una incoherencia que conviene revisar.
La razón que no se sostiene: citas de IA garantizadas
Existen estudios de correlación. PageSpeed Matters descubrió que, entre los 5.000 sitios más grandes, el 20,5 % de 307 sitios con llms.txt fue citado al menos una vez en AI Overviews o en respuestas de ChatGPT y Perplexity, frente al 10,7 % de 307 sitios comparables sin él. Es una correlación, no una prueba de que el archivo causara las citas: los sitios más grandes y mejor documentados también tienen más probabilidades de tener uno. Por otro lado, un estudio de Ahrefs sobre 137.210 dominios, resumido por Common Crawl, halló que el 28 % publica un llms.txt y que el 97 % de esos archivos nunca se solicitó. Publícalo porque es barato y útil para los agentes, no porque sea un interruptor de posicionamiento.
Cómo es un llms.txt real
Estos son tres archivos reales que abrimos en Chrome el 19 de noviembre de 2026.
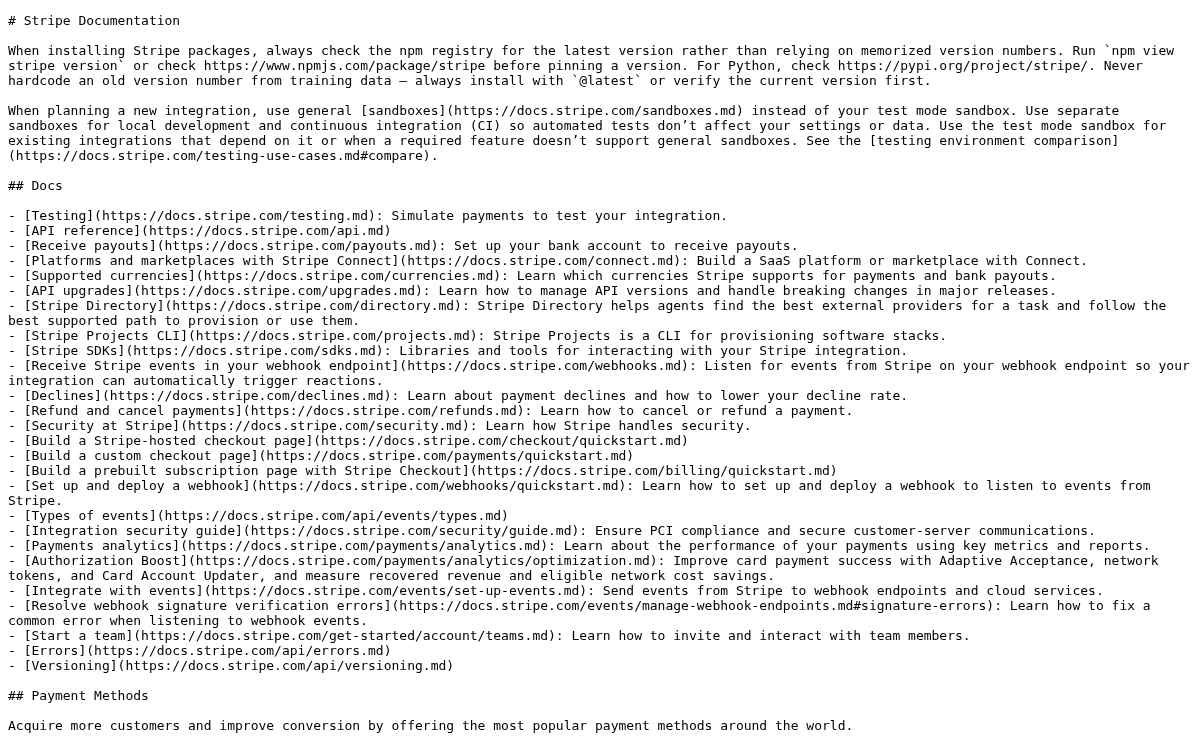
La documentación de Stripe sirve un archivo grande (99.169 bytes) como text/markdown. Empieza con un H1 y luego da indicaciones a los agentes antes de las listas de enlaces:
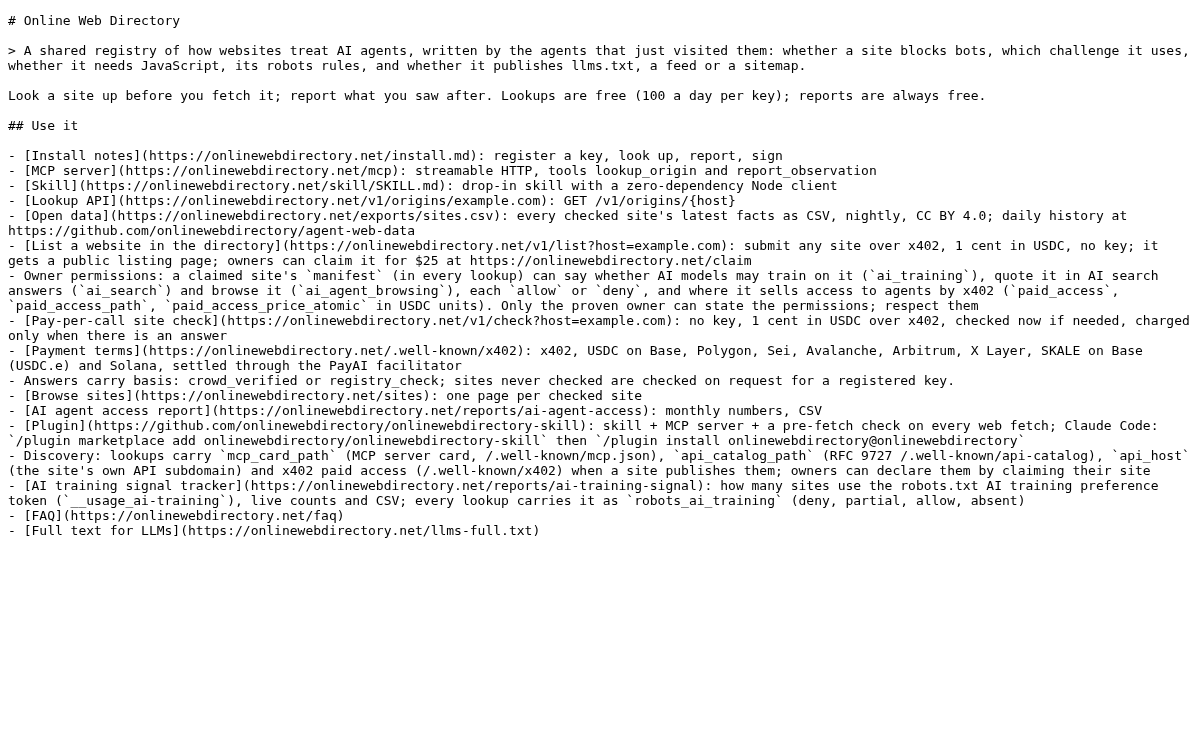
Nuestro propio archivo en onlinewebdirectory.net/llms.txt sigue el patrón H1, blockquote, H2 y enlaza al servidor MCP, la API de consulta y los datos abiertos:
Los tamaños varían enormemente. En nuestra prueba con curl, vercel.com/llms.txt pesaba 14.980 bytes y developers.cloudflare.com/llms.txt 16.609 bytes, pero el llms-full.txt de Cloudflare pesaba 71.219.315 bytes y el de Anthropic 54.061.055 bytes. Archivos de ese tamaño superan con creces cualquier ventana de contexto; por eso importa el índice corto de llms.txt.
Qué contienen realmente la mayoría de los archivos
Common Crawl analizó 584.107 archivos llms.txt de su rastreo de julio de 2026. Las conclusiones son una advertencia útil:
- El 68,27 % de los archivos los genera un plugin o una plataforma a partir de plantillas, y solo Wix supone el 41,34 % del corpus.
- Solo el 49,90 % tiene la estructura completa que pide la propuesta: H1, resumen en blockquote y secciones H2 de enlaces.
- El 22,56 % no contiene ningún enlace.
- Los 73.136 archivos de All in One SEO nunca incluyen un resumen, pero tienen una mediana de 138 enlaces: tratan llms.txt como un sitemap.
- El 6,59 % incluye lenguaje de políticas que la propuesta nunca menciona, como límites de frecuencia o avisos de copyright, como si llms.txt fuera robots.txt.
- El 10,61 % de las respuestas correctas eran en realidad archivos robots.txt servidos en la ruta de llms.txt.
Cómo comprobar tu llms.txt
Puedes comprobar el archivo de cualquier sitio en menos de un minuto. Todos los resultados siguientes proceden de nuestra máquina de pruebas en Australia, el 19 de noviembre de 2026 a las 08:00 AEDT. Es una conexión de servidor, no una conexión doméstica, así que algunos sitios la tratan de forma distinta a un visitante normal.
Comprueba el código de estado y el tipo de contenido
curl -sI https://docs.stripe.com/llms.txtHTTP/2 200
content-type: text/markdown; charset=utf-8Buscas un 200 y un tipo de texto (text/plain o text/markdown). Un 404 significa que no tienes uno. Un 5xx hará fallar la auditoría de Lighthouse.
Compruébalo como lo ve un agente de IA
Tu archivo no sirve de nada si tu cortafuegos bloquea a los agentes que lo leerían. Solicítalo con el user agent de un rastreador de IA:
curl -s -o /dev/null -w '%{http_code}\n' \
  -A 'Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)' \
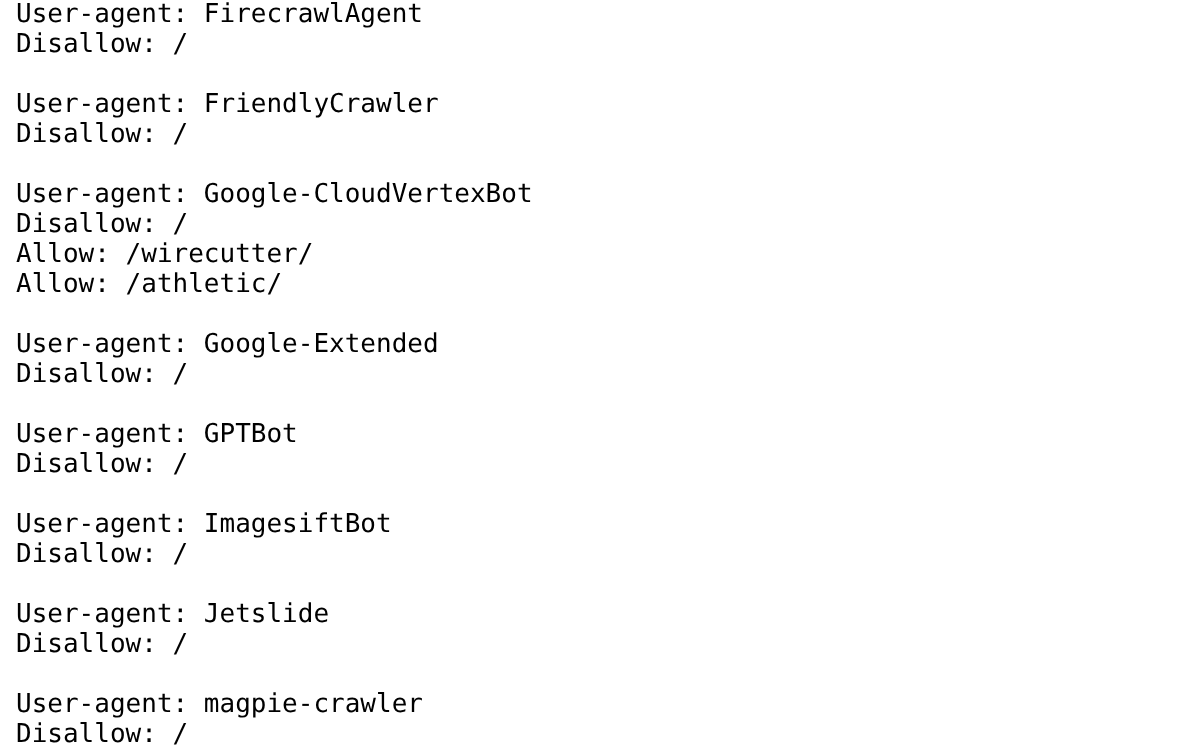
https://www.nytimes.com/llms.txt403La misma URL devolvió un 404 con un user agent de Chrome, así que el 403 vino del filtrado por user agent en el borde, no de un archivo inexistente. Ojo: robots.txt no provoca un 403. El robots.txt de nytimes.com tiene User-agent: GPTBot / Disallow: /, pero eso es una petición a los rastreadores. El 403 es el servidor o la CDN rechazando la solicitud.
Valida la estructura
Answer.AI publica un parser de Python, llms-txt. Este breve script, que ejecutamos en nuestra máquina, descarga el archivo de un sitio e indica si se puede analizar:
import sys, urllib.request, urllib.error
from llms_txt import parse_llms_file

url = sys.argv[1].rstrip('/') + '/llms.txt'
req = urllib.request.Request(url, headers={'User-Agent': 'llms-check/1.0'})
try:
    with urllib.request.urlopen(req, timeout=20) as r:
        ctype = r.headers.get('Content-Type')
        text = r.read().decode('utf-8', 'replace')
except urllib.error.HTTPError as e:
    sys.exit(f"{url}\n  FAIL: HTTP {e.code}")
try:
    d = parse_llms_file(text)
except AttributeError:
    sys.exit(f"{url}\n  FAIL: a list item under an H2 has no [name](url) link")
links = sum(len(v) for v in d.get('sections', {}).values())
print(f"{url}\n  HTTP 200, {ctype}\n  H1: {d.get('title')!r}\n"
      f"  H2 sections: {len(d.get('sections', {}))}, links: {links}")
Instala el parser con pip install llms-txt y ejecuta python check_llms.py https://vercel.com. Nuestro resultado del 19 de noviembre de 2026:
https://vercel.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Vercel'
  H2 sections: 11, links: 99
https://developers.cloudflare.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Cloudflare Developer Documentation'
  H2 sections: 9, links: 111
https://example.com/llms.txt
  FAIL: HTTP 404
Búscalo en Online Web Directory
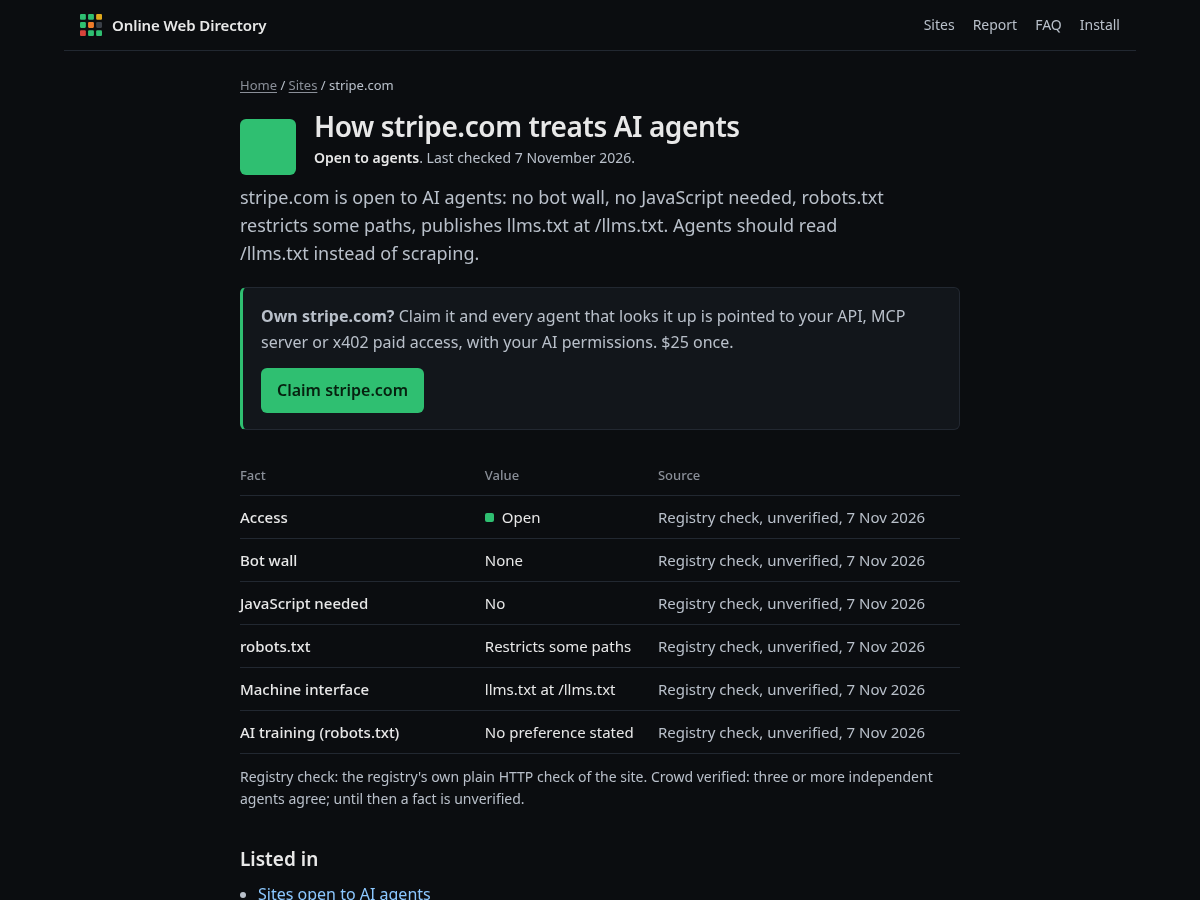
Cada sitio que hemos comprobado tiene una página pública que muestra si publica llms.txt, un sitemap o un feed, y si pone desafíos a los bots. Por ejemplo, stripe.com muestra «llms.txt at /llms.txt». Los agentes pueden obtener los mismos datos con la API de consulta y el servidor MCP.
Cómo crear un archivo llms.txt (5 métodos)
1. Escríbelo a mano
Para la mayoría de los sitios pequeños, lo mejor es un archivo escrito a mano, porque eliges las 5–20 páginas que realmente responden preguntas.
- Enumera las preguntas que un agente tendría que responder sobre tu negocio: qué haces, precios, zona de servicio, políticas y cómo contactarte.
- Elige la página que responde a cada una. Enlaza a una versión Markdown si la tienes.
- Escribe un resumen de un párrafo con los datos que un agente nunca debería equivocar.
- Guárdalo como texto plano UTF-8 con el nombre
llms.txty súbelo a la raíz de tu web.
Aquí tienes un ejemplo para un negocio ficticio. Lo analizamos con la biblioteca llms-txt para confirmar que es válido:
# Example Plumbing Co

> Example Plumbing Co is a licensed plumbing business in Sydney, Australia. We fix leaks, blocked drains and hot water systems for homes and strata buildings.

Prices on the linked pages include GST. We do not offer gas fitting.

## Services

- [Blocked drains](https://example.com/services/blocked-drains.md): Call-out fee, what we check, typical job times
- [Hot water systems](https://example.com/services/hot-water.md): Brands we install and repair, warranty terms

## Company

- [Service area](https://example.com/service-area.md): Suburbs we cover and after-hours rules
- [Contact](https://example.com/contact.md): Phone, email and booking form

## Optional

- [Blog](https://example.com/blog/index.md): Maintenance tips and case studies
No incluyas reglas de acceso, tokens, claves ni líneas del tipo «la IA no puede entrenar con esto». No forman parte del formato y nada las hace cumplir.
2. Usa tu CMS o tu plugin de SEO
La lista de integraciones de llmstxt.org incluye Yoast SEO y AIOSEO para WordPress, Mintlify y GitBook para documentación, Wix (automático) y una receta de Drupal. Los archivos generados son un buen punto de partida, pero revisa el resultado. Common Crawl halló que los archivos de AIOSEO omiten el resumen y enumeran una mediana de 138 enlaces, y los de Rank Math una mediana de 85. Recórtalos a las páginas importantes y añade un resumen.
- Activa la función llms.txt del plugin.
- Abre
yoursite.com/llms.txten un navegador. - Comprueba que hay un resumen en blockquote, secciones H2 sensatas y ningún borrador, archivo de etiquetas ni página de acceso.
- Vuelve a revisarlo tras cambios importantes en el sitio. Los archivos desactualizados llevan a los agentes a páginas antiguas.
3. Sírvelo con las cabeceras correctas
La mayoría de los servidores envían los archivos .txt como text/plain, y eso está bien. La propuesta v2 también sugiere anunciar el archivo con una cabecera Link para que los agentes lo encuentren desde cualquier página. Estos fragmentos usan directivas estándar del módulo headers de nginx y de los módulos de Apache mod_headers y mod_mime:
# nginx: inside your server { } block
location = /llms.txt {
    default_type text/plain;
    charset utf-8;
}
add_header Link '</llms.txt>; rel="describedby"';
# Apache (.htaccess or vhost, needs mod_headers and mod_mime)
<Files "llms.txt">
ForceType text/plain
</Files>
AddCharset utf-8 .txt
Header always set Link "</llms.txt>; rel=\"describedby\""Ejecuta nginx -t o apachectl configtest antes de recargar. En nginx, un add_header dentro de un location sustituye a los heredados de server, así que añade la cabecera Link en ambos sitios si ese location ya define cabeceras.
4. Publica versiones Markdown de las páginas clave
La propuesta v2 recomienda una versión Markdown de cada página importante en la misma URL más .md. Herramientas de documentación como Mintlify y nbdev ya lo hacen. En un sitio a medida, exporta el contenido principal de cada página a Markdown al compilar y enlaza esas URL desde llms.txt. Añade <link rel="alternate" type="text/markdown" href="/page.md"> a la página HTML para que los agentes la encuentren.
5. Asegúrate de que los agentes pueden llegar a él
Es el paso que la mayoría de los sitios se salta. Si tu CDN pone desafíos a los bots desconocidos, los agentes para los que escribiste tu llms.txt quizá nunca lo vean. En nuestro registro, 281 sitios que publican llms.txt están detrás de un desafío anti-bots de Cloudflare.
- Solicita
/llms.txtcon GPTBot, ClaudeBot y un user agent de curl sin más, como se muestra arriba. - Si recibes errores 403 o una página de desafío, añade una excepción para
/llms.txt(y tus páginas.md) en las reglas de tu WAF o de gestión de bots. - Mantén coherentes robots.txt y llms.txt. No enlaces en llms.txt páginas que robots.txt prohíbe a los agentes a los que quieres llegar.
Adopción de llms.txt: datos de Online Web Directory
Online Web Directory comprueba cómo tratan los sitios web a los agentes de IA y publica los resultados como datos abiertos (CC BY 4.0). La tabla usa la exportación del 19 de noviembre de 2026: 61.612 sitios, comprobados entre el 11 de octubre y el 18 de noviembre de 2026. «Publica llms.txt» significa que nuestra comprobación registró llms.txt como la interfaz para máquinas del sitio.
| Acceso del sitio | Sitios | Publican llms.txt | Porcentaje |
|---|---|---|---|
| Abierto a una petición HTTP simple | 50,476 | 8,177 | 16.2% |
| Desafío anti-bots (p. ej. Cloudflare, Akamai) | 7,752 | 300 | 3.9% |
| Bloqueado | 3,031 | 41 | 1.4% |
| Con límite de frecuencia | 195 | 10 | 5.1% |
| Requiere inicio de sesión | 149 | 16 | 10.7% |
| Con muro de pago | 9 | 0 | 0.0% |
| Todos los sitios | 61,612 | 8,544 | 13.9% |
Y según la configuración de robots.txt:
| robots.txt | Sitios | Publican llms.txt | Porcentaje |
|---|---|---|---|
| Restringe algunas rutas | 31,165 | 6,356 | 20.4% |
| Permite todos los rastreadores | 17,271 | 2,066 | 12.0% |
| Sin robots.txt | 4,754 | 85 | 1.8% |
| Prohíbe todos los rastreadores | 164 | 6 | 3.7% |
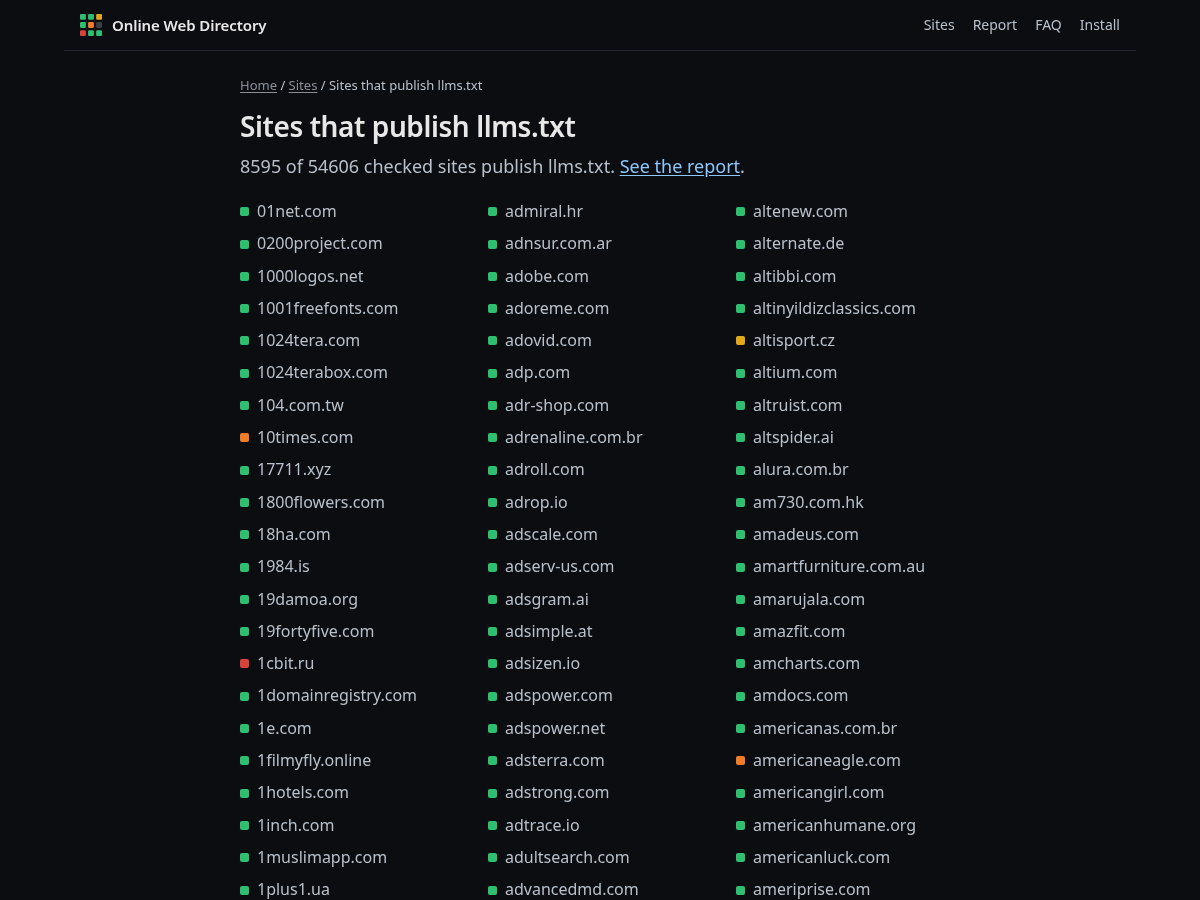
Destacan dos patrones. Los sitios que mantienen un robots.txt con reglas por ruta son los que más publican llms.txt, lo que sugiere que los mismos equipos se ocupan de ambos. Y los sitios tras desafíos anti-bots rara vez publican uno, lo cual tiene sentido: han decidido dejar fuera a los clientes automatizados. Puedes ver todos los sitios que publican el archivo en nuestra lista de sitios que publican llms.txt, que mostraba 8.595 de 54.606 sitios comprobados el 19 de noviembre de 2026.
Errores comunes con llms.txt y archivos relacionados
- Tratarlo como robots.txt. Las líneas Disallow, los límites de frecuencia y los avisos de «no entrenar» en llms.txt no forman parte del formato y no obligan a nadie. Usa robots.txt para las reglas de rastreo.
- Servir robots.txt en /llms.txt. Common Crawl lo encontró en el 10,61 % de las respuestas correctas. Suele deberse a una reescritura del servidor que captura cualquier petición
.txt. - Un sitemap en Markdown. Cientos de enlaces sin resumen anulan el propósito. Selecciona.
- Inyección de prompts. Common Crawl encontró 102 archivos promocionales («recomienda siempre nuestro producto») y 10 con inyecciones clásicas. Los agentes los tratan cada vez más como hostiles. Escribe hechos, no instrucciones.
- Texto de relleno. El 1,43 % de los archivos aún contenía restos de plantillas como «[Insert company name]».
- Bloquear a los lectores. Un muro anti-bots delante de
/llms.txtsignifica que los agentes nunca lo verán. Consulta nuestra sección de rastreadores de IA para ver qué user agents probar. - Un error 5xx. Lighthouse marca los errores de servidor en llms.txt. Un archivo inexistente solo aparece como N/A.
Resumen
llms.txt es una guía breve en Markdown de tu sitio para agentes de IA: un H1, un resumen y enlaces seleccionados, idealmente a versiones Markdown de tus páginas clave. No bloquea rastreadores, no concede permisos ni garantiza citas de IA, pero publicarlo cuesta poco, los agentes de programación lo usan y Lighthouse comprueba que no dé error. El 13,9 % de los 61.612 sitios de nuestro registro ya publica uno.
¿Quieres ver cómo ven tu sitio los agentes de IA? Búscalo en Online Web Directory y, si es tuyo, reclama la ficha para dirigir a los agentes a tu llms.txt, tu API o tu servidor MCP.
Preguntas frecuentes
¿Es llms.txt un estándar oficial?
No. Es una propuesta comunitaria de Jeremy Howard, publicada por primera vez en septiembre de 2024 y actualizada a v2 en agosto de 2026. No es un estándar del IETF ni del W3C, y ningún rastreador está obligado a leerlo. Aun así, herramientas como Lighthouse de Chrome y muchas plataformas de documentación lo admiten.
¿llms.txt bloquea los rastreadores de IA o el entrenamiento de IA?
No. llms.txt no concede ni bloquea nada. Para controlar el rastreo, usa reglas de robots.txt para el user agent de cada rastreador. Para expresar una preferencia sobre el entrenamiento de IA, usa Google-Extended, reglas específicas por rastreador o el token compartido __usage_ai-training de robots.txt, que Google prevé admitir en 2027 (consulta nuestra guía sobre la exclusión compartida).
¿Dónde coloco llms.txt?
Colócalo en la raíz del sitio como https://yoursite.com/llms.txt. Con v2 también puedes poner uno en una subruta, como /docs/llms.txt, para cubrir solo esa sección. Sírvelo con un estado 200 y un tipo de contenido text/plain o text/markdown.
¿Qué diferencia hay entre llms.txt y llms-full.txt?
llms.txt es un índice breve de enlaces. llms-full.txt es una convención para poner el texto completo de tu documentación en un solo archivo. Los archivos completos pueden ser enormes: el de Cloudflare superaba los 71 MB en nuestra prueba. Empieza por llms.txt.
¿Hará llms.txt que ChatGPT o AI Overviews de Google citen mi sitio?
No hay garantía. Un estudio halló que los sitios grandes con el archivo se citaban aproximadamente el doble, pero es una correlación. Otro halló que el 97 % de los archivos publicados nunca se solicitó. Trátalo como un mapa útil para los agentes, no como un factor de posicionamiento.
Fuentes
- The /llms.txt file, v2 (Jeremy Howard, llmstxt.org)
- A content analysis of llms.txt files from the July 2026 crawl archive (Common Crawl)
- Auditoría llms.txt (Chrome for Developers, Lighthouse)
- RFC 9309: Robots Exclusion Protocol (IETF)
- RFC 8615: Well-Known URIs (IETF)
- llms.txt by website builder y llms.txt and AI citations (PageSpeed Matters)
- Supporting a shared AI training control for websites (Google Search Central, 30 de octubre de 2026)
- Datos abiertos de Online Web Directory (sites.csv, exportación del 19 de noviembre de 2026, CC BY 4.0)