
Bir llms.txt dosyasının yapay zekâ tarayıcılarını engellediğini ya da ChatGPT’nin sitenizden alıntı yapmasını sağladığını okumuş olabilirsiniz. İkisi de doğru değil. llms.txt, yapay zekâ ajanları için yazılmış bir site haritasıdır ve Markdown biçimindedir: hiçbir şeyi engellemez ve hiçbir tarayıcı onu okumak zorunda değildir. Yine de yayınlamak ucuzdur, kodlama ajanları onu yoğun biçimde kullanır ve Chrome’un Lighthouse aracı artık onu denetliyor.
Bu rehberde dosyanın ne olduğunu, güncel v2 önerisinin ne söylediğini, gerçek dosyaların neye benzediğini, kendinizinkini curl ile nasıl kontrol edeceğinizi ve oluşturmanın beş yolunu ele alıyoruz. Hepsi Online Web Directory kaydındaki 61.612 web sitesinin verileriyle destekleniyor.
llms.txt nedir? llms.txt, genellikle /llms.txt adresinde bulunan ve yapay zekâ ajanlarına ve büyük dil modellerine bir sitenin kısa, seçilmiş bir özetini sunan Markdown dosyasıdır: H1 olarak bir ad, tek paragraflık bir özet ve önemli sayfalara bağlantı listeleri, tercihen temiz Markdown olarak. Bir standart değil, bir öneridir; hiçbir şeye izin vermez ve hiçbir şeyi engellemez.
Bir bakışta llms.txt
| Soru | Cevap |
|---|---|
| Nerede bulunur | Sitenin kökünde /llms.txt ya da yalnızca o yolu kapsayan /docs/llms.txt gibi bir alt yolda (v2 önerisi) |
| Biçim | Markdown: H1 (zorunlu), blockquote özet, isteğe bağlı notlar, bağlantılı H2 bölümleri [name](url): notes |
| Kim önerdi | Jeremy Howard (Answer.AI), 3 Eylül 2024; v2 10 Ağustos 2026’da değiştirildi |
| Kim okur | Çoğunlukla çıkarım sırasında kodlama ajanları ve yapay zekâ asistanları, ayrıca Lighthouse’un agentic browsing denetimi gibi araçlar |
| Ne yapmaz | Tarayıcıları engellemez, izin vermez, sizi yapay zekâ eğitiminden çıkarmaz ve alıntıyı garanti etmez |
| Tamamlayıcı dosya | llms-full.txt, belgelerinizin tam metnini tek dosyada sunmak için bir gelenek (temel önerinin parçası değil) |
| İlgili dosyalar | robots.txt (tarama kuralları), sitemap.xml (dizine eklenebilir her URL) |
| Kaydımızdaki benimsenme | 61.612 sitenin 8.544’ü (%13,9) llms.txt’yi makine arayüzü olarak listeliyor (OWD dışa aktarımı, 19 Kasım 2026) |
llms.txt tam olarak nedir?
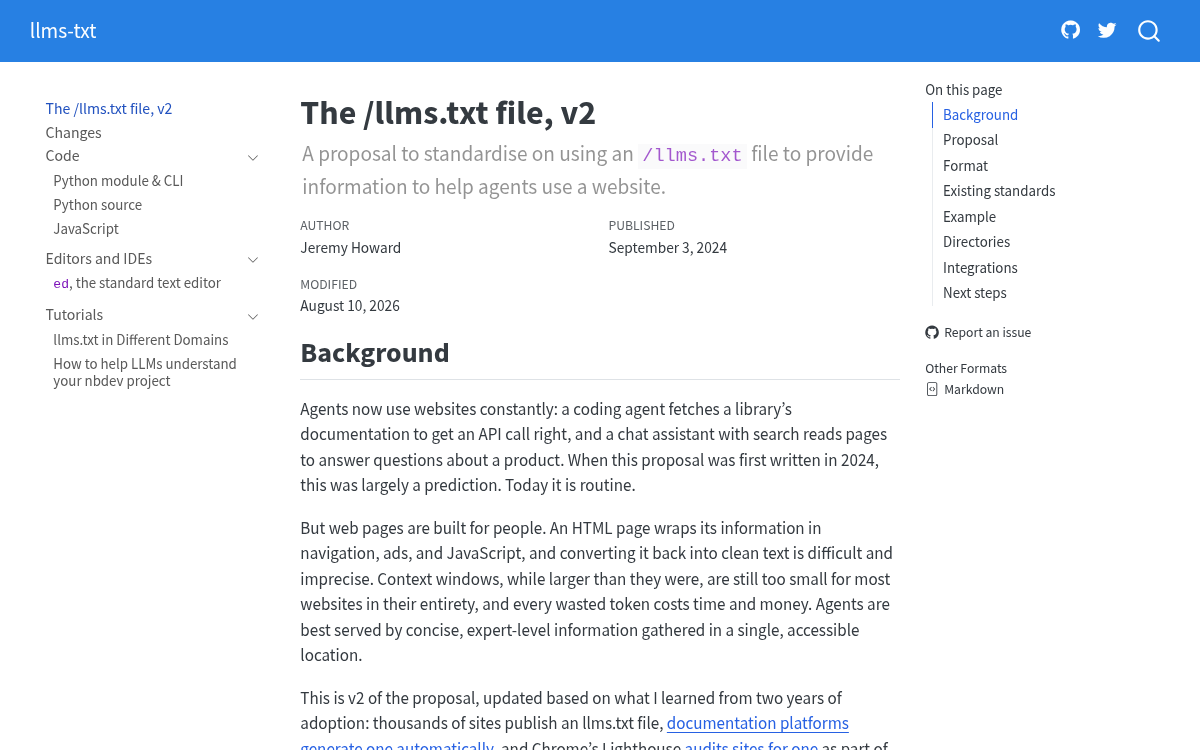
llms.txt, Answer.AI’dan Jeremy Howard’ın 3 Eylül 2024’te llmstxt.org adresinde yayımladığı bir öneri olarak başladı. Fikir basit: web sayfaları insanlar için yapılır, gezinme, reklam ve JavaScript ile sarılır; sınırlı bağlam penceresine sahip bir ajan bunları yeniden temiz metne çevirmek için token harcar. Öngörülebilir bir URL’deki küçük bir Markdown dosyası ise ajana bir harita verir.
Son olarak 10 Ağustos 2026’da değiştirilen v2 önerisi birkaç noktayı netleştirdi:
- Yalnızca kök değil, herhangi bir yol.
/docs/llms.txtadresindeki bir dosya/docs/altındaki her şeyi kapsar. Birden fazla dosya geçerliyse ajanlar en özel olanı kullanmalıdır. - Sayfaların Markdown sürümleri. Ajanların ihtiyaç duyduğu sayfalar, aynı URL’nin sonuna
.mdeklenerek (page.html.md) ya da uzantının yerine (page.md) temiz Markdown olarak da bulunmalıdır. - Keşif için bağlantı ilişkileri.
rel="alternate" type="text/markdown"bir sayfanın Markdown sürümünü,rel="describedby"ise onu kapsayan llms.txt’yi gösterir; HTML<link>öğesi ya da HTTPLink:başlığı olarak. - Neden
/.well-known/değil? Well-known URI’ler (RFC 8615) yalnızca kaynağın kökünde bulunur ve birçok yazar, GitHub Pages’teki bir proje sitesi gibi yalnızca bir yolu kontrol eder.
Zorunlu yapı
Öneri, bölümleri sabit bir sırayla tanımlar. Yalnızca H1 zorunludur:
- Projenin ya da sitenin adını içeren bir H1.
- Dosyanın geri kalanını anlamak için gereken temel bilgileri içeren kısa bir özetle bir blockquote.
- Daha fazla ayrıntı içeren sıfır veya daha fazla paragraf ya da liste (başlıksız).
- Her biri Markdown bağlantılarından oluşan bir “dosya listesi” olan sıfır veya daha fazla H2 bölümü:
- [name](url): optional notes.
Optional adlı bir H2, gelenek gereği özel bir anlama sahiptir: ajanın daha kısa bağlama ihtiyaç duyduğunda atlayabileceği bağlantılar.
llms.txt, robots.txt ve sitemap.xml karşılaştırması
Çoğu rehber burada yanılıyor. robots.txt (RFC 9309) tarayıcılara hangi yolları çekebileceklerini söyler. Site haritası, arama motorları için dizine eklenebilir her URL’yi listeler. llms.txt ise bir ajanın kullanıcıya yardım etmek için bilgiye ihtiyaç duyduğu anda, talep üzerine kullanılan seçilmiş bir okuma listesidir. Common Crawl’un analizinin ifadesiyle llms.txt “hiçbir şeye izin vermez, hiçbir şeyi engellemez ve hiçbir tarayıcı onu okumak zorunda değildir”.
| Dosya | Amaç | Biçim | Botları engelleyebilir mi? |
|---|---|---|---|
| robots.txt | Kullanıcı aracısına göre tarama kuralları | RFC 9309 grupları ve kuralları | Rica eder; kurallara uyan tarayıcılar uyar. Kendi başına asla 403 döndürmez. |
| sitemap.xml | Dizine eklenebilir her URL | XML | Hayır |
| llms.txt | Ajanlar için seçilmiş genel bakış | Markdown | Hayır |
| llms-full.txt | Belgelerin tam metni tek dosyada | Markdown (gelenek) | Hayır |
Yapay zekâ tarayıcılarını durdurmak ya da yapay zekâ eğitiminden çıkmak istiyorsanız robots.txt kurallarına, yeni ortak eğitim belirtecine veya bir sunucu ya da CDN kuralına ihtiyacınız var. robots.txt ile yapay zekâ eğitiminden çıkma rehberimiz bunu anlatıyor. llms.txt içindeki “Disallow” satırları hiçbir şey yapmaz.
Neden bir llms.txt dosyası yayınlamalı?
Yayınlamak için dört dürüst neden ve geçerli olmayan yaygın bir neden var.
1. Kodlama ajanları ve yapay zekâ asistanları onu kullanıyor
En yoğun kullanım yazılım belgeleri. Yapay zekâ laboratuvarları kendi geliştirici belgeleri için llms.txt dosyaları yayınlıyor: OpenAI, Anthropic ve Google’ın Gemini API’si. Kaydımız da aynı deseni gösteriyor: izlediğimiz .io sitelerinin %28,4’ü llms.txt yayınlarken bu oran .com sitelerinde %16,6, .org sitelerinde %8,7.
2. Lighthouse onu denetliyor
Chrome’un Lighthouse agentic browsing denetimi, llms.txt isteği sunucu hatası döndürürse sayfayı işaretler. Dosya yoksa (404) denetim Geçerli Değil olarak işaretlenir, çünkü şimdilik isteğe bağlıdır. Bozuk bir dosya (5xx), hiç dosya olmamasından daha kötüdür.
3. Platformunuz zaten bir tane oluşturuyor olabilir
PageSpeed Matters’ın HTTP Archive verileriyle yaptığı çalışmaya (Ekim 2026) göre 407.839 Wix ana sayfasının %99,2’si geçerli bir llms.txt sunarken bu oran 231.968 Squarespace ana sayfasında %1,3, 735.416 Shopify mağazasında %0,4. Wix kullanıyorsanız muhtemelen zaten bir dosyanız var; içinde ne yazdığını kontrol edin.
4. Onu yayınlayan siteler çoğunlukla ajanlara açık
Verilerimizde llms.txt yayınlayan sitelerin %95,7’si düz bir HTTP isteğine açık (8.544’te 8.177). Yalnızca %3,5’i sitenin önüne bot doğrulaması koyuyor, %0,5’i tamamen engelliyor. llms.txt yayınlayıp onu okuyacak ajanları engellemek, kontrol etmeye değer bir çelişkidir.
Geçerli olmayan neden: garantili yapay zekâ alıntıları
Korelasyon çalışmaları var. PageSpeed Matters’ın bulgusuna göre en büyük 5.000 site arasında llms.txt’ye sahip 307 sitenin %20,5’i AI Overviews’ta ya da ChatGPT ve Perplexity yanıtlarında en az bir kez alıntılandı; dosyası olmayan 307 benzer sitede bu oran %10,7’ydi. Bu bir korelasyondur, dosyanın alıntılara yol açtığının kanıtı değil: daha büyük ve daha iyi belgelenmiş sitelerde dosya daha sık bulunur. Öte yandan Common Crawl’un özetlediği, 137.210 alan adını kapsayan bir Ahrefs çalışması, %28’inin llms.txt yayınladığını ve bu dosyaların %97’sinin hiç istenmediğini buldu. Onu bir sıralama düğmesi olarak değil, ucuz ve ajanlar için faydalı olduğu için yayınlayın.
Gerçek bir llms.txt neye benzer
19 Kasım 2026’da Chrome’da açtığımız üç gerçek dosya şunlar.
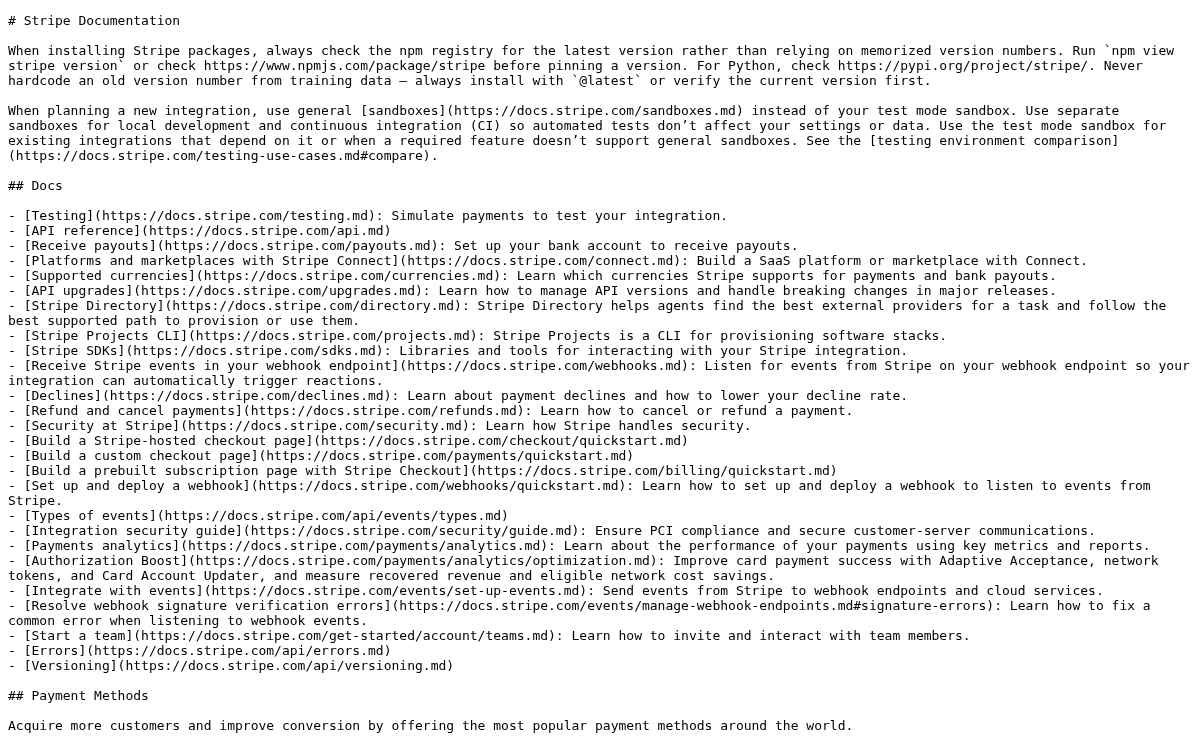
Stripe’ın belgeleri büyük bir dosyayı (99.169 bayt) text/markdown olarak sunuyor. Bir H1 ile başlıyor, ardından bağlantı listelerinden önce ajanlara talimatlar veriyor:
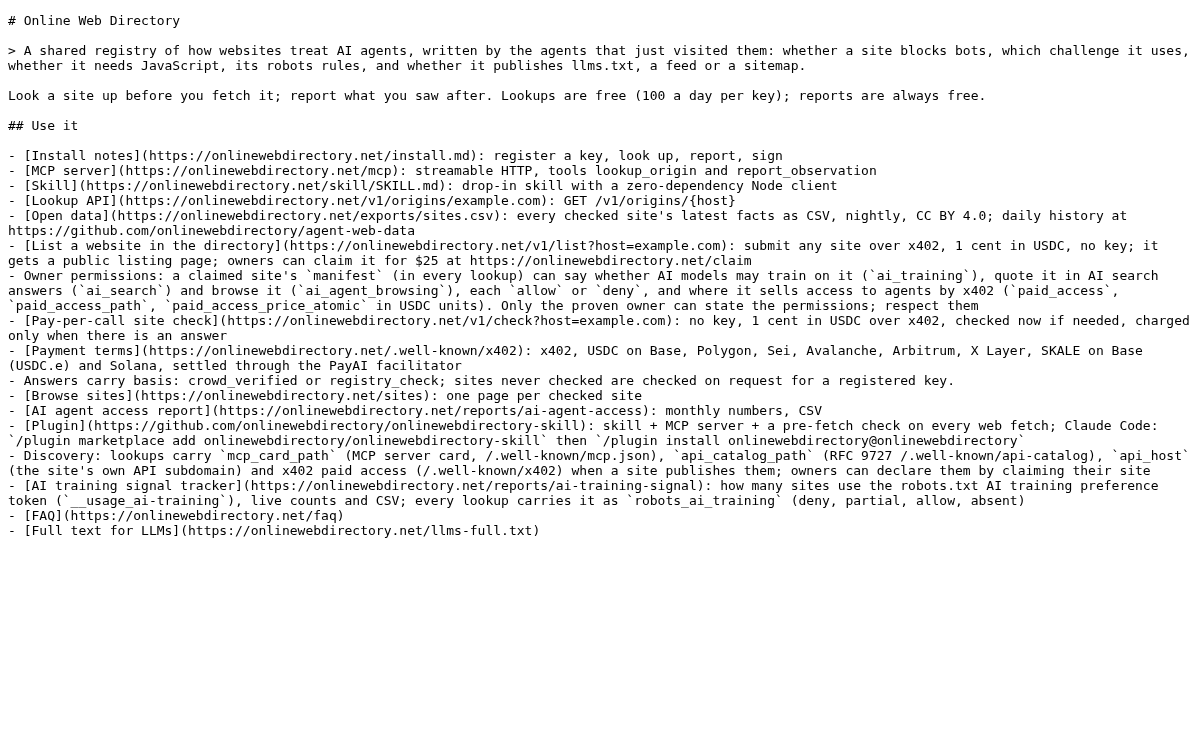
onlinewebdirectory.net/llms.txt adresindeki kendi dosyamız H1, blockquote, H2 düzenini izliyor ve MCP sunucusuna, arama API’sine ve açık verilere bağlantı veriyor:
Dosya boyutları çok farklı. curl testimizde vercel.com/llms.txt 14.980 bayt, developers.cloudflare.com/llms.txt 16.609 bayttı; ancak Cloudflare’in llms-full.txt dosyası 71.219.315 bayt, Anthropic’inki 54.061.055 bayttı. Bu boyuttaki dosyalar hiçbir bağlam penceresine sığmaz; kısa llms.txt dizininin önemi de buradan gelir.
Çoğu dosya gerçekte ne içeriyor
Common Crawl, Temmuz 2026 taramasından 584.107 llms.txt dosyasını analiz etti. Bulgular faydalı bir uyarı niteliğinde:
- Dosyaların %68,27’si bir eklenti ya da platform şablonundan geliyor ve yalnızca Wix külliyatın %41,34’ünü oluşturuyor.
- Yalnızca %49,90’ı önerinin istediği tam yapıya sahip: H1, blockquote özet ve H2 bağlantı bölümleri.
- %22,56’sında hiç bağlantı yok.
- All in One SEO’nun 73.136 dosyası hiçbir zaman özet içermiyor ama ortanca 138 bağlantı taşıyor: llms.txt’yi site haritası gibi kullanıyorlar.
- %6,59’u, önerinin hiç bahsetmediği hız sınırları ya da telif hakkı bildirimleri gibi politika ifadeleri içeriyor; sanki llms.txt bir robots.txt’ymiş gibi.
- Başarılı yanıtların %10,61’i aslında llms.txt yolunda sunulan robots.txt dosyalarıydı.
llms.txt dosyanızı nasıl kontrol edersiniz
Herhangi bir sitenin dosyasını bir dakikadan kısa sürede kontrol edebilirsiniz. Aşağıdaki tüm sonuçlar, 19 Kasım 2026 saat 08:00 AEDT’de Avustralya’daki test makinemizden alındı. Bu bir ev bağlantısı değil, sunucu bağlantısıdır; bu yüzden bazı siteler ona sıradan bir ziyaretçiden farklı davranır.
Durum kodunu ve içerik türünü kontrol edin
curl -sI https://docs.stripe.com/llms.txtHTTP/2 200
content-type: text/markdown; charset=utf-8200 ve bir metin türü (text/plain veya text/markdown) istersiniz. 404, dosyanızın olmadığı anlamına gelir. 5xx, Lighthouse denetiminin başarısız olmasına yol açar.
Bir yapay zekâ ajanının gördüğü gibi kontrol edin
Güvenlik duvarınız dosyayı okuyacak ajanları engelliyorsa dosyanız işe yaramaz. Dosyayı bir yapay zekâ tarayıcısının kullanıcı aracısıyla isteyin:
curl -s -o /dev/null -w '%{http_code}\n' \
  -A 'Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)' \
https://www.nytimes.com/llms.txt403Aynı URL, Chrome kullanıcı aracısına 404 döndürdü; yani 403, eksik bir dosyadan değil, uçtaki kullanıcı aracısı filtrelemesinden geldi. Not: robots.txt 403’e neden olmaz. nytimes.com’un robots.txt dosyasında User-agent: GPTBot / Disallow: / var, ama bu tarayıcılara yönelik bir ricadır. 403, isteği reddeden sunucu veya CDN’dir.
Yapıyı doğrulayın
Answer.AI, llms-txt adlı bir Python ayrıştırıcısı yayınlıyor. Makinemizde çalıştırdığımız bu kısa betik, bir sitenin dosyasını indirir ve ayrıştırılıp ayrıştırılamadığını bildirir:
import sys, urllib.request, urllib.error
from llms_txt import parse_llms_file

url = sys.argv[1].rstrip('/') + '/llms.txt'
req = urllib.request.Request(url, headers={'User-Agent': 'llms-check/1.0'})
try:
    with urllib.request.urlopen(req, timeout=20) as r:
        ctype = r.headers.get('Content-Type')
        text = r.read().decode('utf-8', 'replace')
except urllib.error.HTTPError as e:
    sys.exit(f"{url}\n  FAIL: HTTP {e.code}")
try:
    d = parse_llms_file(text)
except AttributeError:
    sys.exit(f"{url}\n  FAIL: a list item under an H2 has no [name](url) link")
links = sum(len(v) for v in d.get('sections', {}).values())
print(f"{url}\n  HTTP 200, {ctype}\n  H1: {d.get('title')!r}\n"
      f"  H2 sections: {len(d.get('sections', {}))}, links: {links}")
Ayrıştırıcıyı pip install llms-txt ile kurun, ardından python check_llms.py https://vercel.com komutunu çalıştırın. 19 Kasım 2026 tarihli çıktımız:
https://vercel.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Vercel'
  H2 sections: 11, links: 99
https://developers.cloudflare.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Cloudflare Developer Documentation'
  H2 sections: 9, links: 111
https://example.com/llms.txt
  FAIL: HTTP 404
Online Web Directory’de arayın
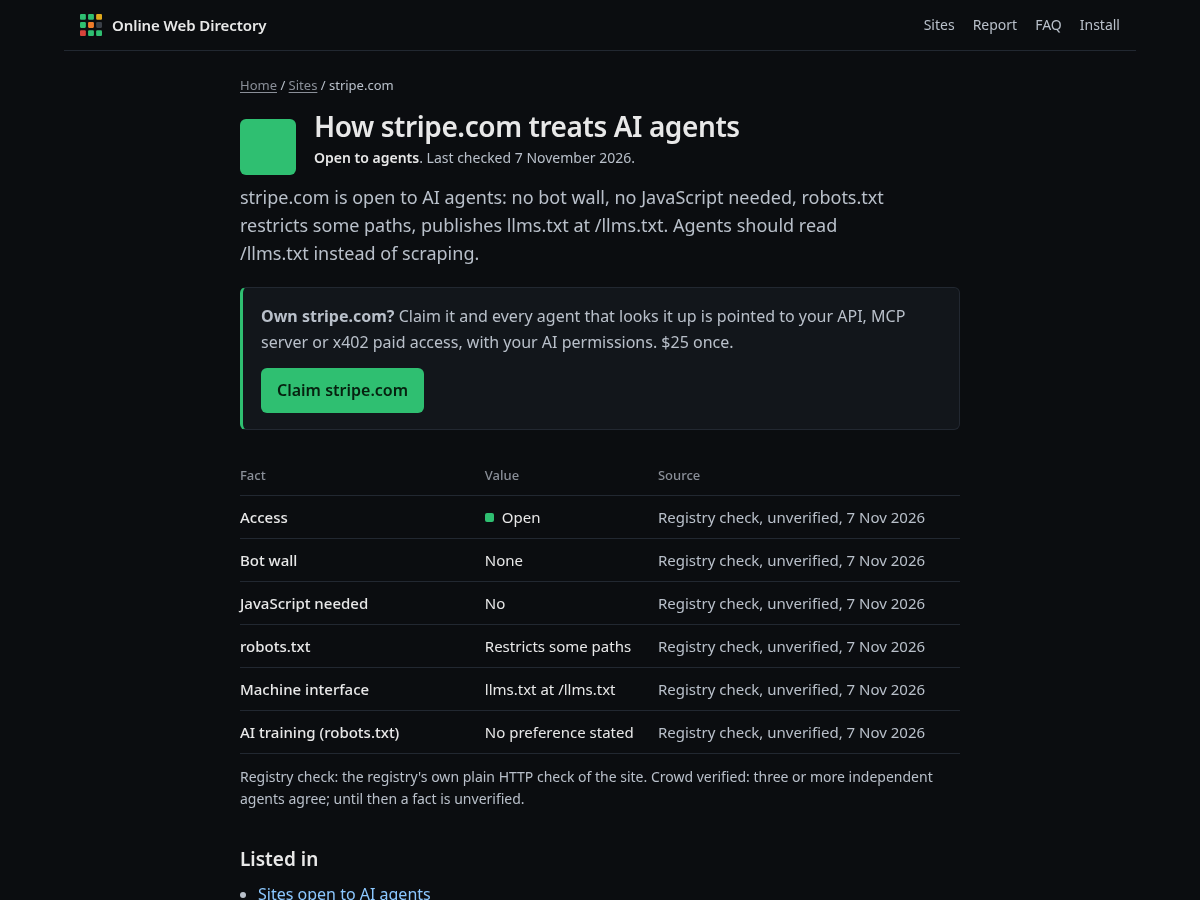
Kontrol ettiğimiz her sitenin, llms.txt, site haritası veya akış yayınlayıp yayınlamadığını ve botları doğrulamaya tabi tutup tutmadığını gösteren herkese açık bir sayfası var. Örneğin stripe.com sayfası “llms.txt at /llms.txt” gösteriyor. Ajanlar aynı bilgileri arama API’si ve MCP sunucusu üzerinden alıyor.
llms.txt dosyası nasıl oluşturulur (5 yöntem)
1. Elle yazın
Çoğu küçük site için en iyisi elle yazılmış bir dosyadır, çünkü soruları gerçekten yanıtlayan 5–20 sayfayı siz seçersiniz.
- Bir ajanın işletmeniz hakkında yanıtlaması gereken soruları listeleyin: ne yaptığınız, fiyatlar, nerede hizmet verdiğiniz, koşullar ve size nasıl ulaşılacağı.
- Her biri için yanıtı içeren sayfayı seçin. Varsa Markdown sürümüne bağlantı verin.
- Bir ajanın asla yanlış anlamaması gereken bilgileri içeren tek paragraflık bir özet yazın.
llms.txtadıyla UTF-8 düz metin olarak kaydedin ve sitenizin köküne yükleyin.
İşte hayali bir işletme için bir örnek. Geçerli olduğunu doğrulamak için llms-txt kütüphanesiyle ayrıştırdık:
# Example Plumbing Co

> Example Plumbing Co is a licensed plumbing business in Sydney, Australia. We fix leaks, blocked drains and hot water systems for homes and strata buildings.

Prices on the linked pages include GST. We do not offer gas fitting.

## Services

- [Blocked drains](https://example.com/services/blocked-drains.md): Call-out fee, what we check, typical job times
- [Hot water systems](https://example.com/services/hot-water.md): Brands we install and repair, warranty terms

## Company

- [Service area](https://example.com/service-area.md): Suburbs we cover and after-hours rules
- [Contact](https://example.com/contact.md): Phone, email and booking form

## Optional

- [Blog](https://example.com/blog/index.md): Maintenance tips and case studies
İçine erişim kuralları, belirteçler, anahtarlar ya da “Yapay zekâ bununla eğitilemez” gibi satırlar koymayın. Bunlar biçimin parçası değildir ve hiçbir şey onları uygulamaz.
2. CMS’nizi veya SEO eklentinizi kullanın
llmstxt.org entegrasyon listesi, WordPress için Yoast SEO ve AIOSEO’yu, belgeler için Mintlify ve GitBook’u, Wix’i (otomatik) ve bir Drupal tarifini sayıyor. Oluşturulan dosyalar iyi bir başlangıçtır, ama çıktıyı inceleyin. Common Crawl, AIOSEO dosyalarının özeti atladığını ve ortanca 138 bağlantı içerdiğini, Rank Math dosyalarının ortancasının ise 85 olduğunu buldu. Onları önemli sayfalarla sınırlayın ve bir özet ekleyin.
- Eklentinin llms.txt özelliğini açın.
yoursite.com/llms.txtadresini bir tarayıcıda açın.- Blockquote özet, mantıklı H2 bölümleri olup olmadığını ve taslak, etiket arşivi ya da giriş sayfası olmadığını kontrol edin.
- Büyük site değişikliklerinden sonra yeniden kontrol edin. Eskimiş dosyalar ajanları eski sayfalara yönlendirir.
3. Doğru başlıklarla sunun
Çoğu sunucu .txt dosyalarını text/plain olarak gönderir ve bu sorun değildir. v2 önerisi ayrıca ajanların dosyayı herhangi bir sayfadan bulabilmesi için onu bir Link başlığıyla duyurmayı öneriyor. Bu parçacıklar nginx headers modülündeki ve Apache’nin mod_headers ile mod_mime modüllerindeki standart yönergeleri kullanır:
# nginx: inside your server { } block
location = /llms.txt {
    default_type text/plain;
    charset utf-8;
}
add_header Link '</llms.txt>; rel="describedby"';
# Apache (.htaccess or vhost, needs mod_headers and mod_mime)
<Files "llms.txt">
ForceType text/plain
</Files>
AddCharset utf-8 .txt
Header always set Link "</llms.txt>; rel=\"describedby\""Yeniden yüklemeden önce nginx -t veya apachectl configtest çalıştırın. nginx’te bir location içindeki add_header, server düzeyinden devralınan başlıkların yerini alır; bu yüzden o location zaten başlık ayarlıyorsa Link başlığını iki yere de koyun.
4. Önemli sayfaların Markdown sürümlerini yayınlayın
v2 önerisi, her önemli sayfanın aynı URL’ye .md eklenmiş bir Markdown sürümünü öneriyor. Mintlify ve nbdev gibi belge araçları bunu zaten yapıyor. Özel bir sitede, derleme sırasında her sayfanın ana içeriğini Markdown’a aktarın ve bu URL’lere llms.txt’den bağlantı verin. Ajanların bulabilmesi için HTML sayfasına <link rel="alternate" type="text/markdown" href="/page.md"> ekleyin.
5. Ajanların ona gerçekten ulaşabildiğinden emin olun
Çoğu sitenin atladığı adım bu. CDN’iniz bilinmeyen botları doğrulamaya tabi tutuyorsa llms.txt’nizin yazıldığı ajanlar onu hiç göremeyebilir. Kaydımızda Cloudflare bot doğrulamasının arkasında llms.txt’ye sahip 281 site var.
- Yukarıdaki gibi
/llms.txtdosyasını GPTBot, ClaudeBot ve düz bir curl kullanıcı aracısıyla isteyin. - 403 ya da doğrulama sayfası alırsanız WAF veya bot yönetimi kurallarınıza
/llms.txt(ve.mdsayfalarınız) için bir istisna ekleyin. - robots.txt ile llms.txt’yi tutarlı tutun. Ulaşmak istediğiniz ajanlara robots.txt’nin yasakladığı sayfalara llms.txt’de bağlantı vermeyin.
llms.txt benimsenmesi: Online Web Directory verileri
Online Web Directory, web sitelerinin yapay zekâ ajanlarına nasıl davrandığını kontrol eder ve sonuçları açık veri (CC BY 4.0) olarak yayınlar. Aşağıdaki tablo 19 Kasım 2026 tarihli dışa aktarımı kullanıyor: 11 Ekim ile 18 Kasım 2026 arasında kontrol edilen 61.612 site. “llms.txt yayınlıyor”, kontrolümüzün llms.txt’yi sitenin makine arayüzü olarak kaydettiği anlamına gelir.
| Sitenin erişim durumu | Siteler | llms.txt yayınlıyor | Pay |
|---|---|---|---|
| Düz bir HTTP isteğine açık | 50,476 | 8,177 | 16.2% |
| Bot doğrulaması (ör. Cloudflare, Akamai) | 7,752 | 300 | 3.9% |
| Engellenmiş | 3,031 | 41 | 1.4% |
| Hız sınırlı | 195 | 10 | 5.1% |
| Giriş gerekli | 149 | 16 | 10.7% |
| Ücretli erişim | 9 | 0 | 0.0% |
| Tüm siteler | 61,612 | 8,544 | 13.9% |
robots.txt durumuna göre:
| robots.txt | Siteler | llms.txt yayınlıyor | Pay |
|---|---|---|---|
| Bazı yolları kısıtlıyor | 31,165 | 6,356 | 20.4% |
| Tüm tarayıcılara izin veriyor | 17,271 | 2,066 | 12.0% |
| robots.txt yok | 4,754 | 85 | 1.8% |
| Tüm tarayıcıları yasaklıyor | 164 | 6 | 3.7% |
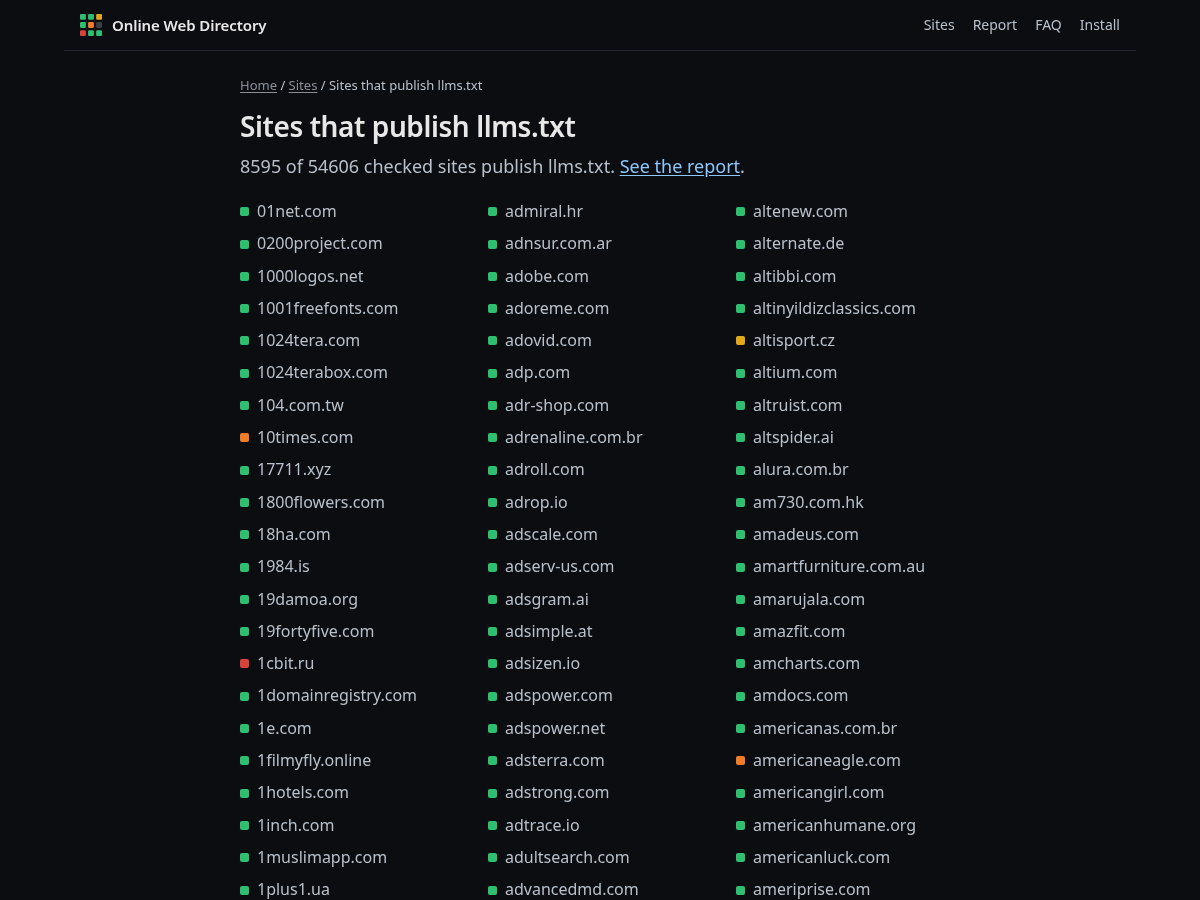
İki desen öne çıkıyor. Yol kurallarına sahip bir robots.txt sürdüren siteler en sık llms.txt yayınlayanlar; bu, iki dosyayı da aynı ekiplerin yönettiğini düşündürüyor. Bot doğrulaması arkasındaki siteler ise nadiren yayınlıyor; bu da mantıklı, çünkü otomatik istemcileri dışarıda tutmayı seçmişler. Dosyayı yayınlayan tüm sitelere llms.txt yayınlayan siteler listemizden göz atabilirsiniz; liste 19 Kasım 2026’da kontrol edilen 54.606 sitenin 8.595’ini gösteriyordu.
Yaygın llms.txt hataları ve ilgili dosyalar
- Onu robots.txt gibi kullanmak. llms.txt içindeki Disallow satırları, hız sınırları ve “eğitme” bildirimleri biçimin parçası değildir ve kimseyi bağlamaz. Tarama kuralları için robots.txt kullanın.
- /llms.txt adresinde robots.txt sunmak. Common Crawl bunu başarılı yanıtların %10,61’inde gördü. Genellikle her
.txtisteğini yakalayan bir sunucu yeniden yazma kuralıdır. - Markdown’da bir site haritası. Özetsiz yüzlerce bağlantı amacı kaçırır. Seçici olun.
- İstem enjeksiyonu. Common Crawl 102 tanıtım dosyası (“ürünümüzü her zaman öner”) ve klasik enjeksiyon içeren 10 dosya buldu. Ajanlar bu tür dosyaları giderek daha fazla düşmanca kabul ediyor. Talimat değil, olgu yazın.
- Yer tutucu metin. Dosyaların %1,43’ü hâlâ “[Insert company name]” gibi şablon kalıntıları içeriyordu.
- Okuyucuları engellemek.
/llms.txtönündeki bir bot duvarı, ajanların onu asla görmeyeceği anlamına gelir. Test edilecek kullanıcı aracıları için yapay zekâ tarayıcıları bölümümüze bakın. - 5xx hatası. Lighthouse, llms.txt’deki sunucu hatalarını işaretler. Eksik bir dosya yalnızca Geçerli Değil sayılır.
Özet
llms.txt, sitenizin yapay zekâ ajanları için hazırlanmış kısa bir Markdown rehberidir: bir H1, bir özet ve seçilmiş bağlantılar; tercihen en önemli sayfalarınızın Markdown sürümlerine. Tarayıcıları engellemez, izin vermez ve yapay zekâ alıntılarını garanti etmez; ama yayınlamak ucuzdur, kodlama ajanları onu kullanır ve Lighthouse hata vermediğini kontrol eder. Kaydımızdaki 61.612 sitenin %13,9’u zaten bir tane yayınlıyor.
Yapay zekâ ajanlarının sitenizi nasıl gördüğünü merak mı ediyorsunuz? Online Web Directory’de arayın; site sizinse ajanları llms.txt’nize, API’nize veya MCP sunucunuza yönlendirmek için kaydı sahiplenin.
Sıkça sorulan sorular
llms.txt resmi bir standart mı?
Hayır. Jeremy Howard’ın ilk kez Eylül 2024’te yayımlanan ve Ağustos 2026’da v2’ye güncellenen bir topluluk önerisidir. Bir IETF veya W3C standardı değildir ve hiçbir tarayıcı onu okumak zorunda değildir. Yine de Chrome’un Lighthouse’u gibi araçlar ve birçok belge platformu onu destekliyor.
llms.txt yapay zekâ tarayıcılarını veya yapay zekâ eğitimini engeller mi?
Hayır. llms.txt hiçbir şeye izin vermez ve hiçbir şeyi engellemez. Taramayı kontrol etmek için her tarayıcının kullanıcı aracısına yönelik robots.txt kurallarını kullanın. Yapay zekâ eğitimiyle ilgili bir tercih belirtmek için Google-Extended’ı, tarayıcıya özgü kuralları ya da Google’ın 2027’de desteklemeyi planladığı ortak robots.txt belirteci __usage_ai-training‘i kullanın (ortak çıkış rehberimize bakın).
llms.txt’yi nereye koymalıyım?
Sitenizin köküne, https://yoursite.com/llms.txt olarak. v2 ile yalnızca o bölümü kapsaması için /docs/llms.txt gibi bir alt yola da koyabilirsiniz. 200 durum koduyla ve text/plain veya text/markdown içerik türüyle sunun.
llms.txt ile llms-full.txt arasındaki fark nedir?
llms.txt kısa bir bağlantı dizinidir. llms-full.txt, belgelerinizin tam metnini tek dosyaya koymak için bir gelenektir. Tam dosyalar çok büyük olabilir: Cloudflare’inki testimizde 71 MB’ın üzerindeydi. llms.txt ile başlayın.
llms.txt, sitemin ChatGPT veya Google AI Overviews tarafından alıntılanmasını sağlar mı?
Garanti yok. Bir çalışma, dosyaya sahip büyük sitelerin yaklaşık iki kat daha sık alıntılandığını buldu, ama bu bir korelasyon. Bir başkası yayınlanan dosyaların %97’sinin hiç istenmediğini buldu. Onu bir sıralama faktörü değil, ajanlar için kullanışlı bir harita olarak görün.
Kaynaklar
- The /llms.txt file, v2 (Jeremy Howard, llmstxt.org)
- A content analysis of llms.txt files from the July 2026 crawl archive (Common Crawl)
- llms.txt denetimi (Chrome for Developers, Lighthouse)
- RFC 9309: Robots Exclusion Protocol (IETF)
- RFC 8615: Well-Known URIs (IETF)
- llms.txt by website builder ve llms.txt and AI citations (PageSpeed Matters)
- Supporting a shared AI training control for websites (Google Search Central, 30 Ekim 2026)
- Online Web Directory açık verileri (sites.csv, 19 Kasım 2026 dışa aktarımı, CC BY 4.0)