

A maioria das “listas de crawlers de IA” que você encontra foi copiada uma da outra, e muitas estão desatualizadas. Elas ainda citam Claude-Web como o crawler da Anthropic, inventam um bot “Googlebot-Extended” ou dizem que o Google-Extended rastreia suas páginas. Não rastreia. O Google-Extended não tem user agent próprio; é apenas um token do robots.txt.
Esta lista é diferente em dois pontos. Cada user agent abaixo foi conferido na documentação do próprio operador, em 20 de novembro de 2026. E medimos como sites reais tratam esses bots: baixamos o robots.txt de 3.000 sites escolhidos aleatoriamente no registro do Online Web Directory e contamos quais crawlers de IA eles citam e bloqueiam. Você também recebe regras testadas para robots.txt, Nginx e Apache, além de um script que verifica se um visitante “GPTBot” vem mesmo da OpenAI.
O que é uma lista de crawlers de IA? Uma lista de crawlers de IA é uma referência dos bots que as empresas de IA usam para buscar páginas da web, com o token de robots.txt de cada bot, sua string de user agent e sua função: coletar dados de treinamento, indexar páginas para a busca com IA ou buscar uma página ao vivo porque um usuário pediu. Ela serve para escrever regras de robots.txt, ler logs do servidor e definir políticas de firewall.
Crawlers de IA em resumo
| Pergunta | Resposta curta |
|---|---|
| Quantos crawlers de IA importam? | Cerca de 20 user agents documentados de 9 operadores (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), além do DuckDuckGo e de uma cauda longa de bots menores. |
| Tipos principais | Crawlers de treinamento, crawlers de busca com IA e fetchers ou agentes acionados pelo usuário. Google-Extended e Applebot-Extended são tokens de controle, não crawlers. |
| Eles obedecem ao robots.txt? | Os crawlers de treinamento e de busca documentados dizem que sim. Os fetchers acionados pelo usuário (ChatGPT-User, Perplexity-User, os fetchers acionados pelo usuário do Google, Meta-ExternalFetcher) dizem que o robots.txt pode não se aplicar. |
| O robots.txt pode gerar um 403? | Não. O robots.txt é um pedido, não uma tranca. Um 403 vem do seu servidor, da sua CDN ou do seu firewall. |
| Com que frequência os sites os bloqueiam? | Na nossa amostra de 20 nov. 2026, 16,9% dos arquivos robots.txt bloqueiam totalmente o GPTBot, mas só 2,8% bloqueiam totalmente o OAI-SearchBot. |
| Como verifico um bot? | Compare o IP da requisição com a lista de IPs publicada pelo operador (por exemplo https://openai.com/gptbot.json). User agents são fáceis de falsificar. |
A lista de crawlers de IA (verificada em novembro de 2026)
A tabela mostra cada token de robots.txt, quem o opera, o que ele faz segundo o operador e se o operador diz que ele segue o robots.txt. “Tipo” usa três categorias: treinamento (coleta conteúdo que pode treinar modelos), busca (indexa páginas para que um produto de IA possa citá-las depois) e usuário (busca uma página em tempo real porque uma pessoa pediu). Deixamos de fora bots cujo operador não publica documentação que pudéssemos verificar.
| Token de robots.txt | Operador | Tipo | O que faz | Segue o robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Treinamento | Rastreia conteúdo que pode ser usado para treinar os modelos de base da OpenAI. | Sim |
OAI-SearchBot |
OpenAI | Busca | Indexa páginas para que possam aparecer nos resultados de busca do ChatGPT. | Sim |
ChatGPT-User |
OpenAI | Usuário | Visita uma página quando um usuário do ChatGPT ou de um Custom GPT faz uma pergunta. | “Pode não se aplicar” |
OAI-AdsBot |
OpenAI | Verificação de anúncios | Verifica landing pages enviadas como anúncios do ChatGPT; não é usado para treinamento. | Só visita páginas enviadas |
ClaudeBot |
Anthropic | Treinamento | Coleta conteúdo da web que pode contribuir para treinar os modelos Claude. | Sim, e respeita Crawl-delay |
Claude-SearchBot |
Anthropic | Busca | Indexa conteúdo para melhorar os resultados de busca do Claude. | Sim |
Claude-User |
Anthropic | Usuário | Busca páginas quando um usuário do Claude faz uma pergunta. | Sim, segundo a Anthropic |
Google-Extended |
Token de controle | Decide se o conteúdo rastreado pelo Google pode treinar o Gemini ou embasar respostas do Gemini. Não é um crawler separado. | Só token | |
Google-CloudVertexBot |
Solicitado pelo dono | Rastreia sites cujos donos criam Vertex AI Agents; não afeta a Pesquisa Google. | Sim | |
Google-Agent |
Usuário | Agentes na infraestrutura do Google que navegam e agem a pedido de um usuário. | Acionado pelo usuário: em geral, não | |
PerplexityBot |
Perplexity | Busca | Indexa páginas para os resultados de busca do Perplexity; não é usado para treinamento. | Sim |
Perplexity-User |
Perplexity | Usuário | Busca uma página durante a sessão de um usuário no Perplexity. | “Em geral ignora” |
Applebot-Extended |
Apple | Token de controle | Decide se páginas rastreadas pelo Applebot podem treinar os modelos de base da Apple. Não rastreia. | Só token |
meta-externalagent |
Meta | Treinamento | Rastreia para usos como treinar modelos de IA ou indexar conteúdo. | Sim |
meta-externalfetcher |
Meta | Usuário | Busca links específicos a pedido de um usuário, inclusive em tarefas de agentes. | “Pode ignorar” |
Amazonbot |
Amazon | Treinamento | Melhora produtos e serviços da Amazon; pode ser usado para treinar modelos de IA da Amazon. | Sim |
Amzn-SearchBot |
Amazon | Busca | Indexa páginas para experiências de busca como a Alexa; não é usado para treinamento. | Sim |
Amzn-User |
Amazon | Usuário | Busca informações ao vivo para responder a um usuário, por exemplo uma pergunta à Alexa. | “Pode não seguir todas” |
CCBot |
Common Crawl | Dados de treinamento | Constrói o arquivo aberto da web do Common Crawl, uma fonte comum de dados de treinamento de IA. | Sim |
MistralAI-Training |
Mistral AI | Treinamento | Rastreia conteúdo para montar conjuntos de dados de treinamento dos modelos da Mistral. | Sim |
MistralAI-Index |
Mistral AI | Busca | Indexa conteúdo para a busca da Mistral; não é usado para treinamento. | Sim |
MistralAI-User |
Mistral AI | Usuário | Visita uma página quando um usuário faz uma pergunta ao Vibe, o assistente da Mistral. | Sim, para pedidos de usuários |
DuckAssistBot |
DuckDuckGo | Busca | Rastreia páginas em tempo real para as respostas assistidas por IA do DuckDuckGo. | Sim (vale após 72 horas) |
As fontes de cada linha estão no fim do artigo. As citações da última coluna vêm direto da documentação do operador. O Bytespider (ByteDance) ficou de fora de propósito: não encontramos nenhuma página da ByteDance que o documente, embora 18,5% dos arquivos robots.txt da nossa amostra o citem. Pelo mesmo motivo não descrevemos a cauda longa de tokens como cohere-ai, Diffbot ou omgili; a frequência com que os sites os citam está na seção de dados.
Strings completas de user agent que você verá nos logs
O robots.txt usa o token curto, mas seus logs de acesso mostram a string completa. Estes são os exemplos publicados pelos operadores. Os números de versão mudam, então filtre pelo token, não pela string inteira.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
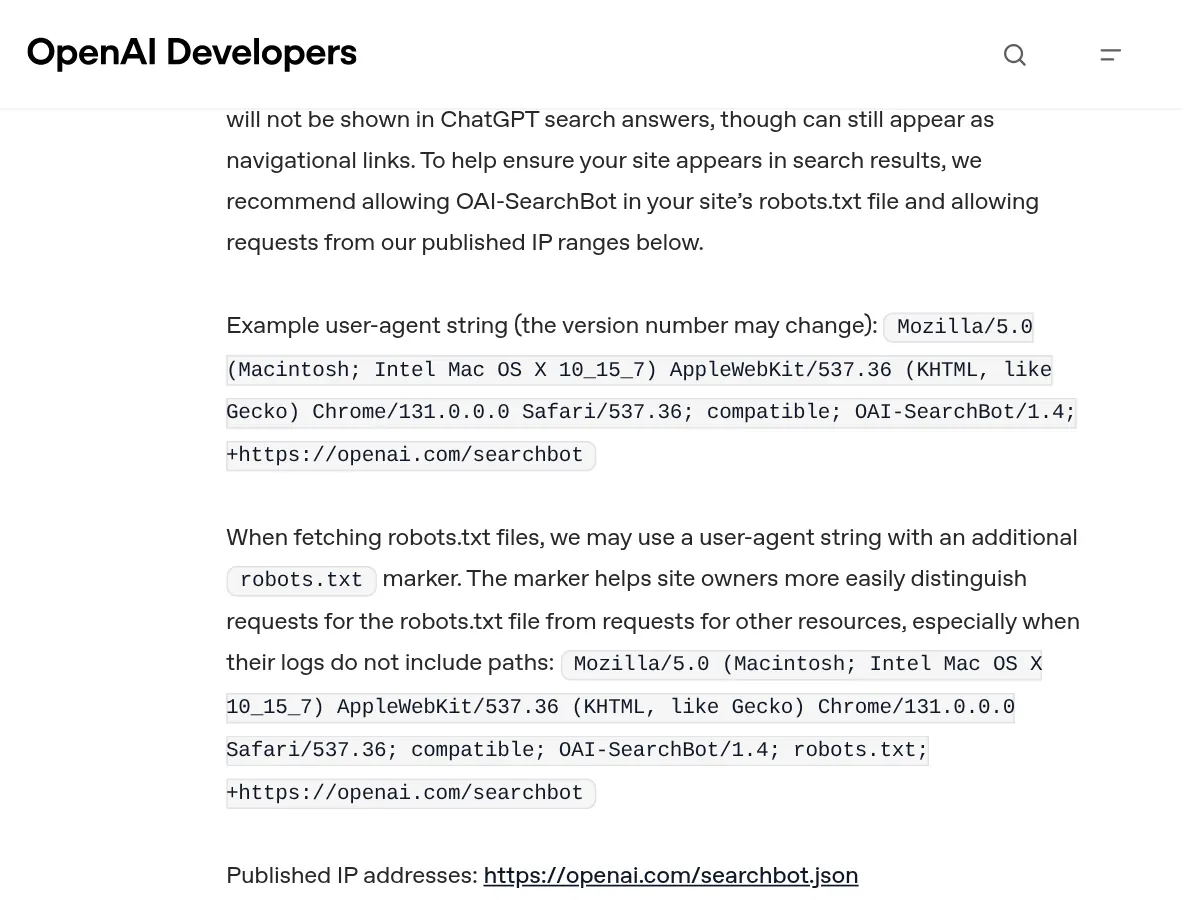
A OpenAI também observa que o GPTBot e o OAI-SearchBot podem acrescentar um marcador robots.txt ao user agent quando baixam seu robots.txt, para que você separe essas requisições em logs que não registram caminhos.
Três tipos de crawler de IA e por que a diferença importa
Bloquear “bots de IA” como um grupo só é o erro mais comum que vemos. Os três tipos têm custos e benefícios diferentes, e os operadores tratam o robots.txt de forma diferente em cada um.
Crawlers de treinamento
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot e MistralAI-Training coletam páginas que podem acabar em dados de treinamento de modelos. Bloqueá-los não tira você dos resultados de busca com IA da mesma empresa: a OpenAI diz que cada configuração de robots.txt dela é independente, então você pode bloquear o GPTBot e continuar permitindo o OAI-SearchBot. Na nossa amostra, os crawlers de treinamento são o grupo mais bloqueado. 17,3% dos arquivos robots.txt bloqueiam totalmente o CCBot, 16,9% o GPTBot e 15,9% o ClaudeBot.
Crawlers de busca com IA
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index e DuckAssistBot indexam páginas para que um assistente possa encontrá-las e citá-las depois. Bloqueá-los pode deixar você fora dessas respostas. Os donos de sites parecem saber disso: só 2,8% dos arquivos bloqueiam totalmente o OAI-SearchBot e 5,8% o PerplexityBot, contra 16,9% para o GPTBot.
Fetchers e agentes acionados pelo usuário
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User e Google-Agent agem por uma pessoa de cada vez, como um navegador faria. Vários operadores dizem que o robots.txt pode não se aplicar porque uma pessoa pediu a página. São também os bots usados por agentes de compras e reservas, então bloqueá-los pode afastar clientes reais. 5,9% dos arquivos da nossa amostra bloqueiam totalmente o ChatGPT-User.
Tokens de controle que não rastreiam
Google-Extended e Applebot-Extended nunca visitam seu site. Google e Apple rastreiam normalmente com o Googlebot e o Applebot e depois consultam esses tokens para decidir se o conteúdo pode treinar seus modelos. Segundo o Google, bloquear o Google-Extended não afeta a inclusão nem o ranking na Pesquisa Google. 14,1% dos arquivos analisados bloqueiam totalmente o Google-Extended e 13,5% o Applebot-Extended. O Google também disse que pretende aceitar o sinal compartilhado de treinamento de IA (user-agent: __usage_ai-training) no início de 2027; explicamos isso no nosso guia sobre o opt-out de treinamento de IA no robots.txt.
Tokens antigos que ainda enchem os arquivos robots.txt
A página de ajuda atual da Anthropic cita apenas ClaudeBot, Claude-User e Claude-SearchBot. Mesmo assim, 15,6% dos arquivos analisados ainda citam anthropic-ai e 13,8% citam Claude-Web. Regras para esses nomes não fazem mal, mas se forem suas únicas regras para a Anthropic, talvez não cubram os bots que a Anthropic documenta hoje. Confira se o ClaudeBot está citado explicitamente.
Como é o acesso dos crawlers de IA na prática
A documentação dos operadores é a fonte confiável sobre user agents. A página da OpenAI, por exemplo, lista cada bot com uma string de user agent de exemplo, notas sobre o marcador de robots.txt e um link para o arquivo de IPs publicado.
O que um site realmente faz com esses bots é outra história. Pedimos seis páginas iniciais a partir do nosso servidor com um user agent do Chrome, o user agent GPTBot da OpenAI e um user agent do ClaudeBot. Nosso servidor fica em um IP de data center, que muitas defesas contra bots tratam com desconfiança, então os resultados a partir de uma conexão doméstica podem ser diferentes.
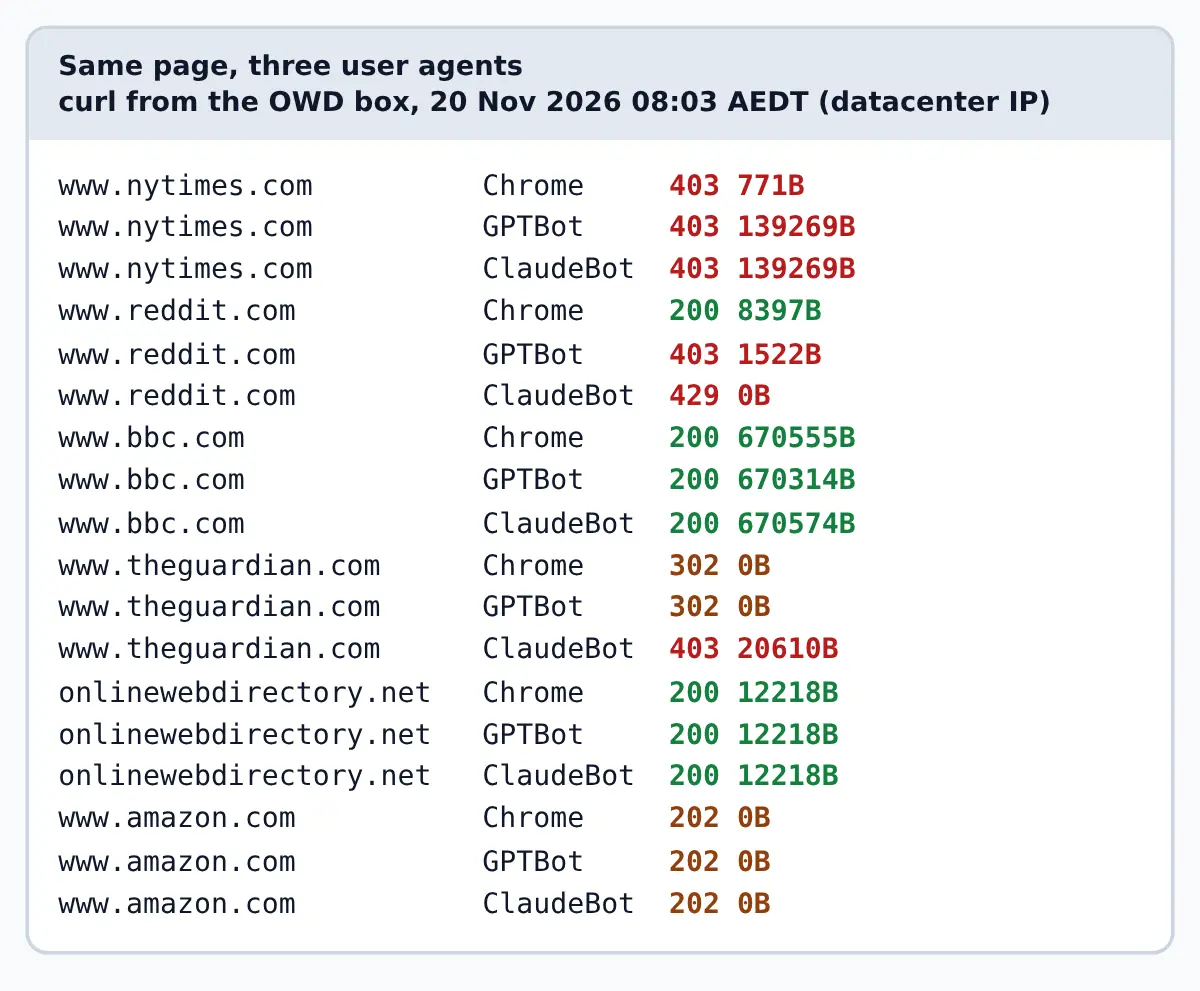
Aparecem três padrões. O Reddit atendeu o Chrome, mas devolveu 403 ao GPTBot e 429 ao ClaudeBot: filtragem por user agent no servidor ou na CDN. O New York Times devolveu 403 aos três, o que sugere que o bloqueio se baseou no nosso IP ou na impressão digital da requisição, não no user agent. E o bbc.com devolveu 200 ao GPTBot, embora seu robots.txt bloqueie GPTBot, ClaudeBot, CCBot, PerplexityBot e pelo menos outros cinco tokens de IA. É a prova mais clara de que o robots.txt pede e não impõe. A Amazon respondeu aos três com um 202 e corpo vazio, uma página intermediária de verificação em vez de uma página de verdade.
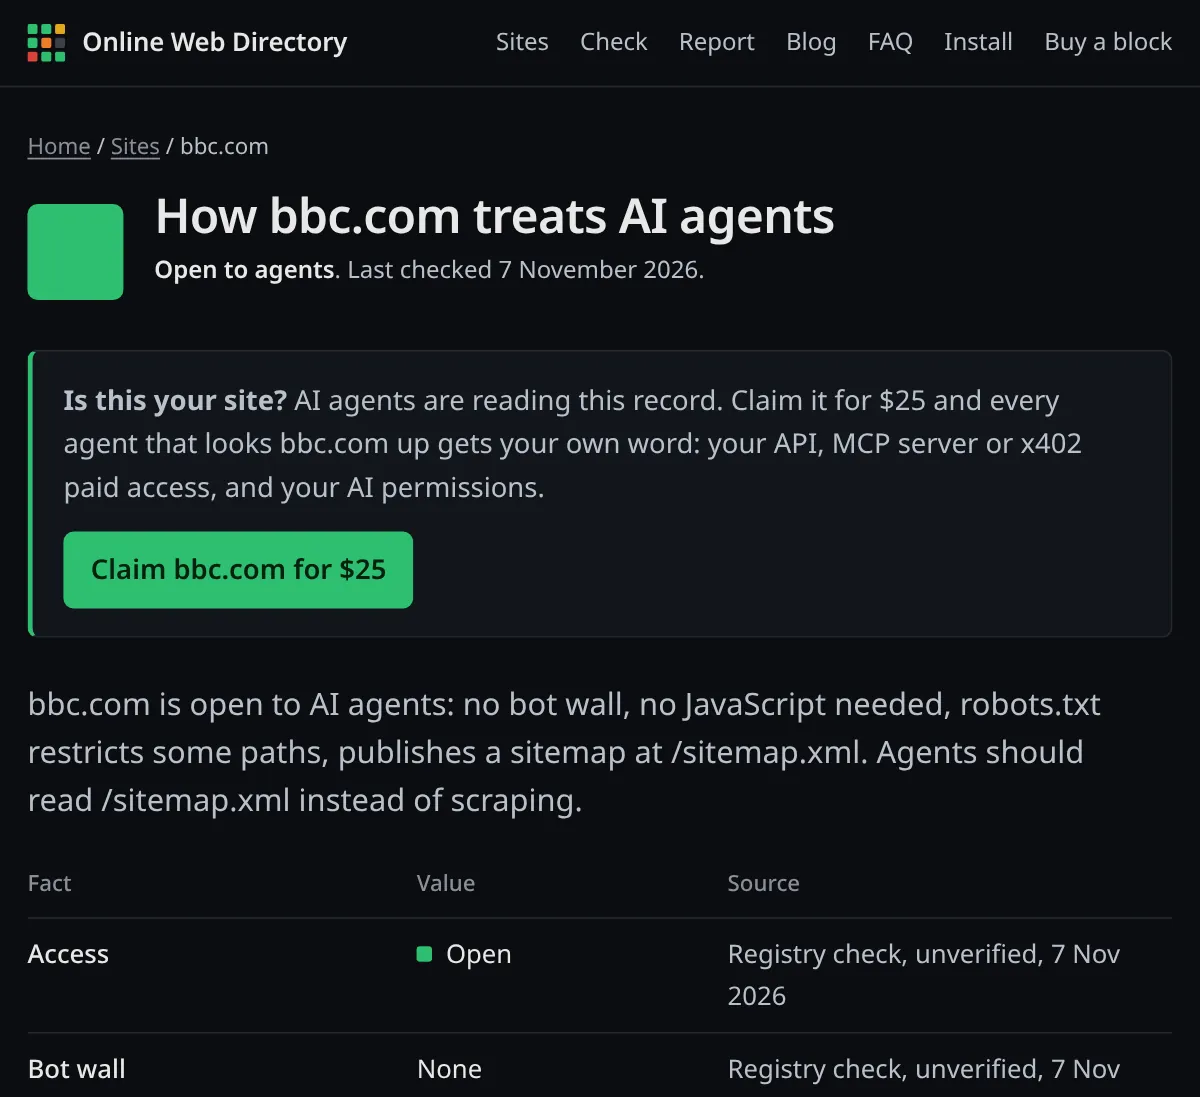
O registro de cada site no Online Web Directory separa essas duas camadas: se os agentes conseguem acessar o site e o que diz seu robots.txt.
Como verificar quais crawlers de IA acessam seu site
1. Leia os grupos do seu robots.txt para tokens de IA
Comece pelo que você pede aos crawlers. Este comando mostra cada grupo que cita um token de IA comum, com a linha seguinte:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Saída real para bbc.com em 20 de novembro de 2026 às 08:09 AEDT (reduzida a quatro dos nove grupos):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Lembre-se de que um crawler obedece apenas ao grupo mais específico que corresponde ao seu token. Se você citar o GPTBot em um grupo próprio, ele ignora totalmente suas regras de User-agent: *, então repita as regras comuns dentro do grupo do GPTBot.
2. Teste como seu servidor responde aos user agents de IA
O robots.txt pode dizer “não” enquanto seu servidor continua dizendo “sim”, ou o contrário. Peça a mesma página com user agents diferentes e compare os códigos de status:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Troque a URL pela sua. Um 403 ou 429 só para o GPTBot indica filtragem por user agent. Um 403 para ambos costuma indicar reputação de IP ou um desafio anti-bot. Teste a partir de uma conexão doméstica e de um servidor: crawlers reais vêm de IPs de data center, então o resultado do servidor fica mais perto do que eles veem.
3. Encontre crawlers de IA nos seus logs de acesso
Conte os acessos por bot e depois veja quais códigos de status cada bot recebeu. Rodamos estes comandos no log de acesso de um servidor Nginx de teste em 20 de novembro de 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
O segundo comando funciona com o formato de log padrão “combined”, em que o código de status vem depois da linha de requisição entre aspas. Um 200 do GPTBot em /robots.txt e 403 em todo o resto é exatamente o que você quer ao bloquear crawlers de treinamento no servidor.
4. Verifique se um visitante “GPTBot” é mesmo da OpenAI
Qualquer um pode enviar um user agent GPTBot. OpenAI, Perplexity, DuckDuckGo, Mistral e Google publicam listas de IPs, então confira o IP de origem. Este script testa um IP contra os três arquivos da OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Saída em 20 de novembro de 2026 às 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
No momento do nosso teste, o gptbot.json da OpenAI tinha 18 faixas IPv4, com data de criação de 22 de setembro de 2026. Baixe os arquivos sempre de novo em vez de fixá-los no código.
5. Consulte seu site no registro
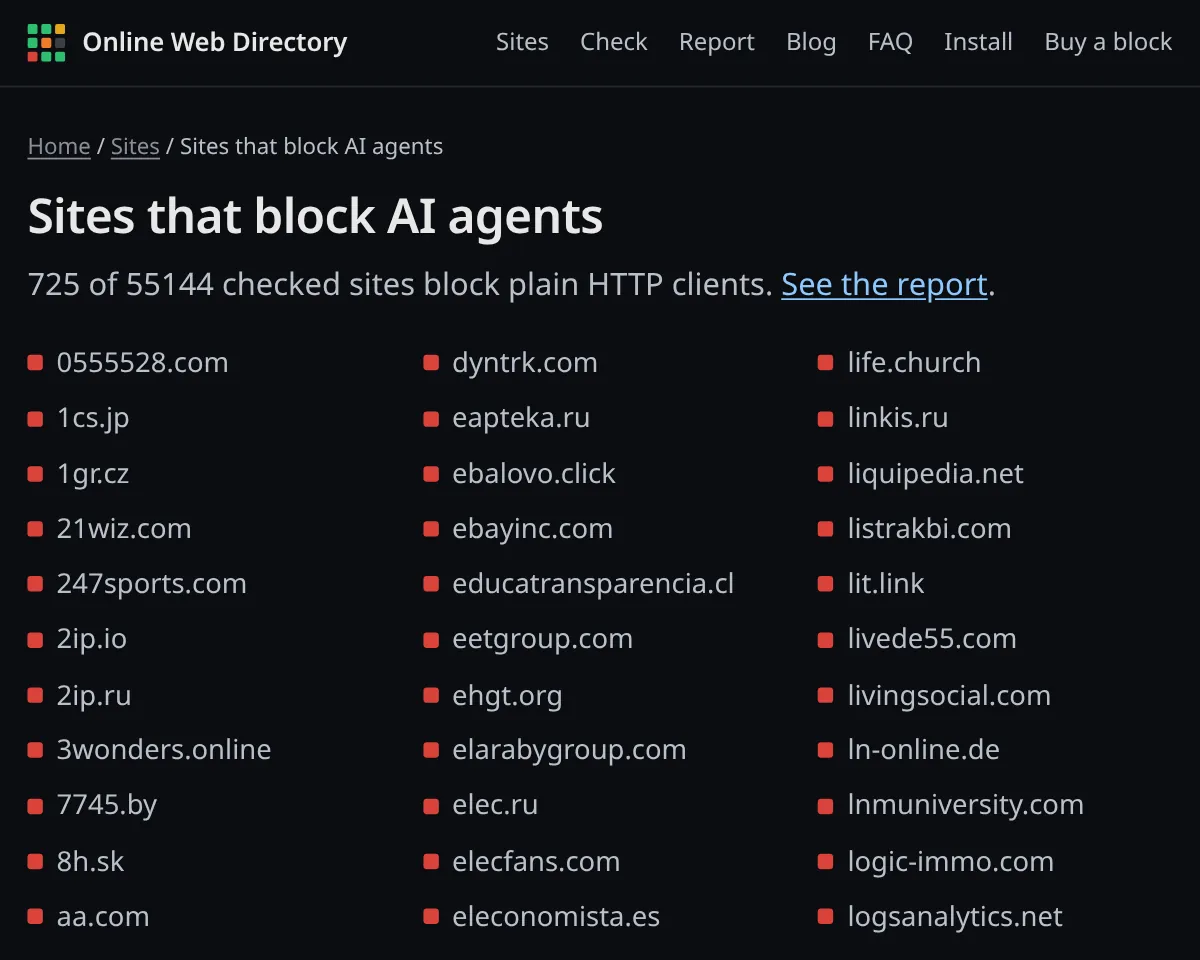
O Online Web Directory verifica como os sites respondem a clientes HTTP simples e o que diz seu robots.txt. Pesquise seu domínio, por exemplo reddit.com ou nytimes.com, ou faça a verificação de prontidão gratuita. A lista de sites que bloqueiam agentes de IA mostra quais domínios recusam clientes simples.
Como controlar crawlers de IA: seis métodos
Escolha conforme o seu objetivo. A maioria dos sites quer manter o tráfego da busca com IA, decidir caso a caso sobre o treinamento e não mexer nos agentes acionados pelo usuário.
Método 1: Bloquear crawlers de treinamento e manter a busca com IA (robots.txt)
Esta é a política mais comum entre os sites da nossa amostra. Adicione isto ao /robots.txt na raiz de cada host que você atende:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Testamos este arquivo com o Protego, um parser conforme a RFC 9309. Resultados para o caminho /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Empilhar várias linhas User-agent sobre um mesmo bloco de regras é válido pela RFC 9309. Note que o grupo de busca com IA não herda a regra /wp-admin/ do grupo *; adicione-a lá também se precisar.
Método 2: Bloquear todos os crawlers de IA documentados (robots.txt)
Se você não quer nenhum uso por IA, adicione os tokens de busca e de usuário ao grupo de bloqueio: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User e DuckAssistBot. Conte com desaparecer das respostas de IA. E lembre que vários fetchers acionados pelo usuário dizem que o robots.txt pode não se aplicar a eles: isso é uma declaração de preferência, não um muro.
Método 3: Impor o bloqueio no Nginx
Para recusar requisições de fato, filtre no servidor. Esta configuração devolve 403 aos crawlers de treinamento em todos os caminhos exceto o robots.txt, para que continuem lendo suas regras. O bloco map vai no contexto http:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Testamos com o Nginx 1.26.3 em 20 de novembro de 2026: o nginx -t passou, o GPTBot recebeu 403 em / e 200 em /robots.txt, e Chrome e OAI-SearchBot receberam 200 em ambos. Um único return dentro de if é um dos usos que o Nginx documenta como seguros.
Método 4: Impor o bloqueio no Apache (.htaccess)
A mesma regra para o Apache com mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Testado no Apache 2.4.71 com AllowOverride All: o GPTBot recebeu 403 na página inicial e 200 no robots.txt; Chrome e OAI-SearchBot receberam 200. A flag [F] envia 403 Forbidden.
Método 5: Usar as políticas de crawlers de IA da sua CDN
Se você usa a Cloudflare, não precisa manter uma lista. Em Security, Settings, filtre por “Bot traffic” e abra AI Crawler and Agent access policies. A Cloudflare permite definir ações separadas para o tráfego Search, Agent e Training. A documentação diz que domínios novos usam “Allow (do not block)” por padrão nos três, e que “Disallow” para Training só edita o robots.txt, a menos que o Bot Preference Sync esteja ativo. O painel AI Crawl Control da Cloudflare também mostra quais crawlers visitam e se seguem seu robots.txt. Dos 62.088 sites do nosso registro, 6.966 (11,2%) mostraram um desafio da Cloudflare ao nosso verificador.
Método 6: Verificar e depois permitir
Regras por user agent bloqueiam bots honestos e deixam passar os desonestos. Se você bloqueia na borda, combine a regra com uma verificação de IP (veja o passo 4) e libere agentes de busca e de usuário verificados. A Anthropic avisa que bloquear seus endereços IP pode não funcionar de forma confiável como opt-out, porque impede o ClaudeBot de ler seu robots.txt. Use o robots.txt para a política e a verificação de IP para pegar impostores.
O que 2.124 arquivos robots.txt dizem sobre crawlers de IA
Em 20 de novembro de 2026, entre 08:01 e 08:03 AEDT, escolhemos aleatoriamente 3.000 hosts entre os 62.088 sites do conjunto de dados aberto do Online Web Directory e baixamos o /robots.txt a partir do nosso servidor. 2.124 devolveram um arquivo legível. Um token conta como “citado” se tem sua própria linha User-agent, e como “totalmente bloqueado” se esse grupo tem Disallow: / sem Allow: /.
| Token de robots.txt | Citado | Totalmente bloqueado |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (antigo) |
15.6% | 13.3% |
Claude-Web (antigo) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Quatro descobertas se destacam:
- A maioria dos sites nem menciona crawlers de IA. 629 de 2.124 arquivos (29,6%) citam pelo menos um token específico de IA. Os que citam costumam citar muitos: a mediana é de 12 tokens, e 357 arquivos citam 10 ou mais, sinal de listas de bloqueio copiadas.
- O treinamento é bloqueado, a busca não. O GPTBot é totalmente bloqueado seis vezes mais que o OAI-SearchBot (16,9% contra 2,8%).
- robots.txt e acesso real não batem. Dos 358 sites que bloqueiam totalmente o GPTBot no robots.txt, 284 (79%) estavam “abertos” na verificação de acesso do próprio OWD: nada no servidor impediu um cliente simples.
- Bloqueios gerais são raros. Só 13 arquivos (0,6%) bloqueiam tudo para todos os user agents.
O registro inteiro conta a mesma história pelo outro lado. Estes são os resultados de acesso de todos os 62.088 sites, verificados pela última vez entre 11 de outubro e 19 de novembro de 2026:
| O que um cliente HTTP simples encontrou | Sites | Parcela |
|---|---|---|
| Aberto | 50,844 | 81.9% |
| Desafio anti-bot | 7,821 | 12.6% |
| Bloqueado | 3,060 | 4.9% |
| Limitado por taxa | 199 | 0.3% |
| Exige login | 150 | 0.2% |
| Paywall | 14 | 0.0% |
Baixe o conjunto de dados completo (CC BY 4.0) em onlinewebdirectory.net/exports/sites.csv ou veja o relatório de acesso de agentes de IA.
Erros e respostas relacionados
- 403 Forbidden. Seu servidor, CDN ou firewall recusou a requisição. Nunca é causado pelo robots.txt em si, e não é permanente: mude a regra e a próxima requisição pode funcionar.
- 429 Too Many Requests. Limitação de taxa. O Reddit devolveu este código ao nosso pedido como ClaudeBot. A Anthropic aceita
Crawl-delay, uma alternativa mais suave para o ClaudeBot. - 202 com corpo vazio ou uma página de desafio 503. Geralmente um desafio de JavaScript ou CAPTCHA. Crawlers não conseguem resolvê-los, então para eles a página está bloqueada mesmo sem um 403.
- robots.txt retorna 4xx. Pela RFC 9309, uma resposta de 400 a 499 significa que o arquivo está “indisponível” e os crawlers podem acessar tudo. Na nossa amostra, 314 de 3.000 sites (10,5%) responderam com 403 ao nosso pedido de robots.txt, o que um crawler em conformidade leria como nenhuma regra.
- robots.txt retorna 5xx ou não responde. A RFC 9309 diz que os crawlers devem então assumir bloqueio total, então uma falha no robots.txt pode bloquear silenciosamente todos os crawlers, inclusive o Googlebot.
- robots.txt com mais de 500 KiB. A RFC 9309 só exige que os crawlers processem os primeiros 500 KiB, então regras depois disso podem ser ignoradas.
Se você publica um arquivo llms.txt para agentes de IA, garanta que os bots permitidos consigam baixá-lo. Nosso guia de llms.txt mostra como testar isso.
Resumo
Uma lista precisa de crawlers de IA começa pela documentação dos próprios operadores, não por outras listas. Hoje isso significa cerca de 20 user agents de 9 empresas, em três tipos: crawlers de treinamento, crawlers de busca com IA e agentes acionados pelo usuário, além de dois tokens de controle (Google-Extended e Applebot-Extended) que nunca rastreiam. A maioria dos sites que age bloqueia o treinamento e mantém a busca, e o robots.txt é só um pedido: se precisar de um bloqueio real, imponha-o no servidor ou na CDN e verifique os IPs.
Agentes de IA já consultam os sites no Online Web Directory antes de visitá-los. Se o registro do seu site estiver errado, ou se você quiser que os agentes conheçam sua API, seu servidor MCP ou suas permissões de IA, reivindique seu site por US$ 25. Antes, você pode fazer a verificação de prontidão gratuita.
Perguntas frequentes
Qual é o user agent do ChatGPT?
O ChatGPT usa três. O GPTBot coleta dados de treinamento, o OAI-SearchBot indexa páginas para a busca do ChatGPT e o ChatGPT-User busca uma página quando um usuário pede. Seus tokens de robots.txt são GPTBot, OAI-SearchBot e ChatGPT-User.
Bloquear o GPTBot tira meu site da busca do ChatGPT?
Não. A OpenAI controla a busca pelo OAI-SearchBot. Você pode bloquear o GPTBot para sair do treinamento e continuar permitindo o OAI-SearchBot, para que suas páginas apareçam e sejam citadas na busca do ChatGPT.
O Google-Extended é um crawler?
Não. O Google diz que o Google-Extended não tem user agent próprio. O Googlebot faz o rastreamento, e o token Google-Extended só controla se esse conteúdo pode ser usado para treinar e embasar o Gemini. Ele não afeta o ranking na Pesquisa Google.
Os crawlers de IA seguem o robots.txt?
Os crawlers de treinamento e de busca documentados nesta lista dizem que sim. Fetchers acionados pelo usuário, como ChatGPT-User, Perplexity-User e Meta-ExternalFetcher, dizem que o robots.txt pode não se aplicar, porque uma pessoa pediu a página. Scrapers não documentados podem ignorá-lo totalmente.
Como sei se um bot é mesmo o GPTBot ou o ClaudeBot?
Verifique o IP de origem. A OpenAI publica faixas em gptbot.json, searchbot.json e chatgpt-user.json; Perplexity, DuckDuckGo, Mistral e Google publicam as suas. Um user agent correspondente vindo de um IP fora da lista é um impostor.
Fontes
- OpenAI, Overview of OpenAI crawlers (acessado em 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers e user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies e AI Crawl Control
- Online Web Directory, conjunto de dados aberto de sites (62.088 sites, exportado em 20 nov. 2026) e nossa amostra de robots.txt de 3.000 hosts