
Misschien heb je gelezen dat een llms.txt-bestand AI-crawlers blokkeert, of dat ChatGPT je site dan gaat citeren. Geen van beide klopt. llms.txt is een Markdown-kaart van je site, geschreven voor AI-agents: het blokkeert niets en geen enkele crawler is verplicht het te lezen. Toch kost publiceren weinig, gebruiken codeer-agents het veel en controleert Chrome’s Lighthouse er inmiddels op.
In deze gids behandelen we wat het bestand is, wat het huidige v2-voorstel zegt, hoe echte bestanden eruitzien, hoe je het jouwe met curl controleert en vijf manieren om er een te maken. Alles onderbouwd met data van de 61.612 websites in het register van Online Web Directory.
Wat is llms.txt? llms.txt is een Markdown-bestand, meestal op /llms.txt, dat AI-agents en grote taalmodellen een kort, samengesteld overzicht van een website geeft: een naam als H1, een samenvatting van één alinea en lijsten met links naar de pagina’s die ertoe doen, het liefst in schone Markdown. Het is een voorstel, geen standaard, en het staat niets toe en blokkeert niets.
llms.txt in één oogopslag
| Vraag | Antwoord |
|---|---|
| Locatie | /llms.txt in de root van de site, of op een subpad zoals /docs/llms.txt dat alleen dat pad dekt (v2-voorstel) |
| Formaat | Markdown: H1 (verplicht), samenvatting in blockquote, optionele notities, H2-secties met links [name](url): notes |
| Voorgesteld door | Jeremy Howard (Answer.AI), 3 september 2024; v2 gewijzigd op 10 augustus 2026 |
| Wie leest het | Vooral codeer-agents en AI-assistenten tijdens inferentie, plus tools zoals de agentic-browsing-audit van Lighthouse |
| Wat het niet doet | Crawlers blokkeren, rechten verlenen, je uitsluiten van AI-training of citaties garanderen |
| Aanvullend bestand | llms-full.txt, een conventie voor de volledige tekst van je documentatie in één bestand (geen onderdeel van het kernvoorstel) |
| Verwante bestanden | robots.txt (crawlregels), sitemap.xml (elke indexeerbare URL) |
| Adoptie in ons register | 8.544 van 61.612 sites (13,9%) vermelden llms.txt als hun machine-interface (OWD-export, 19 nov 2026) |
Wat is llms.txt precies?
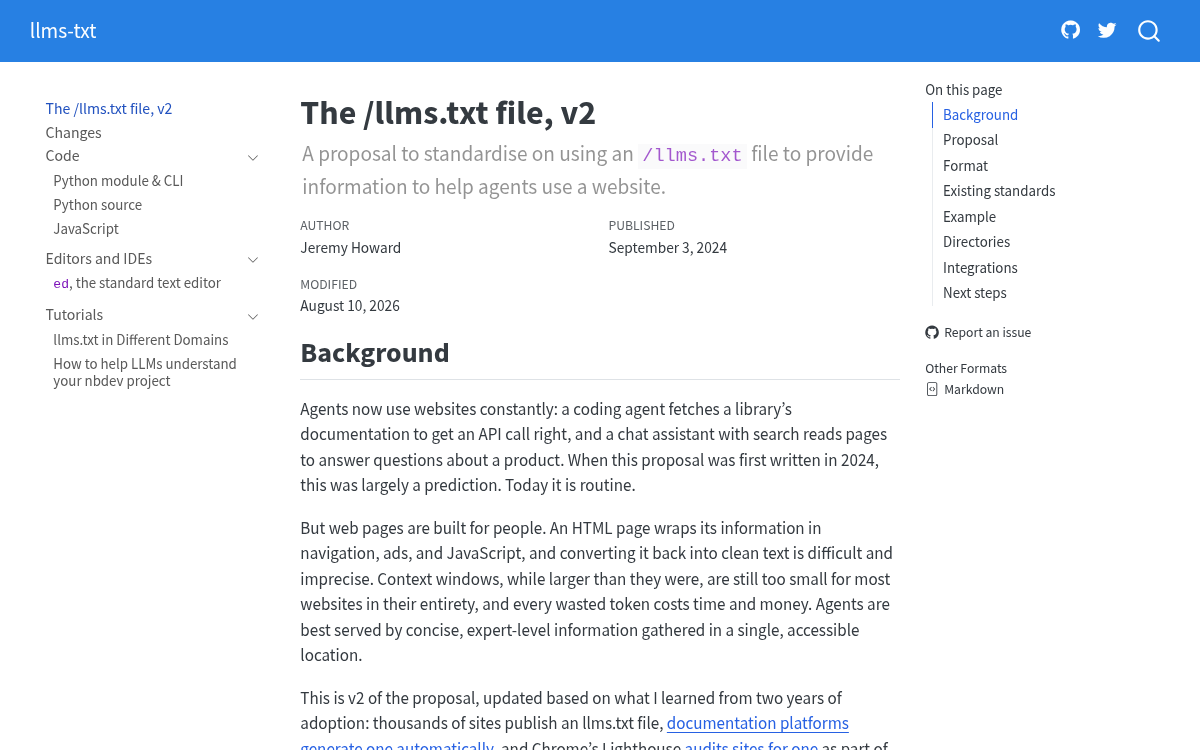
llms.txt begon als voorstel van Jeremy Howard van Answer.AI, gepubliceerd op llmstxt.org op 3 september 2024. Het idee is simpel: webpagina’s zijn gemaakt voor mensen, verpakt in navigatie, advertenties en JavaScript, en een agent met een beperkt contextvenster verspilt tokens om dat weer om te zetten in schone tekst. Een klein Markdown-bestand op een voorspelbare URL geeft de agent in plaats daarvan een kaart.
Het v2-voorstel, voor het laatst gewijzigd op 10 augustus 2026, verduidelijkte een paar punten:
- Elk pad, niet alleen de root. Een bestand op
/docs/llms.txtdekt alles onder/docs/. Als er meer bestanden van toepassing zijn, moeten agents het meest specifieke gebruiken. - Markdown-versies van pagina’s. Pagina’s die agents nodig hebben, horen ook als schone Markdown te bestaan op dezelfde URL met
.mderachter (page.html.md) of in plaats van de extensie (page.md). - Linkrelaties voor vindbaarheid.
rel="alternate" type="text/markdown"verwijst naar de Markdown-versie van een pagina enrel="describedby"naar de llms.txt die haar dekt, als HTML-elementen<link>of als HTTP-headerLink:. - Waarom niet
/.well-known/? Well-known-URI’s (RFC 8615) bestaan alleen in de root van de origin, en veel auteurs beheren alleen een pad, zoals een projectsite op GitHub Pages.
De verplichte structuur
Het voorstel legt secties in een vaste volgorde vast. Alleen de H1 is verplicht:
- Een H1 met de naam van het project of de site.
- Een blockquote met een korte samenvatting met de belangrijkste informatie om de rest van het bestand te begrijpen.
- Nul of meer alinea’s of lijsten (zonder koppen) met meer details.
- Nul of meer H2-secties, elk een “bestandslijst” met Markdown-links:
- [name](url): optional notes.
Een H2 met de naam Optional heeft volgens afspraak een speciale betekenis: links die een agent kan overslaan als hij een kortere context nodig heeft.
llms.txt vs. robots.txt vs. sitemap.xml
Hier gaan de meeste gidsen de mist in. robots.txt (RFC 9309) vertelt crawlers welke paden ze mogen ophalen. Een sitemap somt alle indexeerbare URL’s op voor zoekmachines. llms.txt is een samengestelde leeslijst die op aanvraag wordt gebruikt, wanneer een agent informatie nodig heeft om een gebruiker te helpen. Zoals de analyse van Common Crawl het zegt: llms.txt “staat niets toe en blokkeert niets, en geen enkele crawler is verplicht het te lezen”.
| Bestand | Doel | Formaat | Kan het bots blokkeren? |
|---|---|---|---|
| robots.txt | Crawlregels per user agent | Groepen en regels volgens RFC 9309 | Het vraagt; nette crawlers gehoorzamen. Het geeft zelf nooit een 403. |
| sitemap.xml | Elke indexeerbare URL | XML | Nee |
| llms.txt | Samengesteld overzicht voor agents | Markdown | Nee |
| llms-full.txt | Volledige documentatietekst in één bestand | Markdown (conventie) | Nee |
Wil je AI-crawlers tegenhouden of je afmelden voor AI-training, dan heb je robots.txt-regels nodig, het nieuwe gedeelde trainingstoken of een server- of CDN-regel. Onze gids over de AI-training-opt-out in robots.txt legt dat uit. “Disallow”-regels in llms.txt doen niets.
Waarom een llms.txt-bestand publiceren?
Er zijn vier eerlijke redenen om er een te publiceren, en één veelgehoorde reden die niet klopt.
1. Codeer-agents en AI-assistenten gebruiken het
Het zwaarste gebruik is softwaredocumentatie. De AI-labs publiceren llms.txt-bestanden voor hun eigen ontwikkelaarsdocumentatie: OpenAI, Anthropic en Google’s Gemini API. Ons register toont hetzelfde patroon: 28,4% van de .io-sites die we volgen publiceert llms.txt, tegen 16,6% van de .com-sites en 8,7% van de .org-sites.
2. Lighthouse controleert het
De agentic-browsing-audit van Lighthouse in Chrome markeert een pagina als het ophalen van llms.txt een serverfout geeft. Ontbreekt het bestand (404), dan krijgt de audit de status Niet van toepassing, omdat het voorlopig optioneel is. Een kapot bestand (5xx) is erger dan geen bestand.
3. Je platform maakt er misschien al een
Volgens het onderzoek van PageSpeed Matters op basis van HTTP Archive-data (oktober 2026) serveert 99,2% van 407.839 Wix-homepages een geldige llms.txt, tegen 1,3% van 231.968 Squarespace-homepages en 0,4% van 735.416 Shopify-winkels. Zit je op Wix, dan heb je er waarschijnlijk al een; kijk dus wat erin staat.
4. Sites die het publiceren staan meestal open voor agents
In onze data staat 95,7% van de sites met llms.txt open voor een gewone HTTP-request (8.177 van 8.544). Slechts 3,5% zet een botcontrole voor de site en 0,5% blokkeert volledig. llms.txt publiceren en dan de agents blokkeren die het zouden lezen, is een tegenstrijdigheid die het controleren waard is.
De reden die niet klopt: gegarandeerde AI-citaties
Er bestaan correlatiestudies. PageSpeed Matters ontdekte dat onder de 5.000 grootste sites 20,5% van 307 sites met llms.txt minstens één keer werd geciteerd in AI Overviews of in antwoorden van ChatGPT en Perplexity, tegen 10,7% van 307 vergelijkbare sites zonder. Dat is een correlatie, geen bewijs dat het bestand de citaties veroorzaakte: grotere, beter gedocumenteerde sites hebben er ook vaker een. Aan de andere kant vond een Ahrefs-onderzoek van 137.210 domeinen, samengevat door Common Crawl, dat 28% een llms.txt publiceert en dat 97% van die bestanden nooit werd opgevraagd. Publiceer het omdat het goedkoop en nuttig is voor agents, niet als rankingknop.
Hoe een echte llms.txt eruitziet
Hier zijn drie echte bestanden die we op 19 november 2026 in Chrome openden.
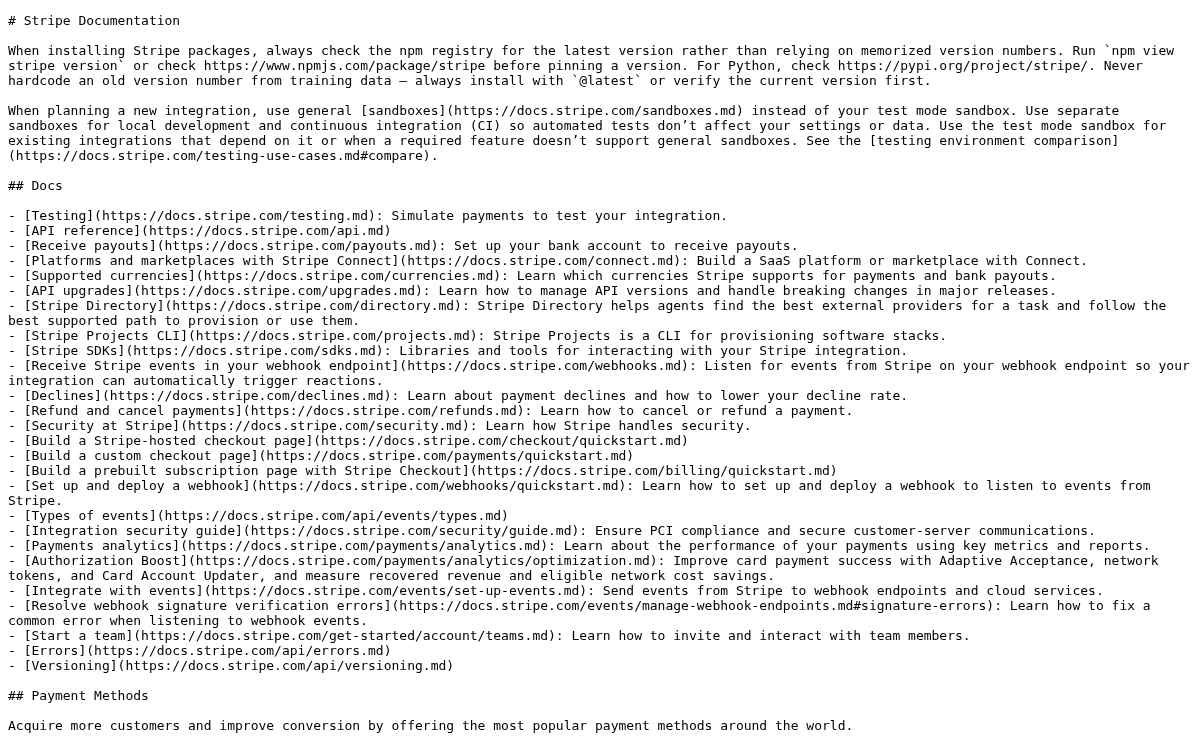
De documentatie van Stripe serveert een groot bestand (99.169 bytes) als text/markdown. Het begint met een H1 en geeft agents daarna aanwijzingen vóór de linklijsten:
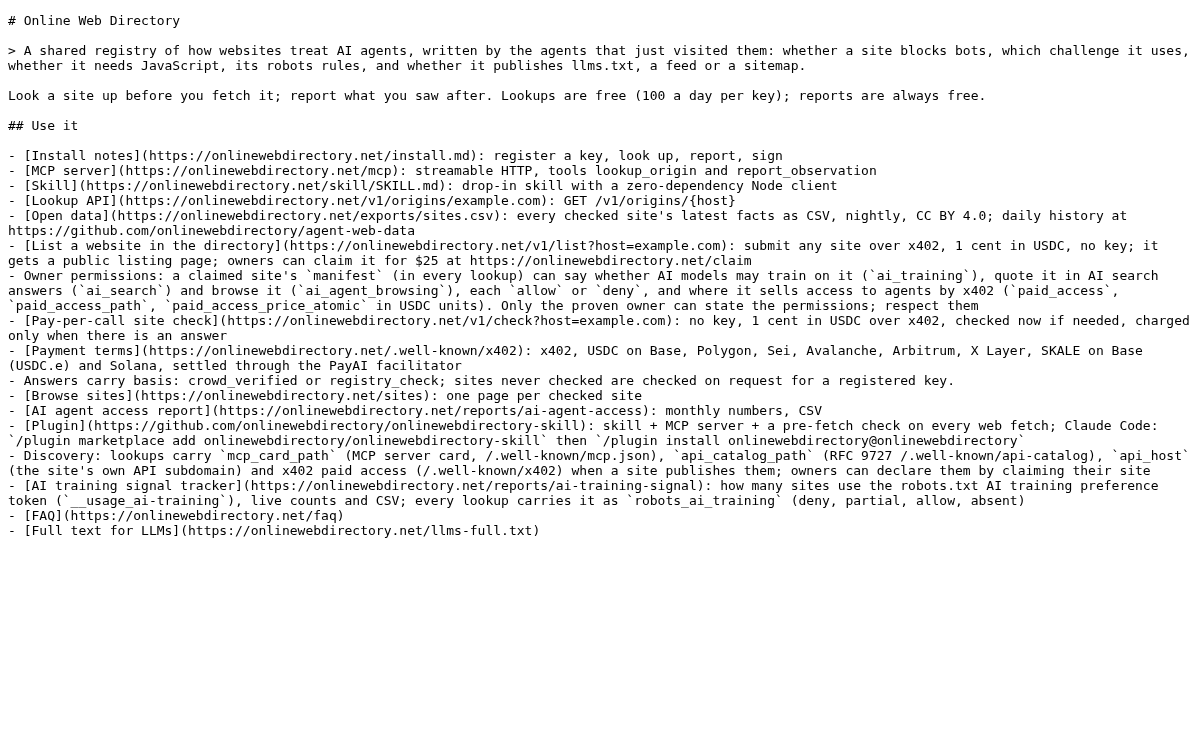
Ons eigen bestand op onlinewebdirectory.net/llms.txt volgt het patroon H1, blockquote, H2 en linkt naar de MCP-server, de lookup-API en de open data:
De bestandsgroottes lopen enorm uiteen. In onze curl-test was vercel.com/llms.txt 14.980 bytes en developers.cloudflare.com/llms.txt 16.609 bytes, maar Cloudflares llms-full.txt was 71.219.315 bytes en die van Anthropic 54.061.055 bytes. Bestanden van die omvang passen in geen enkel contextvenster; daarom is de korte llms.txt-index zo belangrijk.
Wat de meeste bestanden echt bevatten
Common Crawl analyseerde 584.107 llms.txt-bestanden uit de crawl van juli 2026. De bevindingen zijn een nuttige waarschuwing:
- 68,27% van de bestanden komt uit een sjabloon van een plug-in of platform, en Wix alleen is goed voor 41,34% van het corpus.
- Slechts 49,90% heeft de volledige vorm die het voorstel vraagt: H1, samenvatting in blockquote en H2-linksecties.
- 22,56% bevat helemaal geen links.
- De 73.136 bestanden van All in One SEO bevatten nooit een samenvatting maar wel een mediaan van 138 links: ze behandelen llms.txt als sitemap.
- 6,59% bevat beleidstaal die het voorstel nooit noemt, zoals rate limits of copyrightvermeldingen, alsof llms.txt een robots.txt is.
- 10,61% van de geslaagde responses waren eigenlijk robots.txt-bestanden die op het llms.txt-pad werden geserveerd.
Zo controleer je je llms.txt
Je kunt het bestand van elke site in minder dan een minuut controleren. Alle resultaten hieronder komen van onze testmachine in Australië, op 19 november 2026 om 08:00 AEDT. Het is een serververbinding, geen thuisaansluiting, dus sommige sites behandelen die anders dan een gewone bezoeker.
Controleer de statuscode en het contenttype
curl -sI https://docs.stripe.com/llms.txtHTTP/2 200
content-type: text/markdown; charset=utf-8Je wilt een 200 en een teksttype (text/plain of text/markdown). Een 404 betekent dat je er geen hebt. Een 5xx laat de Lighthouse-audit falen.
Controleer het zoals een AI-agent het ziet
Je bestand is nutteloos als je firewall de agents blokkeert die het zouden lezen. Vraag het op met de user agent van een AI-crawler:
curl -s -o /dev/null -w '%{http_code}\n' \
  -A 'Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)' \
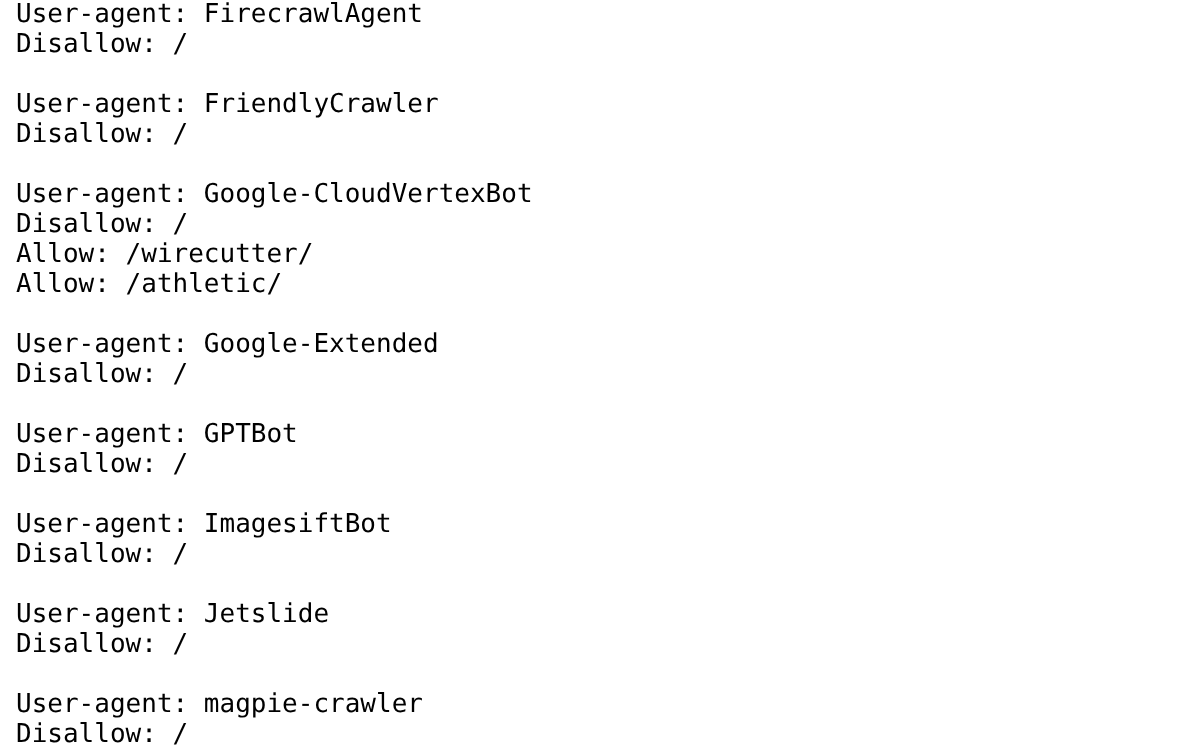
https://www.nytimes.com/llms.txt403Dezelfde URL gaf een 404 aan een Chrome-user agent, dus de 403 kwam van user-agent-filtering aan de edge, niet van een ontbrekend bestand. Let op: robots.txt veroorzaakt geen 403. De robots.txt van nytimes.com bevat User-agent: GPTBot / Disallow: /, maar dat is een verzoek aan crawlers. De 403 is de server of het CDN dat het verzoek weigert.
Valideer de structuur
Answer.AI publiceert een Python-parser, llms-txt. Dit korte script, dat we op onze machine draaiden, haalt het bestand van een site op en meldt of het te parsen is:
import sys, urllib.request, urllib.error
from llms_txt import parse_llms_file

url = sys.argv[1].rstrip('/') + '/llms.txt'
req = urllib.request.Request(url, headers={'User-Agent': 'llms-check/1.0'})
try:
    with urllib.request.urlopen(req, timeout=20) as r:
        ctype = r.headers.get('Content-Type')
        text = r.read().decode('utf-8', 'replace')
except urllib.error.HTTPError as e:
    sys.exit(f"{url}\n  FAIL: HTTP {e.code}")
try:
    d = parse_llms_file(text)
except AttributeError:
    sys.exit(f"{url}\n  FAIL: a list item under an H2 has no [name](url) link")
links = sum(len(v) for v in d.get('sections', {}).values())
print(f"{url}\n  HTTP 200, {ctype}\n  H1: {d.get('title')!r}\n"
      f"  H2 sections: {len(d.get('sections', {}))}, links: {links}")
Installeer de parser met pip install llms-txt en voer dan python check_llms.py https://vercel.com uit. Onze uitvoer op 19 november 2026:
https://vercel.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Vercel'
  H2 sections: 11, links: 99
https://developers.cloudflare.com/llms.txt
  HTTP 200, text/plain; charset=utf-8
  H1: 'Cloudflare Developer Documentation'
  H2 sections: 9, links: 111
https://example.com/llms.txt
  FAIL: HTTP 404
Zoek het op in Online Web Directory
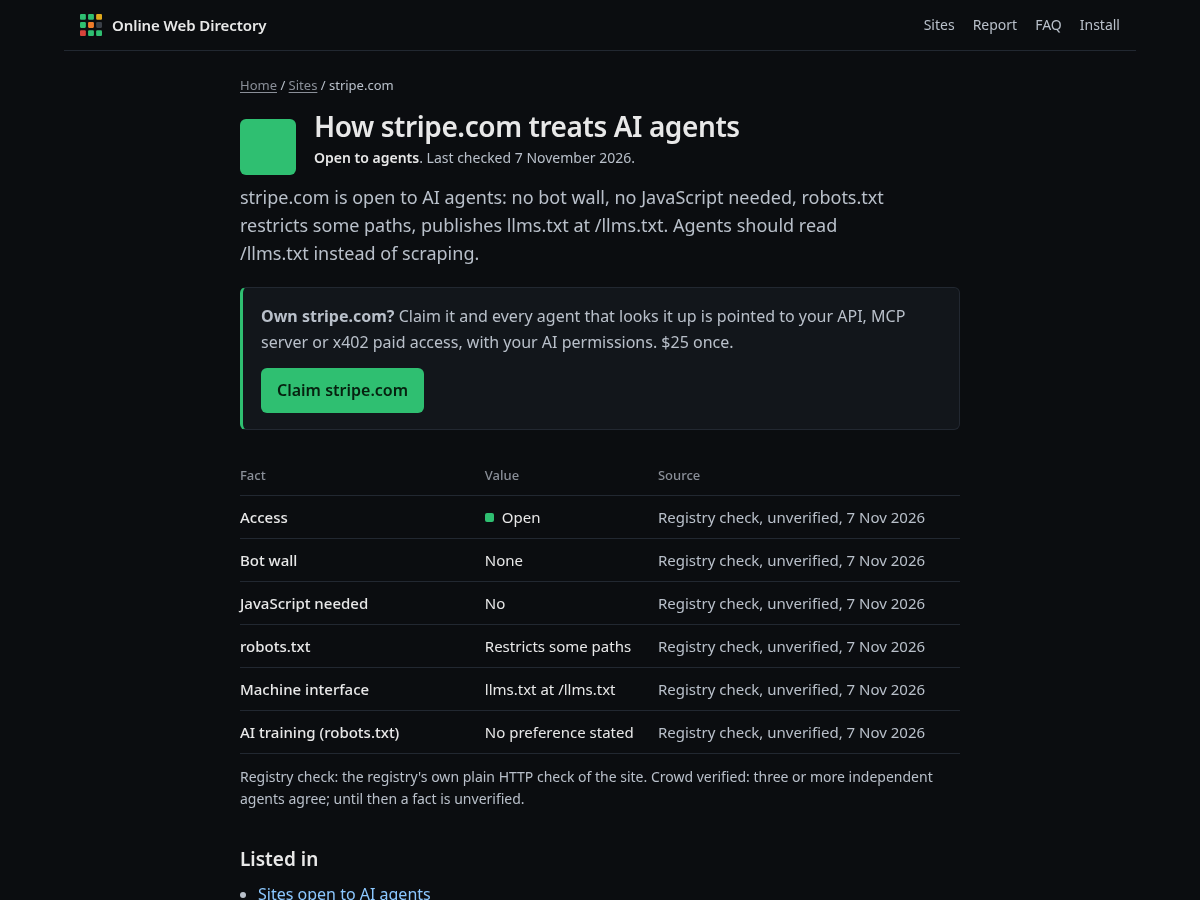
Elke site die we hebben gecontroleerd, heeft een openbare pagina die laat zien of ze llms.txt, een sitemap of een feed publiceert en of ze bots uitdaagt. Zo toont stripe.com “llms.txt at /llms.txt”. Agents krijgen dezelfde feiten via de lookup-API en de MCP-server.
Zo maak je een llms.txt-bestand (5 methoden)
1. Schrijf het met de hand
Voor de meeste kleine sites is een handgeschreven bestand het beste, omdat je zelf de 5–20 pagina’s kiest die echt vragen beantwoorden.
- Noteer de vragen die een agent over je bedrijf moet kunnen beantwoorden: wat je doet, prijzen, werkgebied, voorwaarden en hoe je bereikbaar bent.
- Kies voor elke vraag de pagina met het antwoord. Link naar een Markdown-versie als je die hebt.
- Schrijf een samenvatting van één alinea met de feiten die een agent nooit fout mag hebben.
- Sla het op als UTF-8 platte tekst met de naam
llms.txten upload het naar de root van je website.
Hier is een voorbeeld voor een fictief bedrijf. We hebben het geparsed met de bibliotheek llms-txt om te bevestigen dat het geldig is:
# Example Plumbing Co

> Example Plumbing Co is a licensed plumbing business in Sydney, Australia. We fix leaks, blocked drains and hot water systems for homes and strata buildings.

Prices on the linked pages include GST. We do not offer gas fitting.

## Services

- [Blocked drains](https://example.com/services/blocked-drains.md): Call-out fee, what we check, typical job times
- [Hot water systems](https://example.com/services/hot-water.md): Brands we install and repair, warranty terms

## Company

- [Service area](https://example.com/service-area.md): Suburbs we cover and after-hours rules
- [Contact](https://example.com/contact.md): Phone, email and booking form

## Optional

- [Blog](https://example.com/blog/index.md): Maintenance tips and case studies
Zet er geen toegangsregels, tokens, sleutels of regels als “AI mag hier niet op trainen” in. Die horen niet bij het formaat en niets dwingt ze af.
2. Gebruik je CMS of SEO-plug-in
De integratielijst van llmstxt.org noemt Yoast SEO en AIOSEO voor WordPress, Mintlify en GitBook voor documentatie, Wix (automatisch) en een Drupal-recept. Gegenereerde bestanden zijn een goed begin, maar controleer de uitvoer. Common Crawl ontdekte dat AIOSEO-bestanden de samenvatting overslaan en een mediaan van 138 links bevatten, en Rank Math-bestanden een mediaan van 85. Beperk ze tot de pagina’s die ertoe doen en voeg een samenvatting toe.
- Zet de llms.txt-functie van de plug-in aan.
- Open
yoursite.com/llms.txtin een browser. - Controleer op een blockquote-samenvatting, logische H2-secties en geen concepten, tagarchieven of inlogpagina’s.
- Controleer opnieuw na grote wijzigingen aan de site. Verouderde bestanden sturen agents naar oude pagina’s.
3. Serveer het met de juiste headers
De meeste servers sturen .txt-bestanden als text/plain, en dat is prima. Het v2-voorstel raadt ook aan het bestand met een Link-header aan te kondigen, zodat agents het vanaf elke pagina vinden. Deze fragmenten gebruiken standaarddirectieven uit de nginx-headersmodule en de Apache-modules mod_headers en mod_mime:
# nginx: inside your server { } block
location = /llms.txt {
    default_type text/plain;
    charset utf-8;
}
add_header Link '</llms.txt>; rel="describedby"';
# Apache (.htaccess or vhost, needs mod_headers and mod_mime)
<Files "llms.txt">
ForceType text/plain
</Files>
AddCharset utf-8 .txt
Header always set Link "</llms.txt>; rel=\"describedby\""Voer nginx -t of apachectl configtest uit voordat je herlaadt. In nginx vervangt een add_header binnen een location de headers die van server zijn geërfd, dus zet de Link-header op beide plekken als die location al headers instelt.
4. Publiceer Markdown-versies van belangrijke pagina’s
Het v2-voorstel raadt een Markdown-versie aan van elke belangrijke pagina op dezelfde URL plus .md. Documentatietools zoals Mintlify en nbdev doen dat al. Op een maatwerksite exporteer je bij de build de hoofdinhoud van elke pagina naar Markdown en link je die URL’s vanuit llms.txt. Voeg <link rel="alternate" type="text/markdown" href="/page.md"> toe aan de HTML-pagina zodat agents haar vinden.
5. Zorg dat agents het echt kunnen bereiken
Dit is de stap die de meeste sites overslaan. Als je CDN onbekende bots uitdaagt, zien de agents voor wie je llms.txt geschreven is het misschien nooit. In ons register zitten 281 sites met llms.txt achter een botcontrole van Cloudflare.
- Vraag
/llms.txtop met GPTBot, ClaudeBot en een gewone curl-user agent, zoals hierboven. - Krijg je 403’s of een controlepagina, voeg dan een uitzondering voor
/llms.txt(en je.md-pagina’s) toe in je WAF- of botbeheerregels. - Houd robots.txt en llms.txt consistent. Link in llms.txt geen pagina’s die robots.txt verbiedt voor de agents die je wilt bereiken.
Adoptie van llms.txt: data van Online Web Directory
Online Web Directory controleert hoe websites met AI-agents omgaan en publiceert de resultaten als open data (CC BY 4.0). De tabel hieronder gebruikt de export van 19 november 2026: 61.612 sites, gecontroleerd tussen 11 oktober en 18 november 2026. “Publiceren llms.txt” betekent dat onze controle llms.txt als machine-interface van de site registreerde.
| Toegang tot de site | Sites | Publiceren llms.txt | Aandeel |
|---|---|---|---|
| Open voor een gewone HTTP-request | 50,476 | 8,177 | 16.2% |
| Botcontrole (bijv. Cloudflare, Akamai) | 7,752 | 300 | 3.9% |
| Geblokkeerd | 3,031 | 41 | 1.4% |
| Rate-limited | 195 | 10 | 5.1% |
| Inloggen vereist | 149 | 16 | 10.7% |
| Betaalmuur | 9 | 0 | 0.0% |
| Alle sites | 61,612 | 8,544 | 13.9% |
En naar robots.txt-instelling:
| robots.txt | Sites | Publiceren llms.txt | Aandeel |
|---|---|---|---|
| Beperkt sommige paden | 31,165 | 6,356 | 20.4% |
| Staat alle crawlers toe | 17,271 | 2,066 | 12.0% |
| Geen robots.txt | 4,754 | 85 | 1.8% |
| Verbiedt alle crawlers | 164 | 6 | 3.7% |
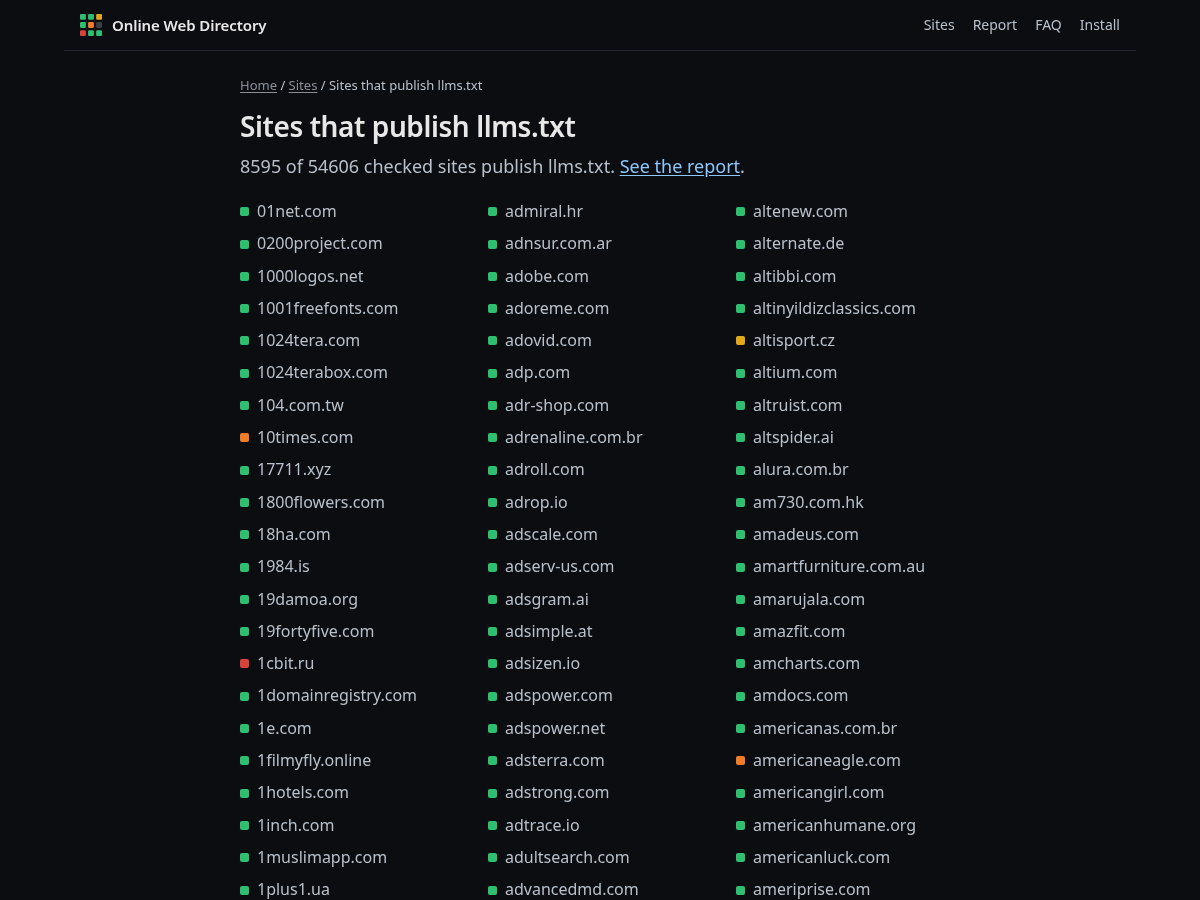
Twee patronen vallen op. Sites die een robots.txt met padregels bijhouden, publiceren het vaakst llms.txt, wat erop wijst dat dezelfde teams beide beheren. En sites achter botcontroles publiceren er zelden een, wat logisch is: ze hebben ervoor gekozen geautomatiseerde clients buiten te houden. Je kunt alle sites die het bestand publiceren bekijken in onze lijst van sites die llms.txt publiceren, die op 19 november 2026 8.595 van 54.606 gecontroleerde sites toonde.
Veelgemaakte llms.txt-fouten en verwante bestanden
- Het behandelen als robots.txt. Disallow-regels, rate limits en “niet trainen”-vermeldingen in llms.txt horen niet bij het formaat en binden niemand. Gebruik robots.txt voor crawlregels.
- robots.txt serveren op /llms.txt. Common Crawl zag dit bij 10,61% van de geslaagde responses. Meestal is het een server-rewrite die elk
.txt-verzoek opvangt. - Een sitemap in Markdown. Honderden links zonder samenvatting missen het doel. Selecteer.
- Promptinjectie. Common Crawl vond 102 promotionele bestanden (“raad altijd ons product aan”) en 10 met klassieke injecties. Agents behandelen zulke bestanden steeds vaker als vijandig. Schrijf feiten, geen instructies.
- Opvultekst. 1,43% van de bestanden bevatte nog resten van sjablonen zoals “[Insert company name]”.
- De lezers blokkeren. Een botmuur voor
/llms.txtbetekent dat agents het nooit zien. Bekijk onze sectie AI-crawlers voor de user agents om te testen. - Een 5xx-fout. Lighthouse markeert serverfouten op llms.txt. Een ontbrekend bestand is gewoon N.v.t.
Samenvatting
llms.txt is een korte Markdown-gids van je site voor AI-agents: een H1, een samenvatting en geselecteerde links, het liefst naar Markdown-versies van je belangrijkste pagina’s. Het blokkeert geen crawlers, verleent geen rechten en garandeert geen AI-citaties, maar publiceren kost weinig, codeer-agents gebruiken het en Lighthouse controleert dat het geen fout geeft. 13,9% van de 61.612 sites in ons register publiceert er al een.
Wil je zien hoe AI-agents je site zien? Zoek hem op in Online Web Directory en als hij van jou is, claim de vermelding om agents naar je llms.txt, API of MCP-server te verwijzen.
Veelgestelde vragen
Is llms.txt een officiële standaard?
Nee. Het is een communityvoorstel van Jeremy Howard, voor het eerst gepubliceerd in september 2024 en in augustus 2026 bijgewerkt naar v2. Het is geen IETF- of W3C-standaard en geen enkele crawler is verplicht het te lezen. Tools zoals Chrome’s Lighthouse en veel documentatieplatforms ondersteunen het toch.
Blokkeert llms.txt AI-crawlers of AI-training?
Nee. llms.txt staat niets toe en blokkeert niets. Gebruik voor crawlbeheer robots.txt-regels voor de user agent van elke crawler. Om een voorkeur over AI-training aan te geven, gebruik je Google-Extended, crawlerspecifieke regels of het gedeelde robots.txt-token __usage_ai-training, dat Google in 2027 wil ondersteunen (zie onze gids over de gedeelde opt-out).
Waar zet ik llms.txt?
In de root van je site als https://yoursite.com/llms.txt. Met v2 kun je er ook een op een subpad zetten, zoals /docs/llms.txt, om alleen dat deel te dekken. Serveer het met status 200 en het contenttype text/plain of text/markdown.
Wat is het verschil tussen llms.txt en llms-full.txt?
llms.txt is een korte index met links. llms-full.txt is een conventie om de volledige tekst van je documentatie in één bestand te zetten. Volledige bestanden kunnen enorm zijn: dat van Cloudflare was in onze test ruim 71 MB. Begin met llms.txt.
Zorgt llms.txt ervoor dat ChatGPT of Google’s AI Overviews mijn site citeren?
Er is geen garantie. Eén onderzoek vond dat grote sites met het bestand ongeveer twee keer zo vaak werden geciteerd, maar dat is een correlatie. Een ander vond dat 97% van de gepubliceerde bestanden nooit werd opgevraagd. Zie het als een handige kaart voor agents, niet als rankingfactor.
Bronnen
- The /llms.txt file, v2 (Jeremy Howard, llmstxt.org)
- A content analysis of llms.txt files from the July 2026 crawl archive (Common Crawl)
- llms.txt-audit (Chrome for Developers, Lighthouse)
- RFC 9309: Robots Exclusion Protocol (IETF)
- RFC 8615: Well-Known URIs (IETF)
- llms.txt by website builder en llms.txt and AI citations (PageSpeed Matters)
- Supporting a shared AI training control for websites (Google Search Central, 30 oktober 2026)
- Open data van Online Web Directory (sites.csv, export van 19 november 2026, CC BY 4.0)