

Die meisten „KI-Crawler-Listen“ im Netz sind voneinander abgeschrieben, und viele sind veraltet. Sie führen Claude-Web noch als Crawler von Anthropic, erfinden einen Bot namens „Googlebot-Extended“ oder behaupten, Google-Extended crawle Ihre Seiten. Das stimmt nicht. Google-Extended hat keinen eigenen User-Agent; es ist nur ein robots.txt-Token.
Diese Liste ist in zwei Punkten anders. Jeder User-Agent unten ist mit der Dokumentation des Betreibers abgeglichen, Stand 20. November 2026. Und wir haben gemessen, wie echte Websites mit diesen Bots umgehen: Wir haben die robots.txt von 3.000 zufällig ausgewählten Websites aus dem Register von Online Web Directory abgerufen und gezählt, welche KI-Crawler sie nennen und sperren. Dazu bekommen Sie getestete Regeln für robots.txt, Nginx und Apache sowie ein Skript, das prüft, ob ein „GPTBot“-Besucher wirklich von OpenAI kommt.
Was ist eine KI-Crawler-Liste? Eine KI-Crawler-Liste ist eine Übersicht der Bots, mit denen KI-Unternehmen Webseiten abrufen: mit dem robots.txt-Token jedes Bots, seinem User-Agent-String und seiner Aufgabe, also Trainingsdaten sammeln, Seiten für die KI-Suche indexieren oder eine Seite live abrufen, weil ein Nutzer danach gefragt hat. Sie brauchen sie, um robots.txt-Regeln zu schreiben, Server-Logs zu lesen und Firewall-Richtlinien festzulegen.
KI-Crawler auf einen Blick
| Frage | Kurze Antwort |
|---|---|
| Wie viele KI-Crawler sind relevant? | Rund 20 dokumentierte User-Agents von 9 Betreibern (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), dazu DuckDuckGo und eine lange Reihe kleinerer Bots. |
| Haupttypen | Trainings-Crawler, KI-Such-Crawler und nutzerausgelöste Abrufer oder Agenten. Google-Extended und Applebot-Extended sind Steuer-Token, keine Crawler. |
| Halten sie sich an robots.txt? | Dokumentierte Trainings- und Such-Crawler sagen Ja. Nutzerausgelöste Abrufer (ChatGPT-User, Perplexity-User, Googles nutzerausgelöste Fetcher, Meta-ExternalFetcher) sagen, dass robots.txt möglicherweise nicht gilt. |
| Kann robots.txt einen 403 auslösen? | Nein. robots.txt ist eine Bitte, kein Schloss. Ein 403 kommt von Ihrem Server, Ihrem CDN oder Ihrer Firewall. |
| Wie oft sperren Websites sie? | In unserer Stichprobe vom 20. Nov. 2026 sperren 16,9 % der robots.txt-Dateien GPTBot vollständig, aber nur 2,8 % OAI-SearchBot. |
| Wie prüfe ich einen Bot? | Gleichen Sie die IP der Anfrage mit der veröffentlichten IP-Liste des Betreibers ab (zum Beispiel https://openai.com/gptbot.json). User-Agents lassen sich mühelos fälschen. |
Die KI-Crawler-Liste (geprüft im November 2026)
Die Tabelle zeigt jedes robots.txt-Token, wer es betreibt, was es laut Betreiber tut und ob der Betreiber angibt, dass es robots.txt befolgt. „Typ“ hat drei Kategorien: Training (sammelt Inhalte, die Modelle trainieren können), Suche (indexiert Seiten, damit ein KI-Produkt sie später zitieren kann) und Nutzer (ruft eine Seite in Echtzeit ab, weil eine Person gefragt hat). Bots, deren Betreiber keine für uns überprüfbare Dokumentation veröffentlicht, haben wir weggelassen.
| robots.txt-Token | Betreiber | Typ | Was er tut | Befolgt robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Training | Crawlt Inhalte, die zum Training der Foundation-Modelle von OpenAI genutzt werden können. | Ja |
OAI-SearchBot |
OpenAI | Suche | Indexiert Seiten, damit sie in den Suchergebnissen von ChatGPT erscheinen können. | Ja |
ChatGPT-User |
OpenAI | Nutzer | Besucht eine Seite, wenn ein Nutzer von ChatGPT oder einem Custom GPT eine Frage stellt. | „Gilt möglicherweise nicht“ |
OAI-AdsBot |
OpenAI | Anzeigenprüfung | Prüft Zielseiten, die als ChatGPT-Anzeigen eingereicht wurden; nicht für Training genutzt. | Besucht nur eingereichte Seiten |
ClaudeBot |
Anthropic | Training | Sammelt Webinhalte, die zum Training der Claude-Modelle beitragen können. | Ja, und beachtet Crawl-delay |
Claude-SearchBot |
Anthropic | Suche | Indexiert Inhalte, um die Suchergebnisse von Claude zu verbessern. | Ja |
Claude-User |
Anthropic | Nutzer | Ruft Seiten ab, wenn ein Claude-Nutzer eine Frage stellt. | Ja, laut Anthropic |
Google-Extended |
Steuer-Token | Entscheidet, ob von Google gecrawlte Inhalte Gemini trainieren oder Gemini-Antworten fundieren dürfen. Kein eigener Crawler. | Nur Token | |
Google-CloudVertexBot |
Vom Inhaber angefordert | Crawlt Websites, deren Inhaber Vertex AI Agents bauen; kein Einfluss auf die Google-Suche. | Ja | |
Google-Agent |
Nutzer | Agenten auf Googles Infrastruktur, die im Auftrag eines Nutzers surfen und handeln. | Nutzerausgelöst: in der Regel nein | |
PerplexityBot |
Perplexity | Suche | Indexiert Seiten für die Suchergebnisse von Perplexity; nicht für Training genutzt. | Ja |
Perplexity-User |
Perplexity | Nutzer | Ruft eine Seite während der Perplexity-Sitzung eines Nutzers ab. | „Ignoriert sie in der Regel“ |
Applebot-Extended |
Apple | Steuer-Token | Entscheidet, ob von Applebot gecrawlte Seiten die Foundation-Modelle von Apple trainieren dürfen. Crawlt nicht selbst. | Nur Token |
meta-externalagent |
Meta | Training | Crawlt für Zwecke wie das Training von KI-Modellen oder das Indexieren von Inhalten. | Ja |
meta-externalfetcher |
Meta | Nutzer | Ruft einzelne Links auf Wunsch eines Nutzers ab, auch für agentische Aufgaben. | „Kann sie umgehen“ |
Amazonbot |
Amazon | Training | Verbessert Produkte und Dienste von Amazon; kann zum Training von Amazons KI-Modellen genutzt werden. | Ja |
Amzn-SearchBot |
Amazon | Suche | Indexiert Seiten für Sucherlebnisse wie Alexa; nicht für Training genutzt. | Ja |
Amzn-User |
Amazon | Nutzer | Ruft Live-Informationen ab, um einem Nutzer zu antworten, etwa bei einer Alexa-Anfrage. | „Befolgt evtl. nicht alle“ |
CCBot |
Common Crawl | Trainingsdaten | Baut das offene Webarchiv von Common Crawl auf, eine verbreitete Quelle für KI-Trainingsdaten. | Ja |
MistralAI-Training |
Mistral AI | Training | Crawlt Inhalte, um Datensätze für das Training der Mistral-Modelle aufzubauen. | Ja |
MistralAI-Index |
Mistral AI | Suche | Indexiert Inhalte für die Mistral-Suche; nicht für Training genutzt. | Ja |
MistralAI-User |
Mistral AI | Nutzer | Besucht eine Seite, wenn ein Nutzer Mistrals Assistenten Vibe eine Frage stellt. | Ja, für Nutzeranfragen |
DuckAssistBot |
DuckDuckGo | Suche | Crawlt Seiten in Echtzeit für die KI-gestützten Antworten von DuckDuckGo. | Ja (wirkt nach 72 Stunden) |
Die Quellen für jede Zeile sind am Ende des Artikels verlinkt. Zitate in der letzten Spalte stammen direkt aus der Dokumentation des Betreibers. Bytespider (ByteDance) fehlt bewusst: Wir haben keine ByteDance-Seite gefunden, die ihn dokumentiert, obwohl 18,5 % der robots.txt-Dateien in unserer Stichprobe ihn nennen. Aus demselben Grund beschreiben wir die lange Reihe von Tokens wie cohere-ai, Diffbot oder omgili nicht; wie oft Websites sie nennen, steht im Datenteil.
Vollständige User-Agent-Strings in Ihren Logs
robots.txt arbeitet mit dem kurzen Token, Ihre Access-Logs zeigen aber den vollständigen String. Dies sind die Beispiele, die die Betreiber veröffentlichen. Versionsnummern ändern sich, also prüfen Sie auf das Token, nicht auf den ganzen String.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
OpenAI weist außerdem darauf hin, dass GPTBot und OAI-SearchBot beim Abruf Ihrer robots.txt einen robots.txt-Marker an den User-Agent anhängen können, damit Sie diese Anfragen auch in Logs ohne Pfadangaben unterscheiden können.
Drei Arten von KI-Crawlern und warum der Unterschied zählt
„KI-Bots“ pauschal als eine Gruppe zu sperren, ist der häufigste Fehler, den wir sehen. Die drei Typen haben unterschiedliche Kosten und Nutzen, und die Betreiber behandeln robots.txt bei jedem anders.
Trainings-Crawler
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot und MistralAI-Training sammeln Seiten, die in Trainingsdaten für Modelle landen können. Wer sie sperrt, verschwindet nicht aus den KI-Suchergebnissen desselben Unternehmens: OpenAI sagt, jede seiner robots.txt-Einstellungen sei unabhängig, Sie können also GPTBot sperren und OAI-SearchBot trotzdem erlauben. In unserer Stichprobe sind Trainings-Crawler die am häufigsten gesperrte Gruppe. 17,3 % der robots.txt-Dateien sperren CCBot vollständig, 16,9 % GPTBot und 15,9 % ClaudeBot.
KI-Such-Crawler
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index und DuckAssistBot indexieren Seiten, damit ein Assistent sie später finden und zitieren kann. Wer sie sperrt, kann aus diesen Antworten herausfallen. Website-Betreiber scheinen das zu wissen: Nur 2,8 % der Dateien sperren OAI-SearchBot vollständig und 5,8 % PerplexityBot, gegenüber 16,9 % bei GPTBot.
Nutzerausgelöste Abrufer und Agenten
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User und Google-Agent handeln jeweils für eine einzelne Person, so wie ein Browser. Mehrere Betreiber sagen, dass robots.txt möglicherweise nicht gilt, weil ein Mensch die Seite angefordert hat. Genau diese Bots nutzen auch Einkaufs- und Buchungsagenten; wer sie sperrt, kann echte Kunden abweisen. 5,9 % der Dateien in unserer Stichprobe sperren ChatGPT-User vollständig.
Steuer-Token, die nicht crawlen
Google-Extended und Applebot-Extended besuchen Ihre Website nie. Google und Apple crawlen wie gewohnt mit Googlebot und Applebot und prüfen dann diese Tokens, um zu entscheiden, ob die Inhalte ihre Modelle trainieren dürfen. Laut Google hat eine Sperre von Google-Extended keinen Einfluss auf die Aufnahme oder das Ranking in der Google-Suche. 14,1 % der untersuchten Dateien sperren Google-Extended vollständig und 13,5 % Applebot-Extended. Google hat außerdem angekündigt, Anfang 2027 das gemeinsame KI-Trainingssignal (user-agent: __usage_ai-training) zu unterstützen; mehr dazu in unserem Leitfaden zum KI-Training-Opt-out in robots.txt.
Alte Tokens, die robots.txt-Dateien immer noch füllen
Die aktuelle Hilfeseite von Anthropic nennt nur ClaudeBot, Claude-User und Claude-SearchBot. Trotzdem nennen noch 15,6 % der untersuchten Dateien anthropic-ai und 13,8 % Claude-Web. Regeln für diese Namen schaden nicht, aber wenn es Ihre einzigen Anthropic-Regeln sind, decken sie die heute dokumentierten Bots möglicherweise nicht ab. Prüfen Sie, ob ClaudeBot ausdrücklich genannt wird.
Wie der Zugriff von KI-Crawlern in der Praxis aussieht
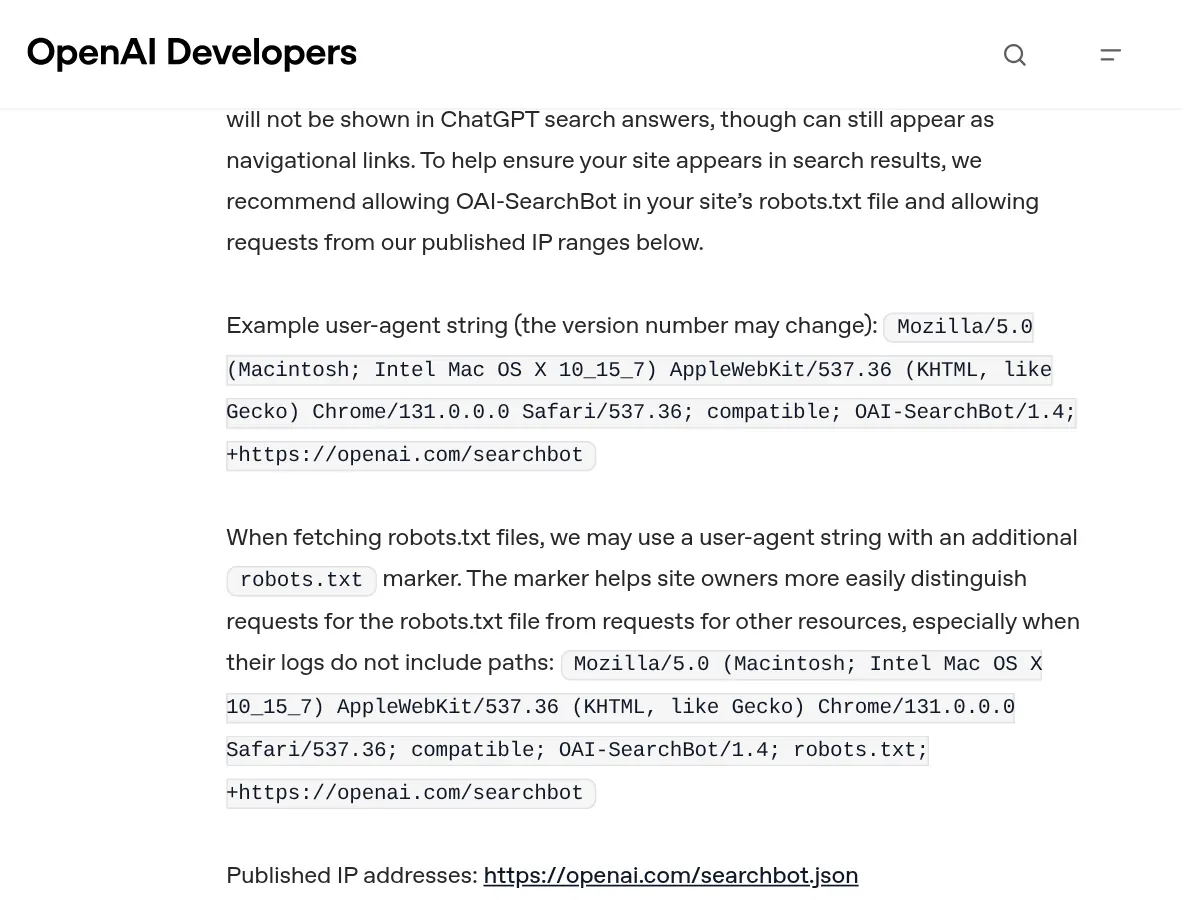
Die Dokumentation der Betreiber ist die maßgebliche Quelle für User-Agents. Die Seite von OpenAI zum Beispiel führt jeden Bot mit einem Beispiel-User-Agent-String, Hinweisen zum robots.txt-Marker und einem Link zur veröffentlichten IP-Datei auf.
Was eine Website tatsächlich mit diesen Bots macht, ist eine andere Frage. Wir haben sechs Startseiten von unserem Server aus mit einem Chrome-User-Agent, dem GPTBot-User-Agent von OpenAI und einem ClaudeBot-User-Agent abgerufen. Unser Server hat eine Rechenzentrums-IP, die viele Bot-Abwehrsysteme misstrauisch behandeln; von einem Heimanschluss aus können die Ergebnisse abweichen.
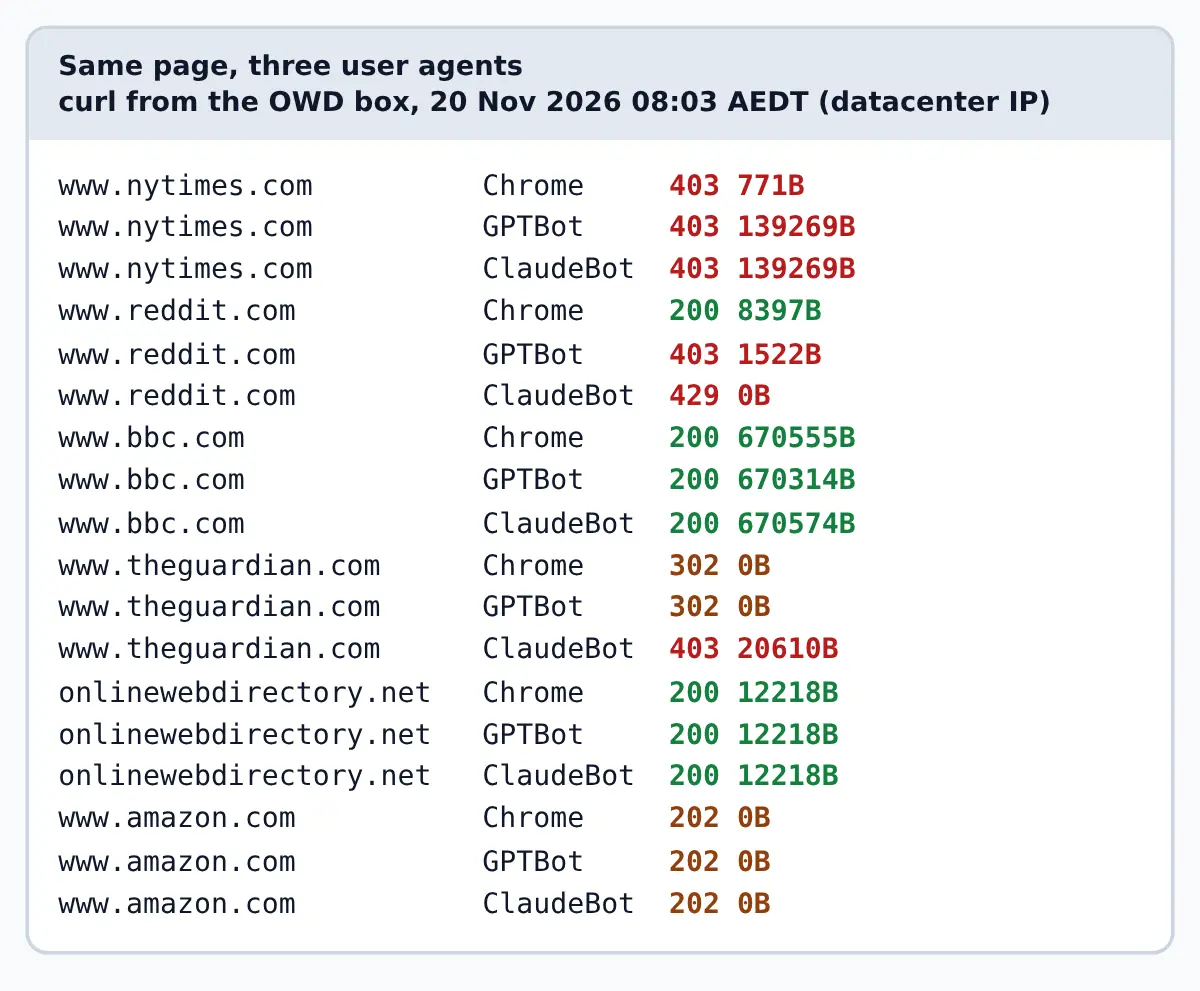
Drei Muster zeigen sich. Reddit lieferte Chrome aus, gab GPTBot aber 403 und ClaudeBot 429 zurück: User-Agent-Filterung auf dem Server oder im CDN. Die New York Times gab allen dreien 403 zurück, was darauf hindeutet, dass die Sperre auf unserer IP oder dem Fingerabdruck der Anfrage beruhte, nicht auf dem User-Agent. Und bbc.com lieferte GPTBot ein 200, obwohl die robots.txt GPTBot, ClaudeBot, CCBot, PerplexityBot und mindestens fünf weitere KI-Tokens sperrt. Klarer lässt sich nicht zeigen, dass robots.txt bittet und nicht durchsetzt. Amazon beantwortete alle drei mit einem 202 und leerem Inhalt, einer Zwischenseite zur Prüfung statt einer echten Seite.
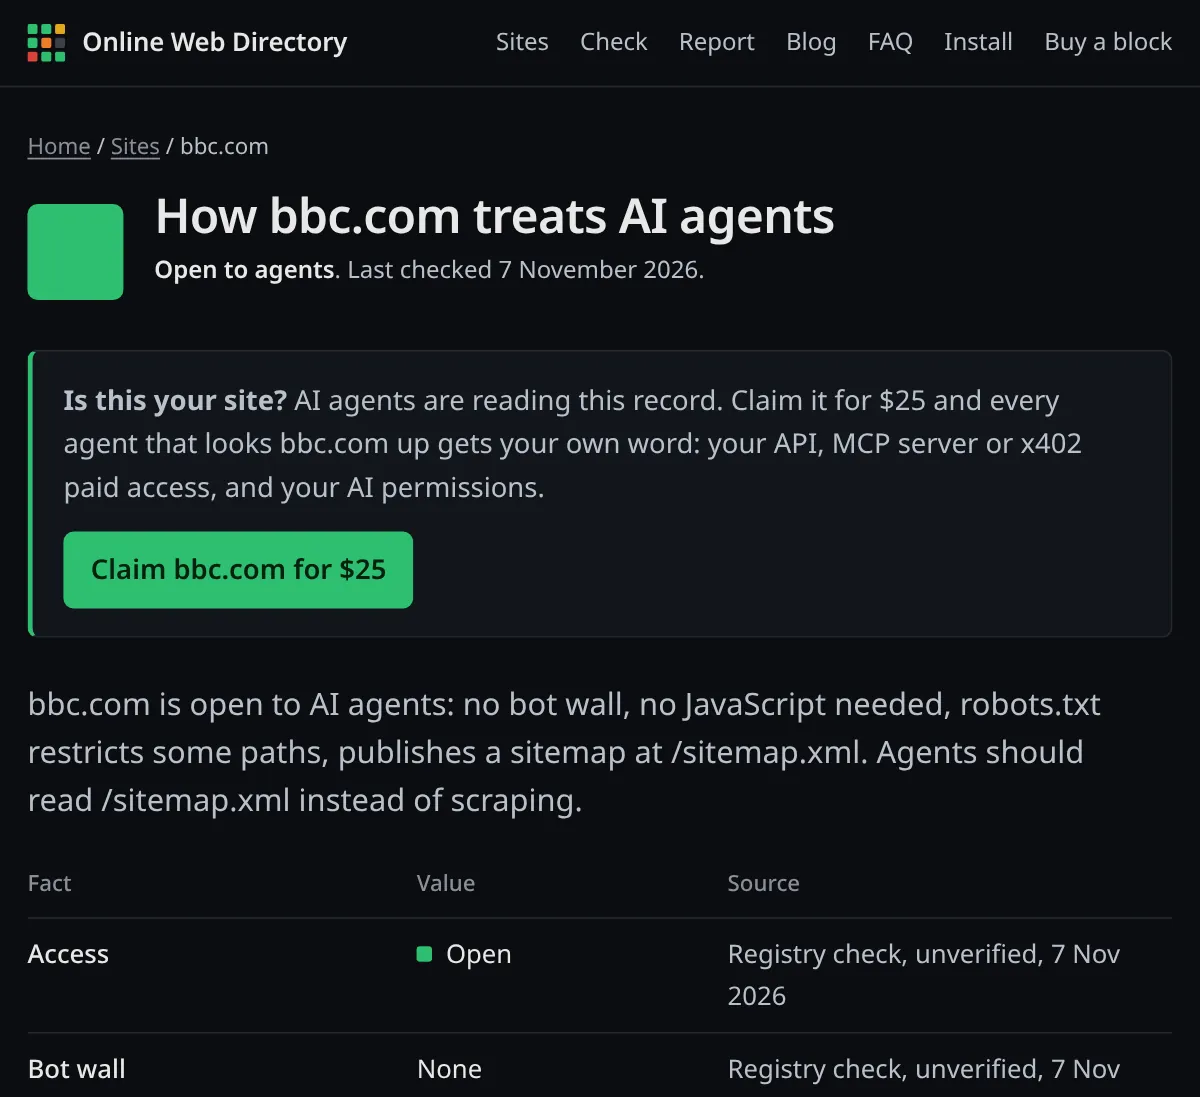
Der Eintrag jeder Website im Online Web Directory hält diese beiden Ebenen getrennt: ob Agenten die Website erreichen und was ihre robots.txt sagt.
So prüfen Sie, welche KI-Crawler Ihre Website erreichen
1. Die robots.txt-Gruppen für KI-Tokens lesen
Beginnen Sie mit dem, worum Sie Crawler bitten. Dieser Befehl gibt jede Gruppe aus, die ein gängiges KI-Token nennt, samt der folgenden Zeile:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Echte Ausgabe für bbc.com am 20. November 2026 um 08:09 AEDT (gekürzt auf vier der neun Gruppen):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Denken Sie daran: Ein Crawler befolgt nur die spezifischste Gruppe, die zu seinem Token passt. Wenn Sie GPTBot in einer eigenen Gruppe nennen, ignoriert er Ihre Regeln unter User-agent: * vollständig; wiederholen Sie gemeinsame Regeln also in der GPTBot-Gruppe.
2. Testen, wie Ihr Server auf KI-User-Agents reagiert
robots.txt kann „Nein“ sagen, während Ihr Server trotzdem „Ja“ sagt, oder umgekehrt. Rufen Sie dieselbe Seite mit verschiedenen User-Agents ab und vergleichen Sie die Statuscodes:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Ersetzen Sie die URL durch Ihre eigene. Ein 403 oder 429 nur für GPTBot bedeutet User-Agent-Filterung. Ein 403 für beide bedeutet meist IP-Reputation oder eine Bot-Prüfung. Testen Sie sowohl von einem Heimanschluss als auch von einem Server aus: Echte Crawler kommen von Rechenzentrums-IPs, das Server-Ergebnis liegt also näher an dem, was sie sehen.
3. KI-Crawler in Ihren Access-Logs finden
Zählen Sie die Zugriffe pro Bot und prüfen Sie dann, welche Statuscodes jeder Bot erhielt. Wir haben diese Befehle am 20. November 2026 auf das Access-Log eines Nginx-Testservers angewendet:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
Der zweite Befehl funktioniert mit dem Standardformat „combined“, in dem der Statuscode auf die Anfragezeile in Anführungszeichen folgt. Ein GPTBot-200 auf /robots.txt plus 403 auf allem anderen ist genau das, was Sie wollen, wenn Sie Trainings-Crawler auf dem Server sperren.
4. Prüfen, ob ein „GPTBot“-Besucher wirklich von OpenAI kommt
Jeder kann einen GPTBot-User-Agent senden. OpenAI, Perplexity, DuckDuckGo, Mistral und Google veröffentlichen IP-Listen, prüfen Sie also die Quell-IP. Dieses Skript testet eine IP gegen die drei Dateien von OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Ausgabe am 20. November 2026 um 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
Zum Zeitpunkt unseres Tests enthielt gptbot.json von OpenAI 18 IPv4-Bereiche mit einem Erstellungsdatum vom 22. September 2026. Rufen Sie die Dateien jedes Mal frisch ab, statt sie fest einzutragen.
5. Ihre Website im Register nachschlagen
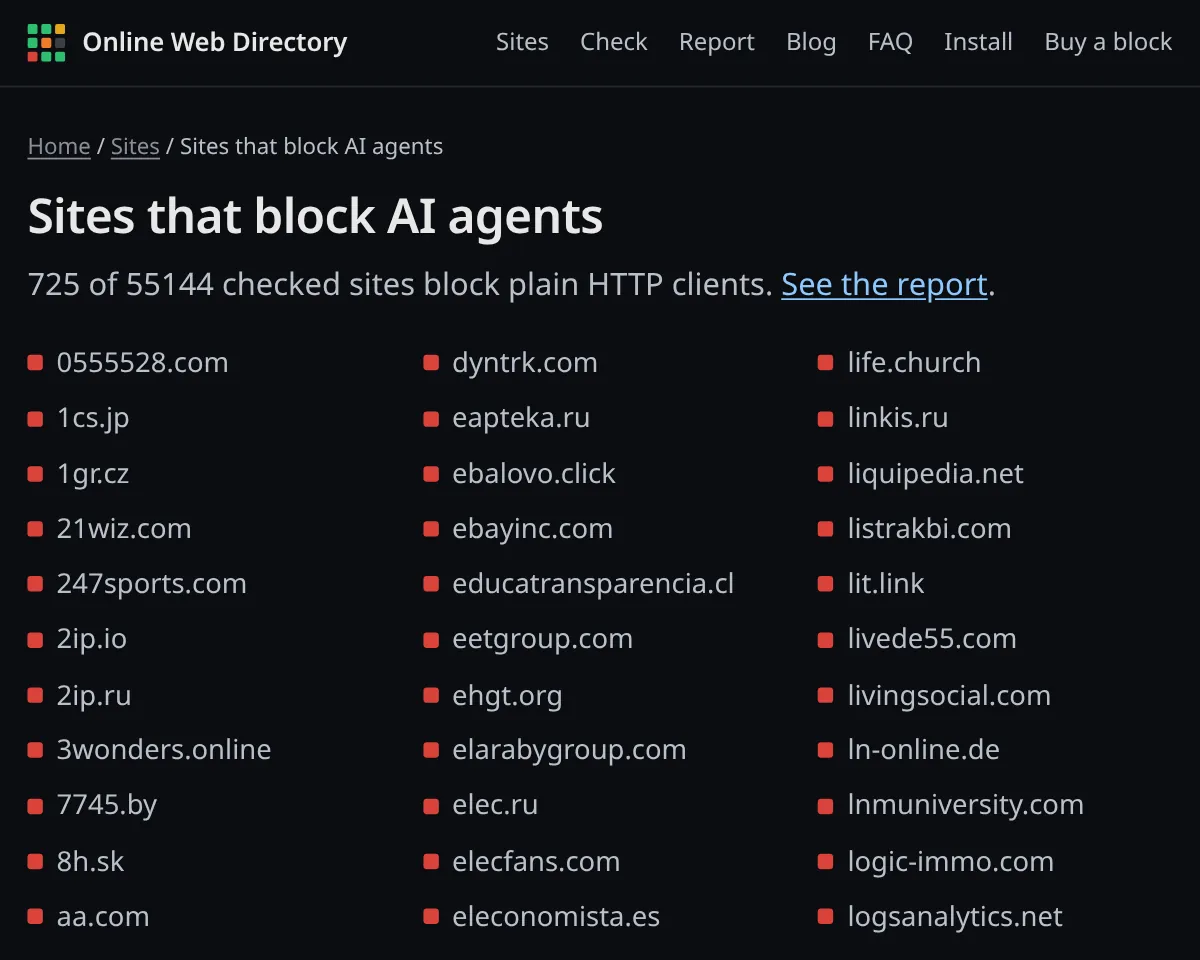
Online Web Directory prüft, wie Websites auf einfache HTTP-Clients reagieren und was ihre robots.txt sagt. Suchen Sie nach Ihrer Domain, zum Beispiel reddit.com oder nytimes.com, oder nutzen Sie den kostenlosen Bereitschafts-Check. Die Liste der Websites, die KI-Agenten sperren, zeigt, welche Domains einfache Clients abweisen.
KI-Crawler steuern: sechs Methoden
Wählen Sie je nach Ziel. Die meisten Websites wollen den Traffic aus der KI-Suche behalten, beim Training von Fall zu Fall entscheiden und nutzerausgelöste Agenten in Ruhe lassen.
Methode 1: Trainings-Crawler sperren, KI-Suche behalten (robots.txt)
Das ist die häufigste Richtlinie unter den Websites unserer Stichprobe. Fügen Sie dies in die /robots.txt im Stammverzeichnis jedes Hosts ein, den Sie betreiben:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Wir haben diese Datei mit Protego getestet, einem Parser nach RFC 9309. Ergebnisse für den Pfad /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Mehrere User-agent-Zeilen über einem gemeinsamen Regelblock sind nach RFC 9309 zulässig. Beachten Sie, dass die Gruppe der KI-Suche die Regel /wp-admin/ nicht von der Gruppe * erbt; ergänzen Sie sie dort, wenn Sie sie brauchen.
Methode 2: Alle dokumentierten KI-Crawler sperren (robots.txt)
Wenn Sie gar keine KI-Nutzung wollen, nehmen Sie die Such- und Nutzer-Tokens in die Sperrgruppe auf: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User und DuckAssistBot. Rechnen Sie damit, aus KI-Antworten zu verschwinden. Und denken Sie daran, dass mehrere nutzerausgelöste Abrufer angeben, robots.txt gelte für sie möglicherweise nicht; das ist also eine Willenserklärung, keine Mauer.
Methode 3: Die Sperre in Nginx durchsetzen
Um Anfragen tatsächlich abzulehnen, filtern Sie auf dem Server. Diese Konfiguration gibt Trainings-Crawlern auf jedem Pfad außer robots.txt einen 403 zurück, damit sie Ihre Regeln weiterhin lesen können. Der map-Block gehört in den http-Kontext:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Wir haben sie am 20. November 2026 mit Nginx 1.26.3 getestet: nginx -t lief fehlerfrei, GPTBot erhielt 403 auf / und 200 auf /robots.txt, Chrome und OAI-SearchBot erhielten auf beiden 200. Ein einzelnes return innerhalb von if gehört zu den Verwendungen, die Nginx als sicher dokumentiert.
Methode 4: Die Sperre in Apache durchsetzen (.htaccess)
Dieselbe Regel für Apache mit mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Getestet mit Apache 2.4.71 und AllowOverride All: GPTBot erhielt 403 auf der Startseite und 200 auf robots.txt; Chrome und OAI-SearchBot erhielten 200. Das Flag [F] sendet 403 Forbidden.
Methode 5: Die KI-Crawler-Richtlinien Ihres CDN nutzen
Wenn Sie Cloudflare nutzen, müssen Sie keine Liste pflegen. Filtern Sie unter Security, Settings nach „Bot traffic“ und öffnen Sie AI Crawler and Agent access policies. Cloudflare erlaubt getrennte Aktionen für Search-, Agent- und Training-Traffic. Laut Dokumentation steht für neue Domains bei allen drei „Allow (do not block)“ voreingestellt, und „Disallow“ für Training ändert nur die robots.txt, solange Bot Preference Sync nicht aktiv ist. Das Dashboard AI Crawl Control von Cloudflare zeigt außerdem, welche Crawler kommen und ob sie Ihre robots.txt befolgen. Von den 62.088 Websites in unserem Register zeigten 6.966 (11,2 %) unserem Prüfprogramm eine Cloudflare-Prüfung.
Methode 6: Erst prüfen, dann erlauben
User-Agent-Regeln sperren ehrliche Bots und übersehen unehrliche. Wenn Sie am Edge sperren, kombinieren Sie die Regel mit einer IP-Prüfung (siehe Schritt 4 oben) und lassen Sie verifizierte Such- und Nutzer-Agenten durch. Anthropic warnt, dass eine Sperre seiner IP-Adressen als Opt-out nicht zuverlässig funktioniert, weil ClaudeBot dann Ihre robots.txt nicht lesen kann. Nutzen Sie robots.txt für die Richtlinie und IP-Prüfungen, um Betrüger zu erkennen.
Was 2.124 robots.txt-Dateien über KI-Crawler verraten
Am 20. November 2026 zwischen 08:01 und 08:03 AEDT haben wir 3.000 Hosts zufällig aus den 62.088 Websites im offenen Datensatz von Online Web Directory gewählt und /robots.txt von unserem Server abgerufen. 2.124 lieferten eine auswertbare Datei. Ein Token gilt als „genannt“, wenn es eine eigene User-agent-Zeile hat, und als „vollständig gesperrt“, wenn diese Gruppe Disallow: / ohne Allow: / enthält.
| robots.txt-Token | Genannt | Vollständig gesperrt |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (veraltet) |
15.6% | 13.3% |
Claude-Web (veraltet) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Vier Ergebnisse stechen heraus:
- Die meisten Websites erwähnen KI-Crawler gar nicht. 629 von 2.124 Dateien (29,6 %) nennen mindestens ein KI-spezifisches Token. Diese nennen dann meist viele: Der Median liegt bei 12 Tokens, und 357 Dateien nennen 10 oder mehr, ein Zeichen für kopierte Sperrlisten.
- Training wird gesperrt, Suche nicht. GPTBot wird sechsmal so oft vollständig gesperrt wie OAI-SearchBot (16,9 % gegenüber 2,8 %).
- robots.txt und tatsächlicher Zugriff widersprechen sich. Von den 358 Websites, die GPTBot in robots.txt vollständig sperren, waren 284 (79 %) in der eigenen Zugriffsprüfung von OWD „offen“: Nichts auf dem Server hielt einen einfachen Client auf.
- Pauschale Verbote sind selten. Nur 13 Dateien (0,6 %) sperren alles für alle User-Agents.
Das gesamte Register erzählt dieselbe Geschichte von der anderen Seite. Dies sind die Zugriffsergebnisse für alle 62.088 Websites, zuletzt geprüft zwischen dem 11. Oktober und dem 19. November 2026:
| Was ein einfacher HTTP-Client vorfand | Websites | Anteil |
|---|---|---|
| Offen | 50,844 | 81.9% |
| Bot-Prüfung | 7,821 | 12.6% |
| Gesperrt | 3,060 | 4.9% |
| Ratenbegrenzt | 199 | 0.3% |
| Anmeldung nötig | 150 | 0.2% |
| Bezahlschranke | 14 | 0.0% |
Laden Sie den vollständigen Datensatz (CC BY 4.0) unter onlinewebdirectory.net/exports/sites.csv herunter oder lesen Sie den Bericht zum Zugriff von KI-Agenten.
Verwandte Fehler und Antworten
- 403 Forbidden. Ihr Server, Ihr CDN oder Ihre Firewall hat die Anfrage abgelehnt. Die Ursache ist nie die robots.txt selbst, und der Zustand ist nicht dauerhaft: Ändern Sie die Regel, und die nächste Anfrage kann gelingen.
- 429 Too Many Requests. Ratenbegrenzung. Reddit gab diesen Code auf unsere ClaudeBot-Anfrage zurück. Anthropic unterstützt
Crawl-delay, eine sanftere Alternative für ClaudeBot. - 202 mit leerem Inhalt oder eine 503-Prüfseite. Meist eine JavaScript- oder CAPTCHA-Prüfung. Crawler können sie nicht lösen; für sie ist die Seite gesperrt, auch wenn kein 403 gesendet wurde.
- robots.txt liefert 4xx. Nach RFC 9309 bedeutet eine Antwort von 400 bis 499, dass die Datei „nicht verfügbar“ ist und Crawler alles abrufen dürfen. In unserer Stichprobe beantworteten 314 von 3.000 Websites (10,5 %) unsere robots.txt-Anfrage mit 403, was ein regelkonformer Crawler als gar keine Regeln lesen würde.
- robots.txt liefert 5xx oder antwortet nicht. Nach RFC 9309 müssen Crawler dann eine vollständige Sperre annehmen; ein Ausfall der robots.txt kann also unbemerkt jeden Crawler aussperren, auch Googlebot.
- robots.txt größer als 500 KiB. RFC 9309 verlangt von Crawlern nur, die ersten 500 KiB zu verarbeiten; Regeln dahinter können ignoriert werden.
Wenn Sie eine llms.txt-Datei für KI-Agenten veröffentlichen, stellen Sie sicher, dass die erlaubten Bots sie auch abrufen können. Unser Leitfaden zu llms.txt zeigt, wie Sie das testen.
Zusammenfassung
Eine genaue KI-Crawler-Liste beginnt mit der Dokumentation der Betreiber, nicht mit anderen Listen. Heute sind das rund 20 User-Agents von 9 Unternehmen in drei Typen: Trainings-Crawler, KI-Such-Crawler und nutzerausgelöste Agenten, dazu zwei Steuer-Token (Google-Extended und Applebot-Extended), die nie crawlen. Die meisten Websites, die handeln, sperren das Training und behalten die Suche, und robots.txt ist nur eine Bitte: Wenn Sie wirklich sperren müssen, setzen Sie das auf dem Server oder im CDN durch und prüfen Sie IPs.
KI-Agenten schlagen Websites schon heute im Online Web Directory nach, bevor sie sie besuchen. Wenn der Eintrag Ihrer Website falsch ist oder Agenten Ihre API, Ihren MCP-Server oder Ihre KI-Berechtigungen kennen sollen, beanspruchen Sie Ihre Website für 25 $. Vorher können Sie den kostenlosen Bereitschafts-Check ausführen.
Häufige Fragen
Welchen User-Agent nutzt ChatGPT?
ChatGPT nutzt drei. GPTBot sammelt Trainingsdaten, OAI-SearchBot indexiert Seiten für die ChatGPT-Suche, und ChatGPT-User ruft eine Seite ab, wenn ein Nutzer fragt. Ihre robots.txt-Tokens sind GPTBot, OAI-SearchBot und ChatGPT-User.
Entfernt eine GPTBot-Sperre meine Website aus der ChatGPT-Suche?
Nein. OpenAI steuert die Suche über OAI-SearchBot. Sie können GPTBot sperren, um dem Training zu widersprechen, und OAI-SearchBot trotzdem erlauben, damit Ihre Seiten in der ChatGPT-Suche erscheinen und zitiert werden können.
Ist Google-Extended ein Crawler?
Nein. Laut Google hat Google-Extended keinen eigenen User-Agent. Googlebot übernimmt das Crawlen, und das Token Google-Extended steuert nur, ob diese Inhalte für das Training und die Fundierung von Gemini genutzt werden dürfen. Auf das Ranking in der Google-Suche hat es keinen Einfluss.
Halten sich KI-Crawler an robots.txt?
Die dokumentierten Trainings- und Such-Crawler in dieser Liste sagen Ja. Nutzerausgelöste Abrufer wie ChatGPT-User, Perplexity-User und Meta-ExternalFetcher sagen, dass robots.txt möglicherweise nicht gilt, weil eine Person die Seite angefordert hat. Undokumentierte Scraper ignorieren sie unter Umständen ganz.
Woran erkenne ich, ob ein Bot wirklich GPTBot oder ClaudeBot ist?
Prüfen Sie die Quell-IP. OpenAI veröffentlicht Bereiche in gptbot.json, searchbot.json und chatgpt-user.json; Perplexity, DuckDuckGo, Mistral und Google veröffentlichen eigene. Ein passender User-Agent von einer nicht gelisteten IP ist ein Betrüger.
Quellen
- OpenAI, Overview of OpenAI crawlers (abgerufen am 20. Nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers und user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies und AI Crawl Control
- Online Web Directory, offener Website-Datensatz (62.088 Websites, exportiert am 20. Nov. 2026) und unsere robots.txt-Stichprobe von 3.000 Hosts