

Bulacağınız “AI tarayıcı listelerinin” çoğu birbirinden kopyalanmıştır ve birçoğu güncel değildir. Hâlâ Claude-Web‘i Anthropic’in tarayıcısı olarak gösterir, “Googlebot-Extended” diye bir bot uydurur ya da Google-Extended’in sayfalarınızı taradığını söylerler. Taramaz. Google-Extended’in kendine ait bir user agent’ı yoktur; yalnızca bir robots.txt token’ıdır.
Bu liste iki açıdan farklı. Aşağıdaki her user agent, 20 Kasım 2026 itibarıyla operatörün kendi belgelerine göre doğrulandı. Ayrıca gerçek sitelerin bu botlara nasıl davrandığını ölçtük: Online Web Directory kaydından rastgele seçilen 3.000 sitenin robots.txt dosyasını indirdik ve hangi AI tarayıcılarını andıklarını ve engellediklerini saydık. Ayrıca robots.txt, Nginx ve Apache için test edilmiş kurallar ve bir “GPTBot” ziyaretçisinin gerçekten OpenAI’dan gelip gelmediğini kontrol eden bir betik de bulacaksınız.
AI tarayıcı listesi nedir? AI tarayıcı listesi, yapay zekâ şirketlerinin web sayfalarını almak için kullandığı botların bir başvuru listesidir; her botun robots.txt token’ını, user agent dizesini ve görevini gösterir: eğitim verisi toplamak, AI araması için sayfaları dizine eklemek ya da bir kullanıcı istediği için bir sayfayı anında getirmek. robots.txt kuralları yazmak, sunucu günlüklerini okumak ve güvenlik duvarı politikaları belirlemek için kullanılır.
Bir bakışta AI tarayıcıları
| Soru | Kısa cevap |
|---|---|
| Kaç AI tarayıcısı önemli? | 9 operatörden (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral) yaklaşık 20 belgelenmiş user agent, ayrıca DuckDuckGo ve uzun bir küçük bot kuyruğu. |
| Ana türler | Eğitim tarayıcıları, AI arama tarayıcıları ve kullanıcı tarafından tetiklenen ajanlar veya getiriciler. Google-Extended ve Applebot-Extended tarayıcı değil, kontrol token’larıdır. |
| robots.txt’ye uyarlar mı? | Belgelenmiş eğitim ve arama tarayıcıları uyduklarını söylüyor. Kullanıcı tarafından tetiklenen getiriciler (ChatGPT-User, Perplexity-User, Google’ın kullanıcı tetiklemeli getiricileri, Meta-ExternalFetcher) robots.txt’nin geçerli olmayabileceğini söylüyor. |
| robots.txt 403 hatası döndürebilir mi? | Hayır. robots.txt bir kilit değil, bir ricadır. 403 yanıtı sunucunuzdan, CDN’nizden veya güvenlik duvarınızdan gelir. |
| Siteler onları ne sıklıkla engelliyor? | 20 Kasım 2026 örneklemimizde robots.txt dosyalarının %16,9’u GPTBot’u tamamen engelliyor, ancak yalnızca %2,8’i OAI-SearchBot’u tamamen engelliyor. |
| Bir botu nasıl doğrularsınız? | İsteğin IP’sini operatörün yayımladığı IP listesiyle karşılaştırın (örneğin https://openai.com/gptbot.json). User agent kolayca taklit edilebilir. |
AI tarayıcı listesi (Kasım 2026’da doğrulandı)
Tablo her robots.txt token’ını, kimin işlettiğini, operatöre göre ne yaptığını ve operatörün robots.txt’ye uyduğunu söyleyip söylemediğini gösteriyor. “Tür” sütununda üç grup var: eğitim (modelleri eğitebilecek içerik toplar), arama (bir AI ürünü daha sonra alıntılayabilsin diye sayfaları dizine ekler) ve kullanıcı (bir kişi istediği için sayfayı gerçek zamanlı getirir). Operatörü doğrulanabilir belge yayımlamayan botları listeye almadık.
| robots.txt token’ı | Operatör | Tür | Ne yapar | robots.txt’ye uyar mı? |
|---|---|---|---|---|
GPTBot |
OpenAI | Eğitim | OpenAI’ın temel modellerini eğitmek için kullanılabilecek içerikleri tarar. | Evet |
OAI-SearchBot |
OpenAI | Arama | Sayfaları ChatGPT arama sonuçlarında görünebilmeleri için dizine ekler. | Evet |
ChatGPT-User |
OpenAI | Kullanıcı | Bir ChatGPT veya Custom GPT kullanıcısı soru sorduğunda sayfayı ziyaret eder. | “Geçerli olmayabilir” |
OAI-AdsBot |
OpenAI | Reklam kontrolü | ChatGPT reklamı olarak gönderilen açılış sayfalarını kontrol eder; eğitim için kullanılmaz. | Yalnızca gönderilen sayfaları ziyaret eder |
ClaudeBot |
Anthropic | Eğitim | Claude modellerinin eğitimine katkıda bulunabilecek web içeriği toplar. | Evet, Crawl-delay‘e de uyar |
Claude-SearchBot |
Anthropic | Arama | Claude’un arama sonuçlarını iyileştirmek için içerikleri dizine ekler. | Evet |
Claude-User |
Anthropic | Kullanıcı | Bir Claude kullanıcısı soru sorduğunda sayfaları getirir. | Evet, Anthropic’e göre |
Google-Extended |
Kontrol token’ı | Google’ın taradığı içeriğin Gemini’yi eğitip eğitemeyeceğini veya yanıtlarına dayanak olup olamayacağını belirler. Ayrı bir tarayıcı değildir. | Yalnızca token | |
Google-CloudVertexBot |
Site sahibinin talebiyle | Sahipleri Vertex AI Agents oluşturan siteleri tarar; Google Arama’ya etkisi yoktur. | Evet | |
Google-Agent |
Kullanıcı | Bir kullanıcının isteğiyle gezinen ve işlem yapan, Google tarafından barındırılan ajanlar. | Kullanıcı tetiklemeli: genelde hayır | |
PerplexityBot |
Perplexity | Arama | Perplexity arama sonuçları için sayfaları dizine ekler; eğitim için kullanılmaz. | Evet |
Perplexity-User |
Perplexity | Kullanıcı | Bir kullanıcının Perplexity oturumu sırasında sayfa getirir. | “Genelde yok sayar” |
Applebot-Extended |
Apple | Kontrol token’ı | Applebot’un taradığı sayfaların Apple’ın temel modellerini eğitip eğitemeyeceğini belirler. Kendisi hiçbir şey taramaz. | Yalnızca token |
meta-externalagent |
Meta | Eğitim | AI modellerini eğitmek veya içerik dizinlemek gibi amaçlarla tarar. | Evet |
meta-externalfetcher |
Meta | Kullanıcı | Ajan görevleri dahil, kullanıcının isteğiyle belirli bağlantıları getirir. | “Atlayabilir” |
Amazonbot |
Amazon | Eğitim | Amazon ürün ve hizmetlerini geliştirir; Amazon’un AI modellerini eğitmek için kullanılabilir. | Evet |
Amzn-SearchBot |
Amazon | Arama | Alexa gibi arama deneyimleri için sayfaları dizine ekler; eğitim için kullanılmaz. | Evet |
Amzn-User |
Amazon | Kullanıcı | Bir kullanıcıyı yanıtlamak için anlık bilgi getirir, örneğin bir Alexa isteği. | “Hepsine uymayabilir” |
CCBot |
Common Crawl | Eğitim verisi | Yapay zekâ eğitim verisinin yaygın bir kaynağı olan Common Crawl açık web arşivini oluşturur. | Evet |
MistralAI-Training |
Mistral AI | Eğitim | Mistral modelleri için eğitim veri kümeleri oluşturmak amacıyla içerik tarar. | Evet |
MistralAI-Index |
Mistral AI | Arama | Mistral araması için içerikleri dizine ekler; eğitim için kullanılmaz. | Evet |
MistralAI-User |
Mistral AI | Kullanıcı | Bir kullanıcı Mistral’in asistanı Vibe’a soru sorduğunda sayfayı ziyaret eder. | Evet, kullanıcı istekleri için |
DuckAssistBot |
DuckDuckGo | Arama | DuckDuckGo’nun AI destekli yanıtları için sayfaları gerçek zamanlı tarar. | Evet (72 saat sonra geçerli olur) |
Her satırın kaynakları makalenin sonunda bağlantılı. Son sütundaki alıntılar doğrudan operatör belgelerinden alındı. Bytespider (ByteDance) bilerek yok: örneklemimizdeki robots.txt dosyalarının %18,5’i onu ansa da ByteDance’in onu belgeleyen bir sayfasını bulamadık. Aynı nedenle cohere-ai, Diffbot veya omgili gibi uzun token kuyruğunu açıklamıyoruz; ne sıklıkla geçtikleri veri bölümünde.
Günlüklerinizde göreceğiniz tam user agent dizeleri
robots.txt kısa token ile çalışır, ancak erişim günlükleriniz tam dizeyi gösterir. Bunlar operatörlerin yayımladığı örneklerdir. Sürüm numaraları değişir, bu yüzden tam dizeye değil token’a göre filtreleyin.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
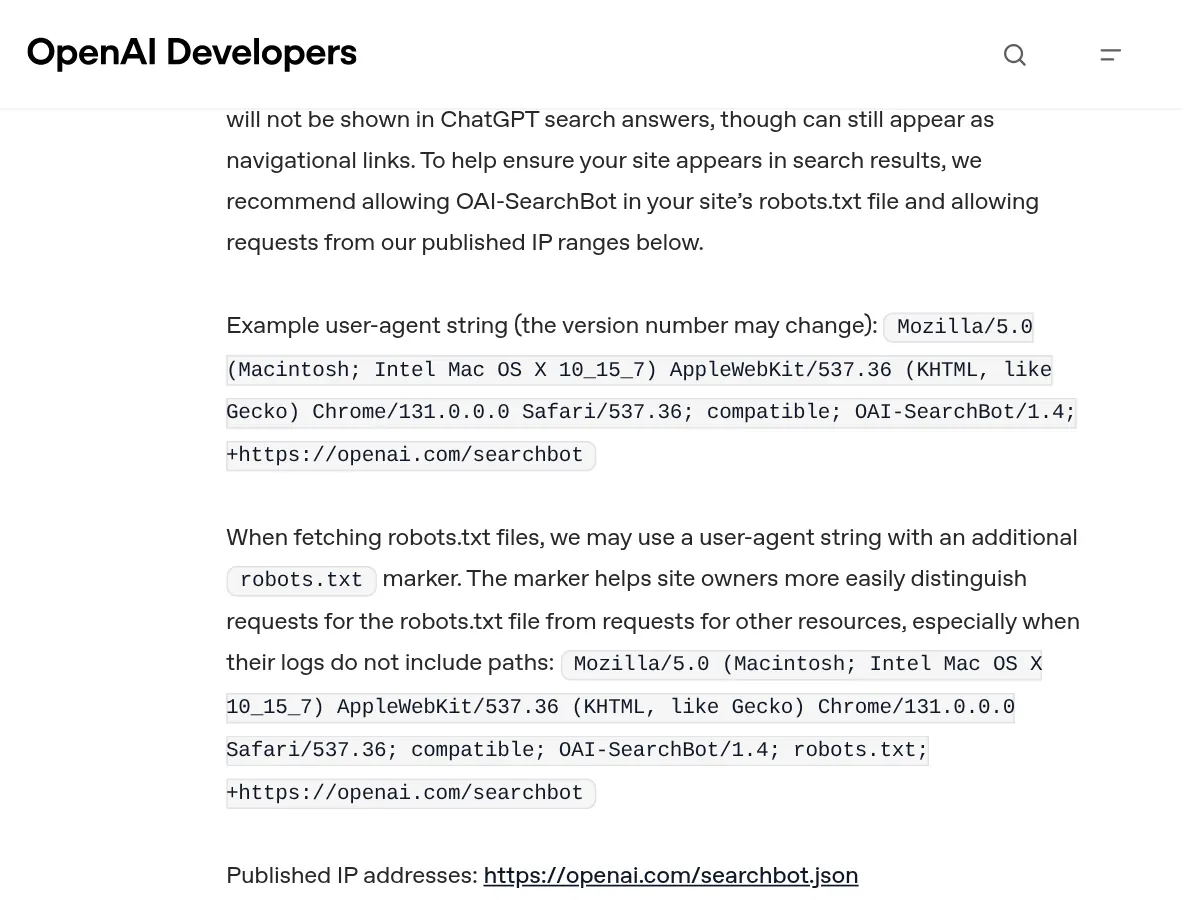
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
OpenAI ayrıca GPTBot ve OAI-SearchBot’un robots.txt dosyanızı alırken user agent’a bir robots.txt işareti ekleyebileceğini belirtiyor; böylece yol içermeyen günlüklerde bu istekleri ayırt edebilirsiniz.
Üç tür AI tarayıcısı ve farkın neden önemli olduğu
“AI botlarını” tek grup olarak engellemek, gördüğümüz en yaygın hata. Üç türün maliyeti ve faydası farklıdır ve operatörler robots.txt’yi her biri için farklı uygular.
Eğitim tarayıcıları
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot ve MistralAI-Training, eğitim verisine girebilecek sayfaları toplar. Onları engellemek sizi aynı şirketin AI arama sonuçlarından çıkarmaz: OpenAI her robots.txt ayarının bağımsız olduğunu söylüyor, yani GPTBot’u engelleyip OAI-SearchBot’a izin verebilirsiniz. Örneklemimizde en çok engellenen grup eğitim tarayıcıları. robots.txt dosyalarının %17,3’ü CCBot’u, %16,9’u GPTBot’u ve %15,9’u ClaudeBot’u tamamen engelliyor.
AI arama tarayıcıları
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index ve DuckAssistBot, bir asistanın daha sonra bulup alıntılayabilmesi için sayfaları dizine ekler. Onları engellemek sizi bu yanıtların dışında bırakabilir. Site sahipleri bunu biliyor gibi: GPTBot için %16,9’a karşılık dosyaların yalnızca %2,8’i OAI-SearchBot’u, %5,8’i PerplexityBot’u tamamen engelliyor.
Kullanıcı tarafından tetiklenen getiriciler ve ajanlar
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User ve Google-Agent, tıpkı bir tarayıcı gibi her seferinde tek bir kişi adına hareket eder. Sayfayı bir insan istediği için birçok operatör robots.txt’nin geçerli olmayabileceğini söylüyor. Alışveriş ve rezervasyon ajanlarının kullandığı botlar da bunlar; onları engellemek gerçek müşterileri uzaklaştırabilir. Örneklemimizdeki dosyaların %5,9’u ChatGPT-User’ı tamamen engelliyor.
Hiçbir şey taramayan kontrol token’ları
Google-Extended ve Applebot-Extended sitenizi asla ziyaret etmez. Google ve Apple her zamanki gibi Googlebot ve Applebot ile tarar, ardından içeriğin modellerini eğitip eğitemeyeceğine karar vermek için bu token’lara bakar. Google, Google-Extended’i engellemenin Google Arama’ya dahil olmayı veya sıralamayı etkilemediğini söylüyor. İncelenen dosyaların %14,1’i Google-Extended’i, %13,5’i Applebot-Extended’i tamamen engelliyor. Google ayrıca ortak AI eğitim sinyalini (user-agent: __usage_ai-training) 2027 başında desteklemeyi planladığını açıkladı; bunu robots.txt ile AI eğitiminden çıkma rehberimizde ele alıyoruz.
robots.txt dosyalarını hâlâ dolduran eski token’lar
Anthropic’in güncel yardım sayfası yalnızca ClaudeBot, Claude-User ve Claude-SearchBot’u anıyor. Yine de incelenen dosyaların %15,6’sı hâlâ anthropic-ai‘yi, %13,8’i Claude-Web‘i anıyor. Bu adlar için kurallar zarar vermez, ancak Anthropic için tek kurallarınız bunlarsa Anthropic’in bugün belgelediği botları kapsamayabilirler. ClaudeBot‘un açıkça anıldığından emin olun.
AI tarayıcı erişimi pratikte nasıl görünüyor
User agent’lar için esas kaynak operatör belgeleridir. Örneğin OpenAI’ın sayfası her botu örnek bir user agent dizesi, robots.txt işaretiyle ilgili notlar ve yayımlanan IP dosyasına bir bağlantıyla listeliyor.
Bir sitenin bu botlara gerçekte ne yaptığı başka bir konu. Sunucumuzdan altı ana sayfayı bir Chrome user agent’ı, OpenAI’ın GPTBot user agent’ı ve bir ClaudeBot user agent’ı ile istedik. Sunucumuz, birçok bot korumasının şüpheyle baktığı bir veri merkezi IP’si kullanıyor; ev bağlantısından sonuçlar farklı olabilir.
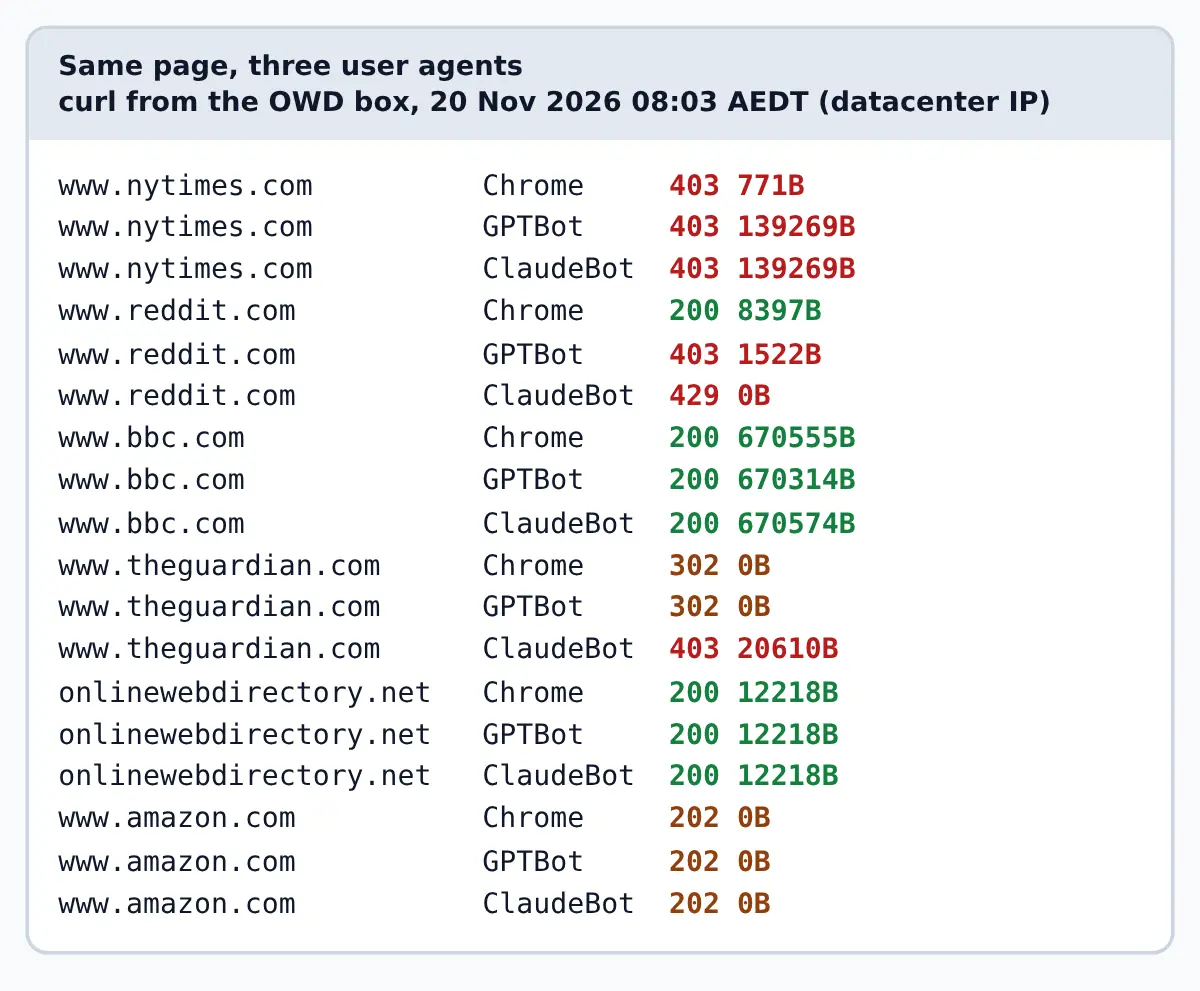
Üç örüntü ortaya çıkıyor. Reddit Chrome’a sayfayı verdi ama GPTBot’a 403, ClaudeBot’a 429 döndürdü: sunucuda veya CDN’de user agent filtrelemesi. The New York Times üçüne de 403 döndürdü; bu, user agent’a değil IP’mize veya istek parmak izine dayalı bir engellemeye işaret ediyor. bbc.com ise robots.txt dosyası GPTBot, ClaudeBot, CCBot, PerplexityBot ve en az beş başka AI token’ını engellediği hâlde GPTBot’a 200 döndürdü. Bu, robots.txt’nin rica ettiğinin ama zorlamadığının en açık kanıtı. Amazon üçüne de boş gövdeli bir 202 ile, gerçek sayfa yerine ara bir doğrulama sayfasıyla yanıt verdi.
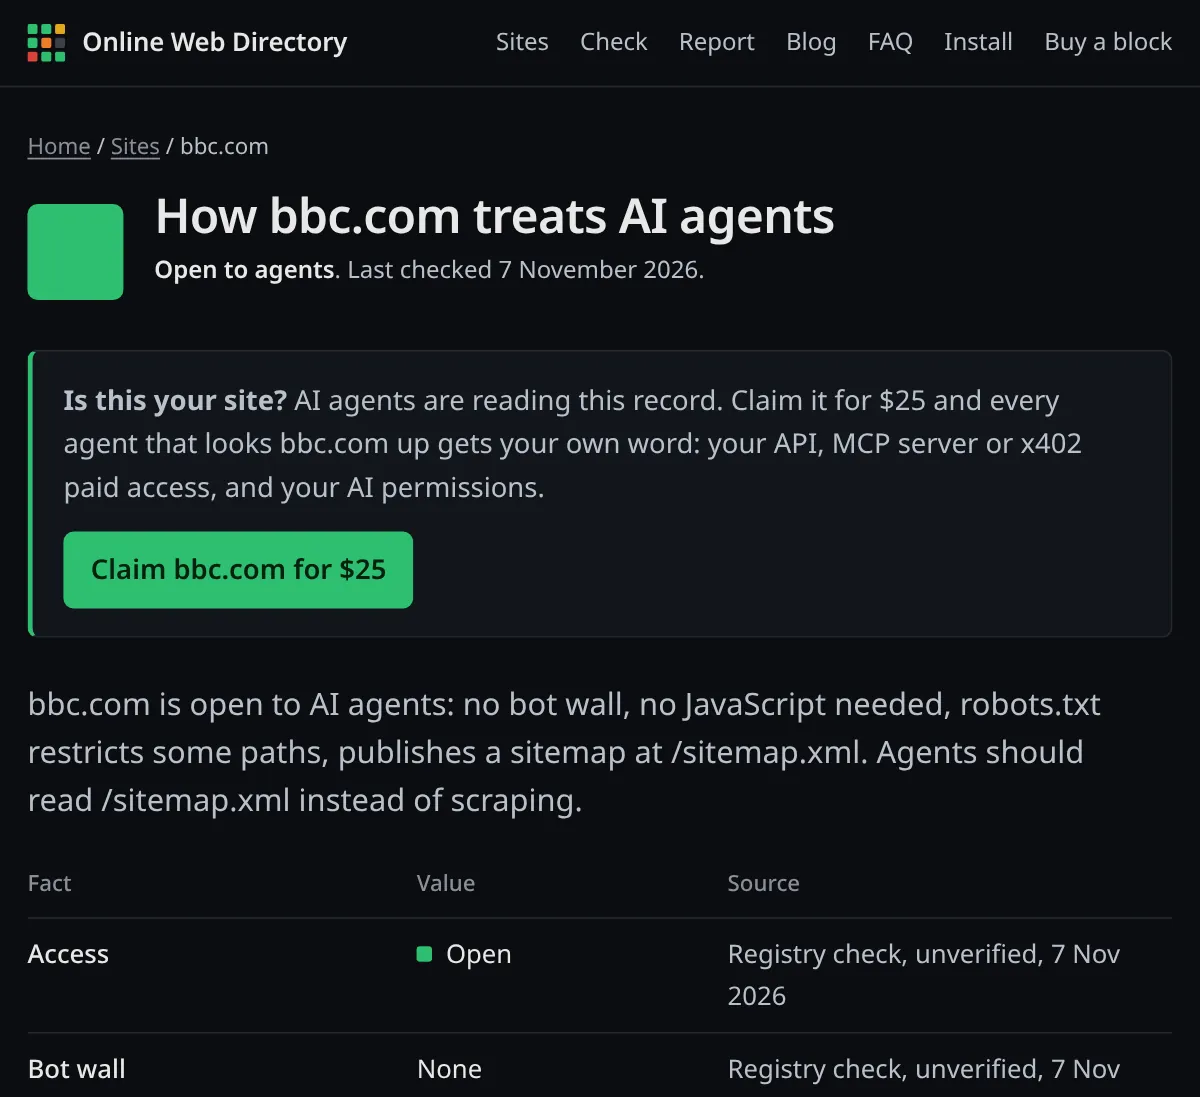
Online Web Directory’deki her site kaydı bu iki katmanı ayırır: ajanların siteye ulaşıp ulaşamadığı ve robots.txt’nin ne dediği.
Sitenize hangi AI tarayıcılarının ulaşabildiğini nasıl kontrol edersiniz
1. robots.txt gruplarınızı AI token’ları için okuyun
Tarayıcılardan ne istediğinizle başlayın. Bu komut, yaygın bir AI token’ını anan her grubu sonraki satırıyla birlikte gösterir:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'bbc.com için 20 Kasım 2026, 08:09 AEDT’deki gerçek çıktı (dokuz gruptan dördüne kısaltıldı):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Bir tarayıcının yalnızca token’ıyla eşleşen en özel gruba uyduğunu unutmayın. GPTBot‘u kendi grubunda anarsanız User-agent: * kurallarınızı tamamen yok sayar; ortak kuralları GPTBot grubunda tekrarlayın.
2. Sunucunuzun AI user agent’larına yanıtını test edin
robots.txt “hayır” derken sunucunuz hâlâ “evet” diyebilir ya da tersi. Aynı sayfayı farklı user agent’larla isteyin ve durum kodlarını karşılaştırın:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
URL’yi kendinizinkiyle değiştirin. Yalnızca GPTBot için 403 veya 429, user agent filtrelemesine işaret eder. İkisi için de 403 genellikle IP itibarı veya bot doğrulaması demektir. Hem ev bağlantısından hem sunucudan test edin: gerçek tarayıcılar veri merkezi IP’lerinden gelir, bu yüzden sunucu sonucu onların gördüğüne daha yakındır.
3. Erişim günlüklerinizde AI tarayıcılarını bulun
Bot başına istekleri sayın, ardından her botun hangi durum kodlarını aldığını kontrol edin. Bu komutları 20 Kasım 2026’da bir Nginx test sunucusunun erişim günlüğünde çalıştırdık:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
İkinci komut, durum kodunun tırnak içindeki istek satırından sonra geldiği standart “combined” günlük biçimiyle çalışır. Eğitim tarayıcılarını sunucuda engellerken istediğiniz tam olarak şudur: GPTBot için /robots.txt‘de 200, başka her yerde 403.
4. Bir “GPTBot” ziyaretçisinin gerçekten OpenAI’dan geldiğini doğrulayın
Herkes GPTBot user agent’ı gönderebilir. OpenAI, Perplexity, DuckDuckGo, Mistral ve Google IP listeleri yayımlıyor, bu yüzden kaynak IP’yi kontrol edin. Bu betik bir IP’yi OpenAI’ın üç dosyasıyla karşılaştırır:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
20 Kasım 2026, 08:12 AEDT’deki çıktı:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
Testimiz sırasında OpenAI’ın gptbot.json dosyası, oluşturulma tarihi 22 Eylül 2026 olan 18 IPv4 aralığı içeriyordu. Dosyaları koda sabitlemek yerine her seferinde indirin.
5. Sitenizi kayıtta arayın
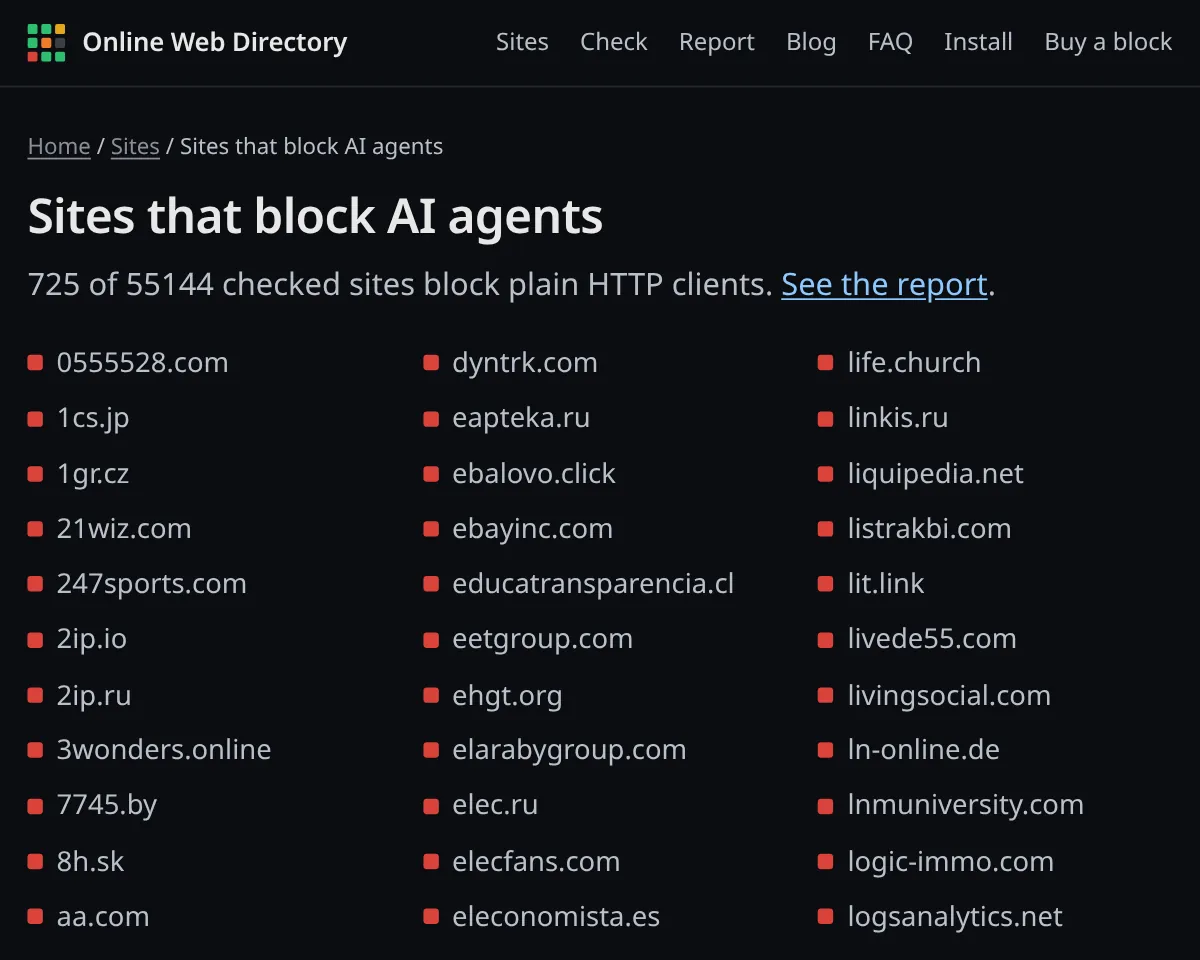
Online Web Directory, sitelerin basit HTTP istemcilerine nasıl yanıt verdiğini ve robots.txt’lerinin ne dediğini kontrol eder. Alan adınızı arayın, örneğin reddit.com veya nytimes.com, ya da ücretsiz hazırlık kontrolünü çalıştırın. AI ajanlarını engelleyen siteler listesi, hangi alan adlarının basit istemcileri reddettiğini gösterir.
AI tarayıcılarını kontrol etmek: altı yöntem
Hedefinize göre seçin. Çoğu site AI arama trafiğini korumak, eğitim konusunda duruma göre karar vermek ve kullanıcı tarafından tetiklenen ajanlara dokunmamak ister.
Yöntem 1: eğitim tarayıcılarını engelleyin, AI aramasını koruyun (robots.txt)
Bu, örneklemimizdeki siteler arasında en yaygın politika. Bunu sunduğunuz her ana makinenin kökündeki /robots.txt dosyasına ekleyin:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Bu dosyayı RFC 9309 uyumlu bir ayrıştırıcı olan Protego ile test ettik. /blog/ yolu için sonuçlar:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Tek bir kural bloğunun üstüne birden çok User-agent satırı yığmak RFC 9309’a göre geçerlidir. AI arama grubunun * grubundaki /wp-admin/ kuralını devralmadığına dikkat edin; gerekiyorsa oraya da ekleyin.
Yöntem 2: tüm belgelenmiş AI tarayıcılarını engelleyin (robots.txt)
Hiçbir AI kullanımı istemiyorsanız arama ve kullanıcı token’larını engellenen gruba ekleyin: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User ve DuckAssistBot. AI yanıtlarından kaybolmayı bekleyin. Ve birkaç kullanıcı tetiklemeli getiricinin robots.txt’nin kendileri için geçerli olmayabileceğini söylediğini unutmayın: bu bir duvar değil, belirtilmiş bir tercihtir.
Yöntem 3: engeli Nginx’te zorunlu kılın
İstekleri gerçekten reddetmek için sunucuda filtreleyin. Bu yapılandırma, eğitim tarayıcılarına robots.txt dışındaki her yolda 403 döndürür; böylece kurallarınızı hâlâ okuyabilirler. map bloğu http bağlamına yerleştirilir:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
20 Kasım 2026’da Nginx 1.26.3 ile test edildi: nginx -t başarılı oldu, GPTBot / için 403, /robots.txt için 200 aldı; Chrome ve OAI-SearchBot ise ikisinde de 200 aldı. Bir if içindeki basit bir return, Nginx’in güvenli olarak belgelediği kullanımlardandır.
Yöntem 4: engeli Apache’de zorunlu kılın (.htaccess)
Aynı kural, mod_rewrite ile Apache için:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
AllowOverride All ile Apache 2.4.71’de test edildi: GPTBot ana sayfada 403, robots.txt’de 200 aldı; Chrome ve OAI-SearchBot 200 aldı. [F] bayrağı 403 Forbidden döndürür.
Yöntem 5: CDN’nizin AI tarayıcı kurallarını kullanın
Cloudflare’de bir liste tutmanıza gerek yok. Security, Settings bölümünde “Bot traffic” ile filtreleyin ve AI Crawler and Agent access policies‘i açın. Cloudflare, Search, Agent ve Training trafiği için ayrı eylemler belirlemenize izin verir. Belgelerine göre yeni alan adları üçü için de varsayılan olarak “Allow (do not block)” ayarındadır ve Training için “Disallow”, Bot Preference Sync’i açana kadar yalnızca robots.txt’yi değiştirir. Cloudflare’in AI Crawl Control panosu, hangi tarayıcıların geldiğini ve robots.txt’nize uyup uymadıklarını da gösterir. Kaydımızdaki 62.088 sitenin 6.966’sı (%11,2) denetleyicimize bir Cloudflare doğrulaması gösterdi.
Yöntem 6: önce doğrulayın, sonra izin verin
User agent kuralları dürüst botları engeller, dürüst olmayanları geçirir. Uçta engelliyorsanız kuralı IP doğrulamasıyla eşleştirin (4. adıma bakın) ve doğrulanmış arama ve kullanıcı ajanlarını geçirin. Anthropic, IP adreslerini engellemenin ClaudeBot’un robots.txt dosyanızı okumasını engellediği için güvenilir bir çıkış yöntemi olmayabileceği konusunda uyarıyor. Politika için robots.txt’yi, taklitçileri yakalamak için IP kontrollerini kullanın.
2.124 robots.txt dosyası AI tarayıcıları hakkında ne söylüyor
20 Kasım 2026’da 08:01 ile 08:03 AEDT arasında Online Web Directory’nin açık veri kümesindeki 62.088 siteden rastgele 3.000 ana makine seçtik ve sunucumuzdan /robots.txt istedik. 2.124’ü ayrıştırılabilir bir dosya döndürdü. Bir token kendi User-agent satırına sahipse “anılmış”, o grup Allow: / olmadan Disallow: / içeriyorsa “tamamen engellenmiş” sayılır.
| robots.txt token’ı | Anılan | Tamamen engellenen |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (eski) |
15.6% | 13.3% |
Claude-Web (eski) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Dört şey öne çıkıyor:
- Çoğu site AI tarayıcılarından hiç söz etmiyor. 2.124 dosyadan 629’u (%29,6) en az bir AI’ye özgü token anıyor. Anan dosyalar çoğu zaman pek çoğunu anıyor: medyan 12 token ve 357 dosya 10 veya daha fazlasını anıyor; bu, kopyalanmış engelleme listelerinin işareti.
- Eğitim engelleniyor, arama engellenmiyor. GPTBot, OAI-SearchBot’tan altı kat daha sık tamamen engelleniyor (%16,9’a karşı %2,8).
- robots.txt ile gerçek erişim örtüşmüyor. robots.txt’de GPTBot’u tamamen engelleyen 358 siteden 284’ü (%79) OWD erişim kontrolünde “açık”tı: sunucuda basit bir istemciyi durduran hiçbir şey yoktu.
- Tam yasaklar nadir. Yalnızca 13 dosya (%0,6) tüm user agent’lara her şeyi yasaklıyor.
Tam kayıt aynı hikâyeyi diğer taraftan anlatıyor. İşte en son 11 Ekim ile 19 Kasım 2026 arasında kontrol edilen 62.088 sitenin tümünün erişim sonuçları:
| Basit bir HTTP istemcisinin karşılaştığı | Siteler | Pay |
|---|---|---|
| Açık | 50,844 | 81.9% |
| Bot doğrulaması | 7,821 | 12.6% |
| Engelli | 3,060 | 4.9% |
| Hız sınırlı | 199 | 0.3% |
| Giriş gerekli | 150 | 0.2% |
| Ödeme duvarı | 14 | 0.0% |
Tam veri kümesini (CC BY 4.0) onlinewebdirectory.net/exports/sites.csv adresinden indirin veya AI ajan erişimi raporuna bakın.
İlgili hatalar ve yanıtlar
- 403 Forbidden. Sunucunuz, CDN’niz veya güvenlik duvarınız isteği reddetti. Bunun nedeni asla robots.txt’nin kendisi değildir ve kalıcı da değildir: kuralı değiştirin, bir sonraki istek başarılı olabilir.
- 429 Too Many Requests. Hız sınırlaması. Reddit bunu ClaudeBot isteğimize döndürdü. Anthropic, ClaudeBot için daha yumuşak bir seçenek olan
Crawl-delay‘i destekliyor. - Boş gövdeli 202 veya 503 doğrulama sayfası. Genellikle bir JavaScript veya CAPTCHA doğrulaması. Tarayıcılar bunu çözemez, bu yüzden 403 olmasa bile sayfa onlar için engellidir.
- robots.txt 4xx döndürüyor. RFC 9309’a göre 400 ile 499 arası bir yanıt dosyanın “kullanılamaz” olduğu ve tarayıcıların her şeyi tarayabileceği anlamına gelir. Örneklemimizde 3.000 siteden 314’ü (%10,5) robots.txt isteğimize 403 ile yanıt verdi; standarda uyan bir tarayıcı bunu kural yok diye okur.
- robots.txt 5xx döndürüyor veya zaman aşımına uğruyor. RFC 9309 bu durumda tarayıcıların tam yasak varsaymasını ister; yani bir robots.txt kesintisi Googlebot dahil tüm tarayıcıları sessizce engelleyebilir.
- 500 KiB’den büyük robots.txt. RFC 9309 tarayıcıların yalnızca ilk 500 KiB’yi ayrıştırmasını şart koşar; ötesindeki kurallar yok sayılabilir.
AI ajanları için bir llms.txt dosyası yayımlıyorsanız izin verilen botların onu gerçekten alabildiğinden emin olun. llms.txt rehberimiz bunun nasıl test edileceğini anlatıyor.
Özet
Güvenilir bir AI tarayıcı listesi başka listelerden değil, operatör belgelerinden başlar. Bugün bu, 9 şirketten yaklaşık 20 user agent anlamına geliyor ve üç türe ayrılıyor: eğitim tarayıcıları, AI arama tarayıcıları ve kullanıcı tarafından tetiklenen ajanlar; buna hiçbir şey taramayan iki kontrol token’ı (Google-Extended ve Applebot-Extended) ekleniyor. Harekete geçen sitelerin çoğu eğitimi engelleyip aramayı koruyor ve robots.txt yalnızca bir rica: gerçek bir engele ihtiyacınız varsa bunu sunucuda veya CDN’de zorunlu kılın ve IP’leri doğrulayın.
AI ajanları siteleri ziyaret etmeden önce Online Web Directory’de arıyor. Sitenizin kaydı yanlışsa veya ajanların API’nizi, MCP sunucunuzu ya da AI izinlerinizi bilmesini istiyorsanız sitenizi 25 $ karşılığında sahiplenin. Önce ücretsiz hazırlık kontrolünü çalıştırabilirsiniz.
Sık sorulan sorular
ChatGPT’nin user agent’ı nedir?
ChatGPT üç tane kullanır. GPTBot eğitim verisi toplar, OAI-SearchBot ChatGPT araması için sayfaları dizine ekler ve ChatGPT-User bir kullanıcı istediğinde sayfayı getirir. robots.txt token’ları GPTBot, OAI-SearchBot ve ChatGPT-User‘dır.
GPTBot’u engellemek sitemi ChatGPT aramasından çıkarır mı?
Hayır. OpenAI aramayı OAI-SearchBot üzerinden yürütür. Eğitimi reddetmek için GPTBot’u engelleyebilir, sayfalarınızın ChatGPT aramasında görünmesi ve alıntılanması için OAI-SearchBot’a izin verebilirsiniz.
Google-Extended bir tarayıcı mı?
Hayır. Google, Google-Extended’in ayrı bir user agent’ı olmadığını söylüyor. Taramayı Googlebot yapar; Google-Extended token’ı yalnızca bu içeriğin Gemini’yi eğitmek ve yanıtlarına dayanak olmak için kullanılıp kullanılamayacağını belirler. Google Arama sıralamasını etkilemez.
AI tarayıcıları robots.txt’ye uyar mı?
Bu listedeki belgelenmiş eğitim ve arama tarayıcıları uyduklarını söylüyor. ChatGPT-User, Perplexity-User ve Meta-ExternalFetcher gibi kullanıcı tarafından tetiklenen getiriciler, sayfayı bir kişi istediği için robots.txt’nin geçerli olmayabileceğini söylüyor. Belgelenmemiş kazıyıcılar onu tamamen yok sayabilir.
Bir botun gerçekten GPTBot veya ClaudeBot olduğunu nasıl anlarım?
Kaynak IP’yi kontrol edin. OpenAI aralıklarını gptbot.json, searchbot.json ve chatgpt-user.json dosyalarında yayımlar; Perplexity, DuckDuckGo, Mistral ve Google da kendilerininkini yayımlar. Listede olmayan bir IP’den gelen eşleşen user agent bir taklitçidir.
Kaynaklar
- OpenAI, Overview of OpenAI crawlers (erişim: 20 Kasım 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers ve user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies ve AI Crawl Control
- Online Web Directory, açık site veri kümesi (62.088 site, 20 Kasım 2026’da dışa aktarıldı) ve 3.000 ana makinelik robots.txt örneklemimiz