

De meeste “AI-crawlerlijsten” die je vindt, zijn van elkaar overgenomen, en veel zijn verouderd. Ze noemen Claude-Web nog als crawler van Anthropic, verzinnen een bot “Googlebot-Extended” of beweren dat Google-Extended je pagina’s crawlt. Dat doet hij niet. Google-Extended heeft geen eigen user agent; het is alleen een robots.txt-token.
Deze lijst is op twee punten anders. Elke user agent hieronder is gecontroleerd tegen de documentatie van de operator, per 20 november 2026. En we hebben gemeten hoe echte sites met deze bots omgaan: we haalden robots.txt op van 3.000 willekeurig gekozen sites uit het register van Online Web Directory en telden welke AI-crawlers ze noemen en blokkeren. Je krijgt ook geteste regels voor robots.txt, Nginx en Apache, plus een script dat controleert of een “GPTBot”-bezoeker echt van OpenAI komt.
Wat is een AI-crawlerlijst? Een AI-crawlerlijst is een overzicht van de bots die AI-bedrijven gebruiken om webpagina’s op te halen, met per bot het robots.txt-token, de user-agentstring en de taak: trainingsdata verzamelen, pagina’s indexeren voor AI-zoeken, of live een pagina ophalen omdat een gebruiker erom vroeg. Je gebruikt hem om robots.txt-regels te schrijven, serverlogs te lezen en firewallbeleid in te stellen.
AI-crawlers in één oogopslag
| Vraag | Kort antwoord |
|---|---|
| Hoeveel AI-crawlers zijn belangrijk? | Ongeveer 20 gedocumenteerde user agents van 9 operators (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), plus DuckDuckGo en een lange staart van kleinere bots. |
| Hoofdtypen | Trainingscrawlers, AI-zoekcrawlers en door gebruikers gestarte agents of fetchers. Google-Extended en Applebot-Extended zijn controletokens, geen crawlers. |
| Volgen ze robots.txt? | De gedocumenteerde trainings- en zoekcrawlers zeggen van wel. Door gebruikers gestarte fetchers (ChatGPT-User, Perplexity-User, de door gebruikers gestarte fetchers van Google, Meta-ExternalFetcher) zeggen dat robots.txt mogelijk niet van toepassing is. |
| Kan robots.txt een 403-fout geven? | Nee. robots.txt is een verzoek, geen slot. Een 403 komt van je server, CDN of firewall. |
| Hoe vaak blokkeren sites ze? | In onze steekproef van 20 nov. 2026 blokkeert 16,9% van de robots.txt-bestanden GPTBot volledig, maar slechts 2,8% blokkeert OAI-SearchBot volledig. |
| Hoe verifieer je een bot? | Vergelijk het IP van het verzoek met de gepubliceerde IP-lijst van de operator (bijvoorbeeld https://openai.com/gptbot.json). Een user agent is makkelijk te vervalsen. |
De AI-crawlerlijst (gecontroleerd in november 2026)
De tabel toont elk robots.txt-token, wie het beheert, wat het volgens de operator doet en of de operator zegt dat het robots.txt volgt. De kolom “Type” gebruikt drie groepen: training (verzamelt content die modellen kan trainen), zoeken (indexeert pagina’s zodat een AI-product ze later kan citeren) en gebruiker (haalt een pagina in realtime op omdat iemand erom vroeg). Bots waarvan de operator geen controleerbare documentatie publiceert, hebben we weggelaten.
| robots.txt-token | Operator | Type | Wat hij doet | Volgt robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Training | Crawlt content die kan worden gebruikt om de basismodellen van OpenAI te trainen. | Ja |
OAI-SearchBot |
OpenAI | Zoeken | Indexeert pagina’s zodat ze in de zoekresultaten van ChatGPT kunnen verschijnen. | Ja |
ChatGPT-User |
OpenAI | Gebruiker | Bezoekt een pagina wanneer een gebruiker van ChatGPT of een Custom GPT een vraag stelt. | “Mogelijk niet van toepassing” |
OAI-AdsBot |
OpenAI | Advertentiecontrole | Controleert landingspagina’s die als ChatGPT-advertenties zijn ingediend; niet gebruikt voor training. | Bezoekt alleen ingediende pagina’s |
ClaudeBot |
Anthropic | Training | Verzamelt webcontent die kan bijdragen aan het trainen van Claude-modellen. | Ja, en respecteert Crawl-delay |
Claude-SearchBot |
Anthropic | Zoeken | Indexeert content om de zoekresultaten van Claude te verbeteren. | Ja |
Claude-User |
Anthropic | Gebruiker | Haalt pagina’s op wanneer een Claude-gebruiker een vraag stelt. | Ja, volgens Anthropic |
Google-Extended |
Controletoken | Bepaalt of content die Google crawlt Gemini mag trainen of zijn antwoorden mag onderbouwen. Geen aparte crawler. | Alleen token | |
Google-CloudVertexBot |
Op verzoek van de eigenaar | Crawlt sites waarvan de eigenaar Vertex AI Agents bouwt; geen effect op Google Zoeken. | Ja | |
Google-Agent |
Gebruiker | Door Google gehoste agents die surfen en acties uitvoeren op verzoek van een gebruiker. | Door gebruiker gestart: meestal niet | |
PerplexityBot |
Perplexity | Zoeken | Indexeert pagina’s voor de zoekresultaten van Perplexity; niet gebruikt voor training. | Ja |
Perplexity-User |
Perplexity | Gebruiker | Haalt een pagina op tijdens de Perplexity-sessie van een gebruiker. | “Negeert het meestal” |
Applebot-Extended |
Apple | Controletoken | Bepaalt of pagina’s die Applebot crawlt de basismodellen van Apple mogen trainen. Crawlt zelf niets. | Alleen token |
meta-externalagent |
Meta | Training | Crawlt voor toepassingen zoals het trainen van AI-modellen of het indexeren van content. | Ja |
meta-externalfetcher |
Meta | Gebruiker | Haalt specifieke links op verzoek van een gebruiker op, ook voor agenttaken. | “Kan het omzeilen” |
Amazonbot |
Amazon | Training | Verbetert producten en diensten van Amazon; kan worden gebruikt om AI-modellen van Amazon te trainen. | Ja |
Amzn-SearchBot |
Amazon | Zoeken | Indexeert pagina’s voor zoekervaringen zoals Alexa; niet gebruikt voor training. | Ja |
Amzn-User |
Amazon | Gebruiker | Haalt live informatie op om een gebruiker te antwoorden, bijvoorbeeld een Alexa-verzoek. | “Volgt mogelijk niet alles” |
CCBot |
Common Crawl | Trainingsdata | Bouwt het open webarchief van Common Crawl, een veelgebruikte bron van AI-trainingsdata. | Ja |
MistralAI-Training |
Mistral AI | Training | Crawlt content om trainingsdatasets voor Mistral-modellen samen te stellen. | Ja |
MistralAI-Index |
Mistral AI | Zoeken | Indexeert content voor Mistral-zoeken; niet gebruikt voor training. | Ja |
MistralAI-User |
Mistral AI | Gebruiker | Bezoekt een pagina wanneer een gebruiker Vibe, de assistent van Mistral, een vraag stelt. | Ja, voor gebruikersverzoeken |
DuckAssistBot |
DuckDuckGo | Zoeken | Crawlt pagina’s in realtime voor de AI-ondersteunde antwoorden van DuckDuckGo. | Ja (actief na 72 uur) |
De bronnen voor elke rij staan onderaan het artikel gelinkt. Citaten in de laatste kolom komen rechtstreeks uit de documentatie van de operator. Bytespider (ByteDance) ontbreekt bewust: we vonden geen pagina van ByteDance die hem documenteert, al noemt 18,5% van de robots.txt-bestanden in onze steekproef hem. Om dezelfde reden beschrijven we de lange staart van tokens zoals cohere-ai, Diffbot of omgili niet; hun frequentie staat in het datadeel.
De volledige user-agentstrings die je in je logs ziet
robots.txt werkt met het korte token, maar je toegangslogs tonen de volledige string. Dit zijn de voorbeelden die operators publiceren. Versienummers veranderen: filter op het token, niet op de hele string.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
OpenAI meldt ook dat GPTBot en OAI-SearchBot een robots.txt-markering aan de user agent kunnen toevoegen wanneer ze je robots.txt ophalen, zodat je die verzoeken kunt herkennen in logs zonder paden.
Drie soorten AI-crawlers, en waarom het verschil telt
“AI-bots” als één groep blokkeren is de meest gemaakte fout die we zien. De drie soorten hebben verschillende kosten en baten, en operators gaan per soort anders met robots.txt om.
Trainingscrawlers
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot en MistralAI-Training verzamelen pagina’s die in trainingsdata kunnen belanden. Ze blokkeren haalt je niet uit de AI-zoekresultaten van hetzelfde bedrijf: OpenAI zegt dat elke robots.txt-instelling onafhankelijk is, dus je kunt GPTBot blokkeren en OAI-SearchBot toestaan. In onze steekproef zijn trainingscrawlers de meest geblokkeerde groep. 17,3% van de robots.txt-bestanden blokkeert CCBot volledig, 16,9% GPTBot en 15,9% ClaudeBot.
AI-zoekcrawlers
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index en DuckAssistBot indexeren pagina’s zodat een assistent ze later kan vinden en citeren. Ze blokkeren kan je uit die antwoorden houden. Site-eigenaren lijken dat te weten: slechts 2,8% van de bestanden blokkeert OAI-SearchBot volledig en 5,8% PerplexityBot, tegenover 16,9% voor GPTBot.
Door gebruikers gestarte fetchers en agents
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User en Google-Agent handelen voor één persoon tegelijk, net als een browser. Verschillende operators zeggen dat robots.txt mogelijk niet van toepassing is, omdat een mens om de pagina vroeg. Dit zijn ook de bots die winkel- en boekingsagents gebruiken: ze blokkeren kan echte klanten wegjagen. 5,9% van de bestanden in onze steekproef blokkeert ChatGPT-User volledig.
Controletokens die niets crawlen
Google-Extended en Applebot-Extended bezoeken je site nooit. Google en Apple crawlen zoals altijd met Googlebot en Applebot en kijken daarna naar deze tokens om te beslissen of de content hun modellen mag trainen. Volgens Google heeft het blokkeren van Google-Extended geen effect op opname of ranking in Google Zoeken. 14,1% van de geanalyseerde bestanden blokkeert Google-Extended volledig en 13,5% Applebot-Extended. Google heeft ook aangekondigd het gedeelde AI-trainingssignaal (user-agent: __usage_ai-training) begin 2027 te willen ondersteunen; dat behandelen we in onze gids voor de opt-out van AI-training in robots.txt.
Oude tokens die robots.txt-bestanden nog vullen
De huidige helppagina van Anthropic noemt alleen ClaudeBot, Claude-User en Claude-SearchBot. Toch noemt 15,6% van de geanalyseerde bestanden nog anthropic-ai en 13,8% Claude-Web. Regels voor die namen kunnen geen kwaad, maar als het je enige Anthropic-regels zijn, dekken ze misschien niet de bots die Anthropic nu documenteert. Controleer of ClaudeBot expliciet genoemd wordt.
Hoe toegang voor AI-crawlers er in de praktijk uitziet
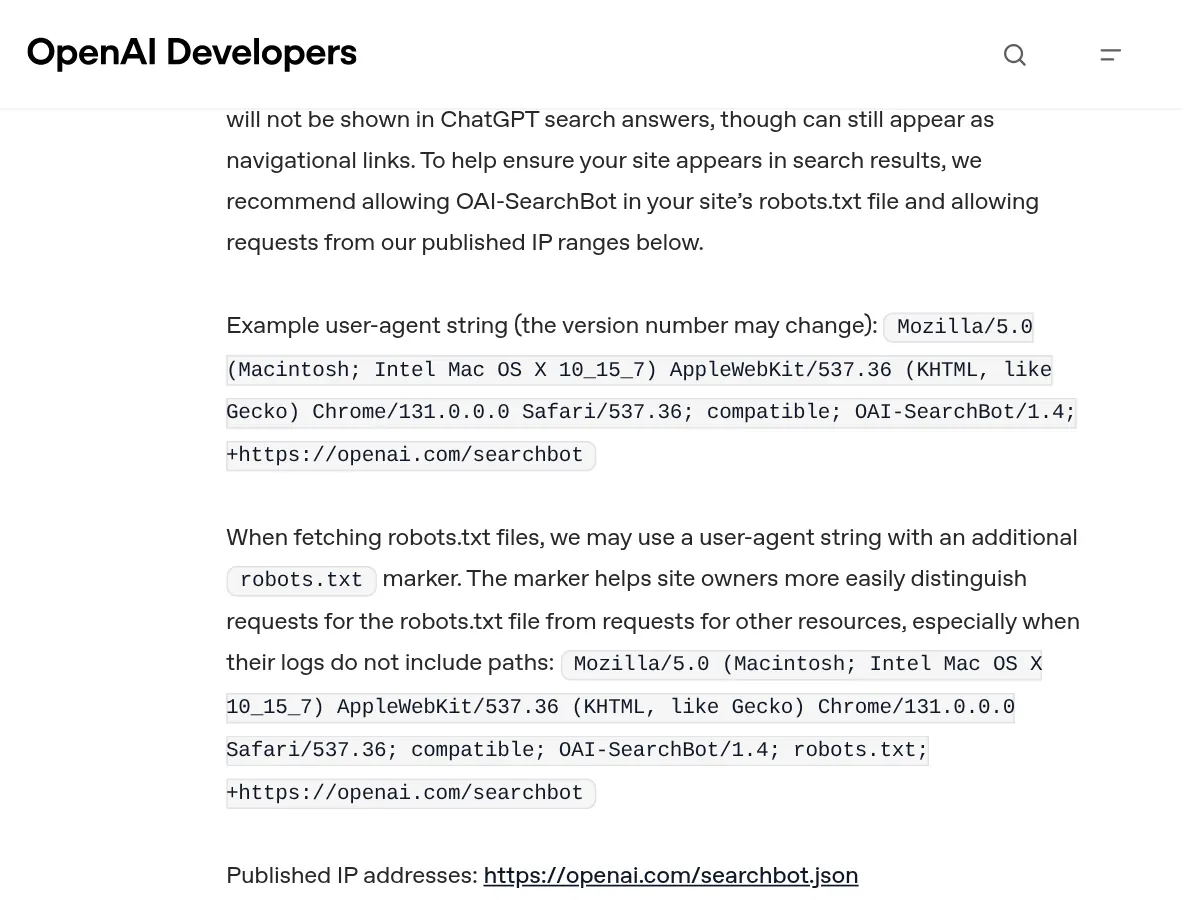
Voor user agents is de documentatie van de operator leidend. De pagina van OpenAI noemt bijvoorbeeld elke bot met een voorbeeld van de user-agentstring, opmerkingen over de robots.txt-markering en een link naar het gepubliceerde IP-bestand.
Wat een site werkelijk met deze bots doet, is een ander verhaal. We vroegen zes homepages op vanaf onze server met een Chrome-user agent, de GPTBot-user agent van OpenAI en een ClaudeBot-user agent. Onze server gebruikt een datacenter-IP, dat veel botbeveiligingen wantrouwen; vanaf een thuisverbinding kunnen de resultaten anders zijn.
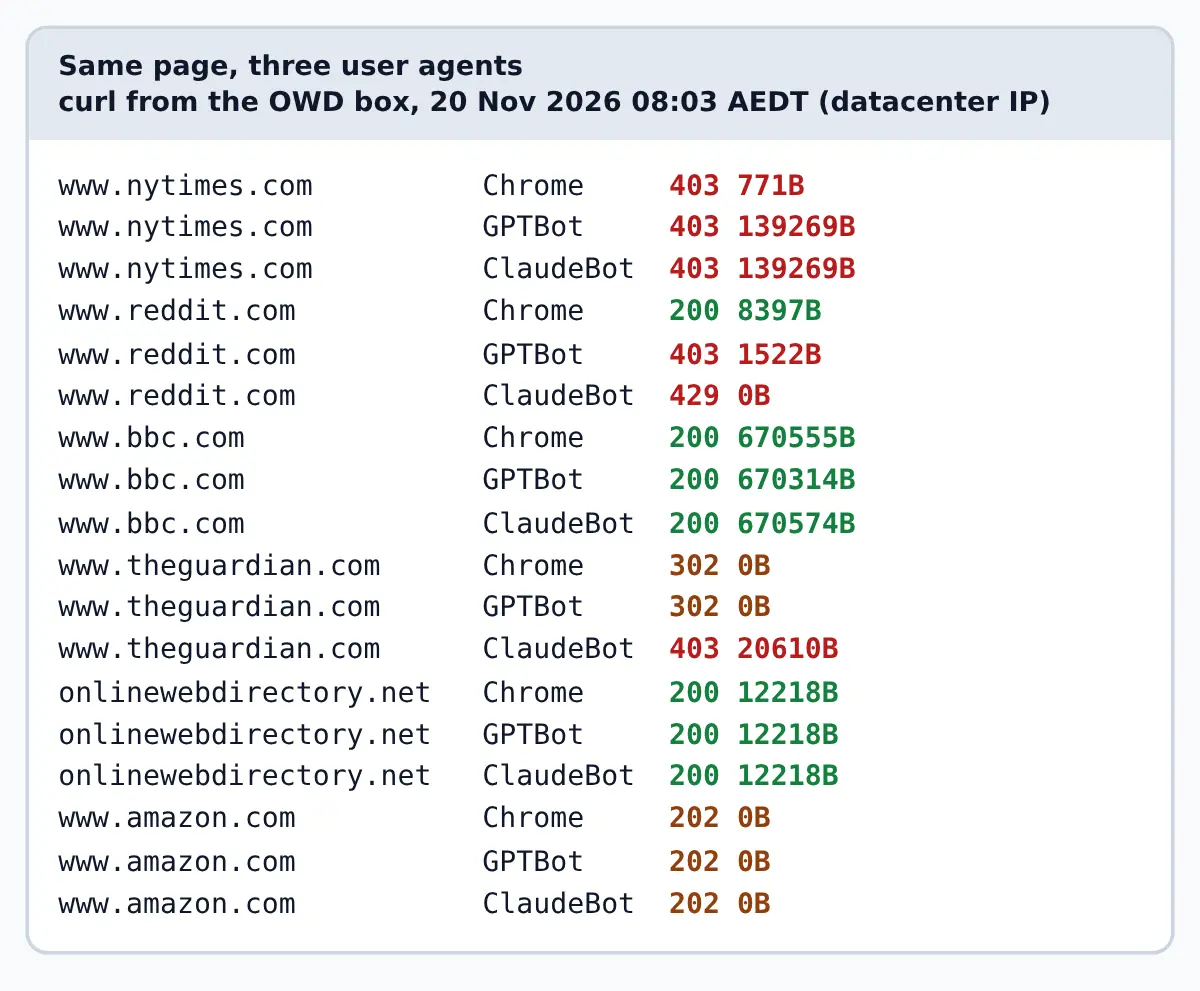
Er zijn drie patronen. Reddit bediende Chrome, maar gaf GPTBot een 403 en ClaudeBot een 429: filtering op user agent op de server of CDN. The New York Times gaf alle drie een 403, wat wijst op blokkering op basis van ons IP of de vingerafdruk van het verzoek, niet op de user agent. En bbc.com gaf GPTBot een 200, terwijl de robots.txt GPTBot, ClaudeBot, CCBot, PerplexityBot en minstens vijf andere AI-tokens blokkeert. Dat is het duidelijkste bewijs dat robots.txt vraagt maar niets afdwingt. Amazon antwoordde alle drie met een 202 met lege body, een tussenliggende controlepagina in plaats van een echte pagina.
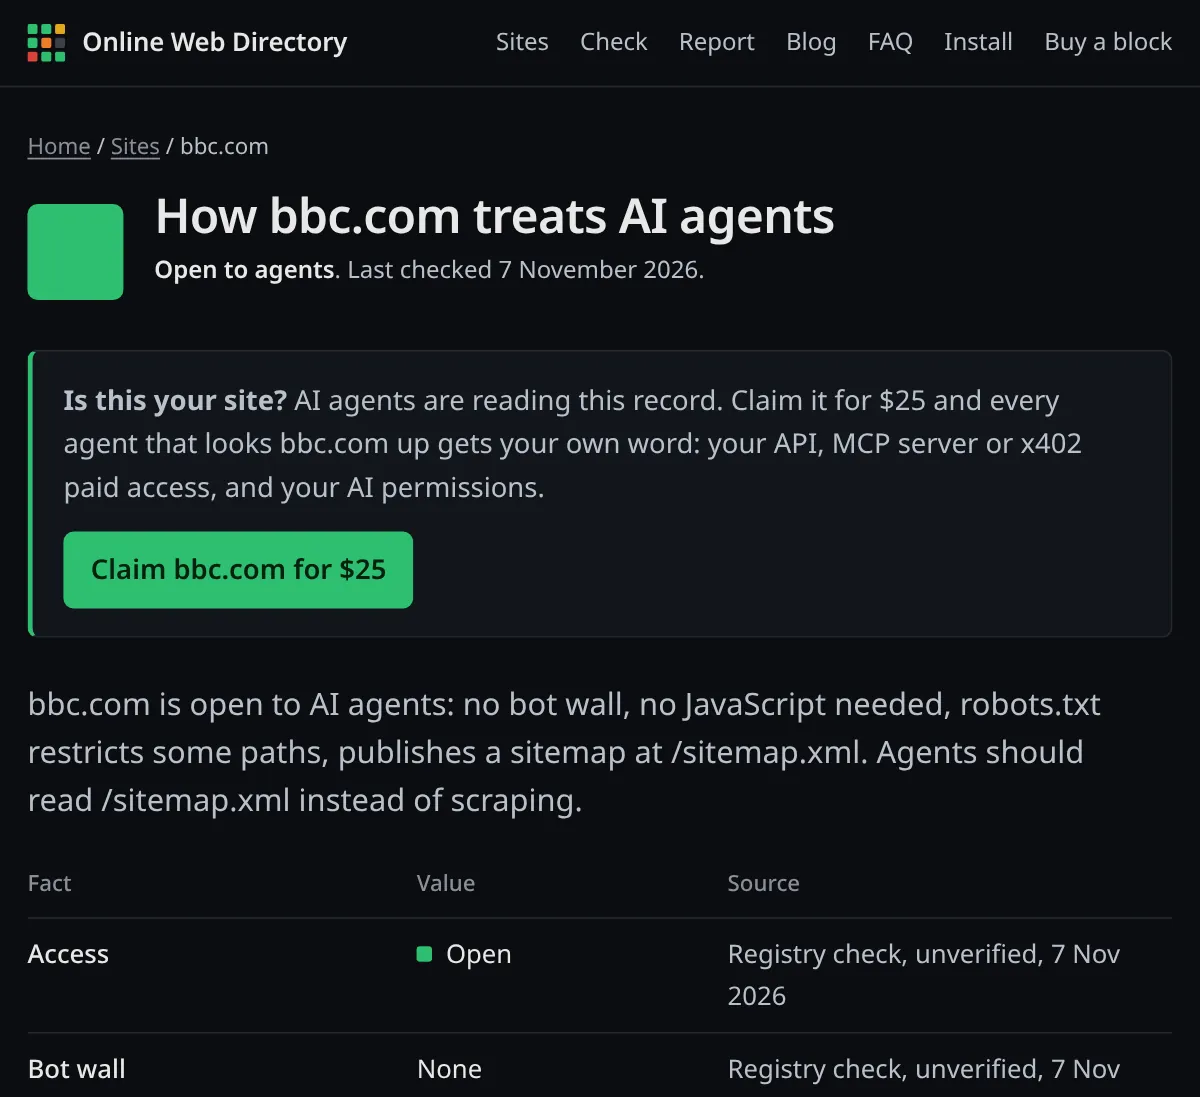
Het profiel van elke site in Online Web Directory scheidt die twee lagen: of agents de site kunnen bereiken, en wat de robots.txt zegt.
Zo controleer je welke AI-crawlers je site kunnen bereiken
1. Lees de groepen in je robots.txt voor AI-tokens
Begin bij wat je crawlers vraagt. Dit commando toont elke groep die een gangbaar AI-token noemt, met de regel erna:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Echte uitvoer voor bbc.com op 20 november 2026 om 08:09 AEDT (ingekort tot vier van de negen groepen):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Onthoud dat een crawler alleen de meest specifieke groep volgt die bij zijn token past. Noem je GPTBot in een eigen groep, dan negeert hij je User-agent: *-regels volledig; herhaal gedeelde regels dus in de GPTBot-groep.
2. Test hoe je server op AI-user agents reageert
robots.txt kan “nee” zeggen terwijl je server nog “ja” zegt, of andersom. Vraag dezelfde pagina op met verschillende user agents en vergelijk de statuscodes:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Vervang de URL door die van jou. Een 403 of 429 alleen voor GPTBot wijst op filtering op user agent. Een 403 voor beide wijst meestal op IP-reputatie of een botcontrole. Test zowel vanaf een thuisverbinding als vanaf een server: echte crawlers komen van datacenter-IP’s, dus het serverresultaat ligt dichter bij wat zij zien.
3. Spoor AI-crawlers op in je toegangslogs
Tel verzoeken per bot en kijk welke statuscodes elke bot kreeg. We draaiden deze commando’s op 20 november 2026 op het toegangslog van een Nginx-testserver:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
Het tweede commando werkt met het standaard logformaat “combined”, waarin de statuscode na de geciteerde verzoekregel staat. Een 200 voor GPTBot op /robots.txt en een 403 overal anders is precies wat je wilt als je trainingscrawlers op de server blokkeert.
4. Controleer of een “GPTBot”-bezoeker echt van OpenAI komt
Iedereen kan een GPTBot-user agent sturen. OpenAI, Perplexity, DuckDuckGo, Mistral en Google publiceren IP-lijsten, dus controleer het bron-IP. Dit script test een IP tegen de drie bestanden van OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Uitvoer op 20 november 2026 om 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
Tijdens onze test bevatte het bestand gptbot.json van OpenAI 18 IPv4-bereiken, met als aanmaakdatum 22 september 2026. Haal de bestanden elke keer op in plaats van ze hard te coderen.
5. Zoek je site op in het register
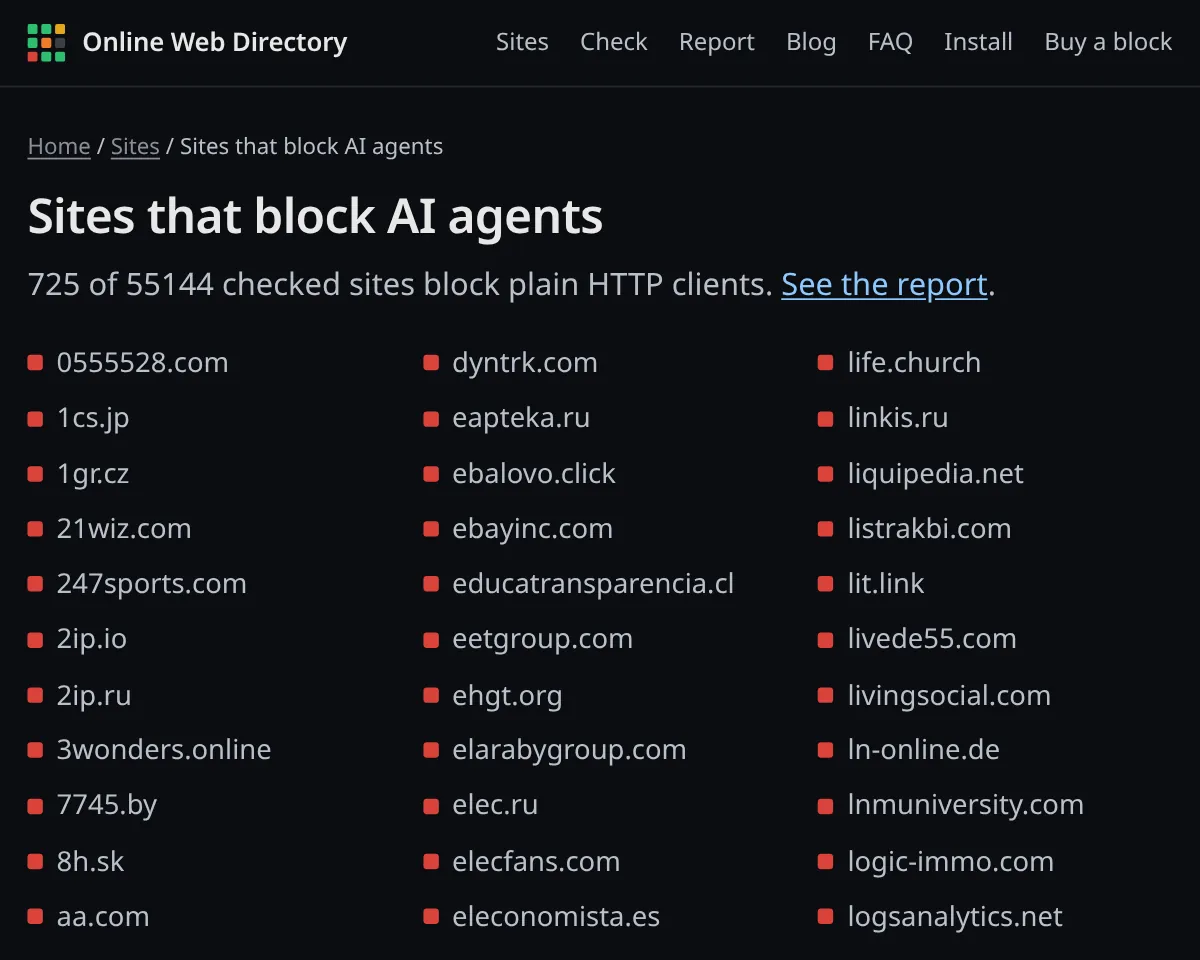
Online Web Directory controleert hoe sites reageren op eenvoudige HTTP-clients en wat hun robots.txt zegt. Zoek je domein op, bijvoorbeeld reddit.com of nytimes.com, of voer de gratis gereedheidscheck uit. De lijst van sites die AI-agents blokkeren toont welke domeinen eenvoudige clients weigeren.
AI-crawlers beheren: zes methoden
Kies op basis van je doel. De meeste sites willen AI-zoekverkeer houden, per geval beslissen over training en door gebruikers gestarte agents met rust laten.
Methode 1: blokkeer trainingscrawlers, houd AI-zoeken (robots.txt)
Dit is het meest gangbare beleid onder de sites in onze steekproef. Voeg dit toe aan /robots.txt in de root van elke host die je bedient:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
We testten dit bestand met Protego, een parser die RFC 9309 volgt. Resultaten voor het pad /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Meerdere User-agent-regels boven één regelblok stapelen is geldig volgens RFC 9309. Let op: de AI-zoekgroep erft de regel /wp-admin/ uit de groep * niet; voeg hem daar ook toe als je hem nodig hebt.
Methode 2: blokkeer alle gedocumenteerde AI-crawlers (robots.txt)
Wil je helemaal geen AI-gebruik, voeg dan de zoek- en gebruikerstokens toe aan de geblokkeerde groep: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User en DuckAssistBot. Reken erop dat je uit AI-antwoorden verdwijnt. En onthoud dat verschillende door gebruikers gestarte fetchers zeggen dat robots.txt mogelijk niet voor hen geldt: het is een uitgesproken voorkeur, geen muur.
Methode 3: dwing de blokkade af in Nginx
Om verzoeken echt te weigeren, filter je op de server. Deze configuratie geeft trainingscrawlers een 403 op elk pad behalve robots.txt, zodat ze je regels nog kunnen lezen. Het map-blok hoort in de http-context:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Getest met Nginx 1.26.3 op 20 november 2026: nginx -t slaagde, GPTBot kreeg 403 op / en 200 op /robots.txt, terwijl Chrome en OAI-SearchBot op beide 200 kregen. Een simpele return binnen een if hoort bij het gebruik dat Nginx als veilig documenteert.
Methode 4: dwing de blokkade af in Apache (.htaccess)
Dezelfde regel voor Apache met mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Getest op Apache 2.4.71 met AllowOverride All: GPTBot kreeg 403 op de homepage en 200 op robots.txt; Chrome en OAI-SearchBot kregen 200. De vlag [F] geeft 403 Forbidden terug.
Methode 5: gebruik de AI-crawlerregels van je CDN
Op Cloudflare hoef je geen lijst bij te houden. Ga naar Security, Settings, filter op “Bot traffic” en open AI Crawler and Agent access policies. Cloudflare laat je aparte acties instellen voor Search-, Agent- en Training-verkeer. Volgens de documentatie staan nieuwe domeinen standaard op “Allow (do not block)” voor alle drie, en wijzigt “Disallow” voor Training alleen robots.txt totdat je Bot Preference Sync inschakelt. Het AI Crawl Control-dashboard van Cloudflare laat ook zien welke crawlers binnenkomen en of ze je robots.txt volgen. Van de 62.088 sites in ons register toonden er 6.966 (11,2%) een Cloudflare-controle aan onze checker.
Methode 6: eerst verifiëren, dan toestaan
Regels op user agent blokkeren eerlijke bots en laten oneerlijke door. Blokkeer je aan de edge, koppel de regel dan aan IP-verificatie (zie stap 4) en laat geverifieerde zoek- en gebruikersagents door. Anthropic waarschuwt dat het blokkeren van zijn IP-adressen mogelijk niet betrouwbaar werkt als opt-out, omdat ClaudeBot dan je robots.txt niet kan lezen. Gebruik robots.txt voor beleid en IP-controles om imitators te vangen.
Wat 2.124 robots.txt-bestanden zeggen over AI-crawlers
Op 20 november 2026 tussen 08:01 en 08:03 AEDT trokken we willekeurig 3.000 hosts uit de 62.088 sites in de open dataset van Online Web Directory en haalden we /robots.txt op vanaf onze server. 2.124 gaven een leesbaar bestand terug. Een token is “genoemd” als het een eigen User-agent-regel heeft, en “volledig geblokkeerd” als die groep Disallow: / bevat zonder Allow: /.
| robots.txt-token | Genoemd | Volledig geblokkeerd |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (verouderd) |
15.6% | 13.3% |
Claude-Web (verouderd) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Vier dingen vallen op:
- De meeste sites noemen AI-crawlers helemaal niet. 629 van de 2.124 bestanden (29,6%) noemen minstens één AI-specifiek token. Wie dat doet, noemt er vaak veel: de mediaan is 12 tokens, en 357 bestanden noemen er 10 of meer, een teken van gekopieerde blokkeerlijsten.
- Training wordt geblokkeerd, zoeken niet. GPTBot wordt zes keer vaker volledig geblokkeerd dan OAI-SearchBot (16,9% tegenover 2,8%).
- robots.txt en echte toegang lopen uiteen. Van de 358 sites die GPTBot in robots.txt volledig blokkeren, waren er 284 (79%) “open” in de toegangscheck van OWD: niets op de server hield een eenvoudige client tegen.
- Volledige verboden zijn zeldzaam. Slechts 13 bestanden (0,6%) verbieden alles voor alle user agents.
Het volledige register vertelt hetzelfde verhaal van de andere kant. Dit zijn de toegangsresultaten van de 62.088 sites, voor het laatst gecontroleerd tussen 11 oktober en 19 november 2026:
| Wat een eenvoudige HTTP-client tegenkwam | Sites | Aandeel |
|---|---|---|
| Open | 50,844 | 81.9% |
| Botcontrole | 7,821 | 12.6% |
| Geblokkeerd | 3,060 | 4.9% |
| Rate-limited | 199 | 0.3% |
| Inloggen vereist | 150 | 0.2% |
| Betaalmuur | 14 | 0.0% |
Download de volledige dataset (CC BY 4.0) via onlinewebdirectory.net/exports/sites.csv of bekijk het rapport over toegang voor AI-agents.
Verwante fouten en reacties
- 403 Forbidden. Je server, CDN of firewall heeft het verzoek geweigerd. Dit komt nooit door robots.txt zelf, en het is niet permanent: pas de regel aan en het volgende verzoek kan slagen.
- 429 Too Many Requests. Rate limiting. Reddit gaf dit terug op ons ClaudeBot-verzoek. Anthropic ondersteunt
Crawl-delay, een zachtere optie voor ClaudeBot. - 202 met lege body, of een 503-controlepagina. Meestal een JavaScript- of CAPTCHA-controle. Crawlers kunnen die niet oplossen, dus voor hen is de pagina geblokkeerd, ook zonder 403.
- robots.txt geeft een 4xx terug. Volgens RFC 9309 betekent een antwoord tussen 400 en 499 dat het bestand “niet beschikbaar” is en dat crawlers alles mogen crawlen. In onze steekproef gaven 314 van de 3.000 sites (10,5%) een 403 op ons robots.txt-verzoek, wat een conforme crawler leest als geen regels.
- robots.txt geeft een 5xx of time-out. RFC 9309 schrijft crawlers voor dan een volledig verbod aan te nemen, dus een robots.txt-storing kan stilletjes elke crawler blokkeren, Googlebot inbegrepen.
- robots.txt groter dan 500 KiB. RFC 9309 verplicht crawlers alleen de eerste 500 KiB te verwerken, dus regels daarna kunnen worden genegeerd.
Publiceer je een llms.txt-bestand voor AI-agents, zorg dan dat toegestane bots het ook echt kunnen ophalen. Onze llms.txt-gids legt uit hoe je dat test.
Samenvatting
Een betrouwbare AI-crawlerlijst begint bij de documentatie van operators, niet bij andere lijsten. Dat zijn nu ongeveer 20 user agents van 9 bedrijven, in drie soorten: trainingscrawlers, AI-zoekcrawlers en door gebruikers gestarte agents, plus twee controletokens (Google-Extended en Applebot-Extended) die nooit crawlen. De meeste sites die actie ondernemen blokkeren training en houden zoeken, en robots.txt is alleen een verzoek: heb je een echte blokkade nodig, dwing die dan af op de server of CDN en controleer IP’s.
AI-agents raadplegen sites al in Online Web Directory voordat ze ze bezoeken. Klopt het profiel van je site niet, of wil je dat agents je API, MCP-server of AI-toestemmingen kennen, claim je site dan voor $25. Je kunt eerst de gratis gereedheidscheck uitvoeren.
Veelgestelde vragen
Wat is de user agent van ChatGPT?
ChatGPT gebruikt er drie. GPTBot verzamelt trainingsdata, OAI-SearchBot indexeert pagina’s voor ChatGPT-zoeken en ChatGPT-User haalt een pagina op wanneer een gebruiker erom vraagt. Hun robots.txt-tokens zijn GPTBot, OAI-SearchBot en ChatGPT-User.
Haalt het blokkeren van GPTBot mijn site uit ChatGPT-zoeken?
Nee. OpenAI regelt zoeken via OAI-SearchBot. Je kunt GPTBot blokkeren om training te weigeren en OAI-SearchBot toestaan zodat je pagina’s verschijnen en geciteerd worden in ChatGPT-zoeken.
Is Google-Extended een crawler?
Nee. Google zegt dat Google-Extended geen aparte user agent heeft. Googlebot crawlt, en het token Google-Extended bepaalt alleen of die content Gemini mag trainen en onderbouwen. Het heeft geen effect op de ranking in Google Zoeken.
Volgen AI-crawlers robots.txt?
De gedocumenteerde trainings- en zoekcrawlers in deze lijst zeggen van wel. Door gebruikers gestarte fetchers zoals ChatGPT-User, Perplexity-User en Meta-ExternalFetcher zeggen dat robots.txt mogelijk niet van toepassing is, omdat een persoon om de pagina vroeg. Niet-gedocumenteerde scrapers kunnen het volledig negeren.
Hoe weet ik of een bot echt GPTBot of ClaudeBot is?
Controleer het bron-IP. OpenAI publiceert zijn bereiken in gptbot.json, searchbot.json en chatgpt-user.json; Perplexity, DuckDuckGo, Mistral en Google publiceren de hunne. Een passende user agent vanaf een niet-vermeld IP is een imitator.
Bronnen
- OpenAI, Overview of OpenAI crawlers (geraadpleegd op 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers en user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies en AI Crawl Control
- Online Web Directory, open sitedataset (62.088 sites, geëxporteerd op 20 nov. 2026) en onze robots.txt-steekproef van 3.000 hosts