

معظم “قوائم زواحف الذكاء الاصطناعي” التي ستجدها منسوخة من بعضها، وكثير منها قديم. فهي لا تزال تذكر Claude-Web كزاحف Anthropic، أو تخترع روبوتًا اسمه “Googlebot-Extended”، أو تقول إن Google-Extended يزحف إلى صفحاتك. هذا غير صحيح. ليس لـ Google-Extended وكيل مستخدم خاص به؛ إنه مجرد رمز في robots.txt.
تختلف هذه القائمة في أمرين. كل وكيل مستخدم أدناه تم التحقق منه مقابل وثائق المشغّل نفسه بتاريخ 20 نوفمبر 2026. كما قسنا كيف تتعامل المواقع الحقيقية مع هذه الروبوتات: جلبنا ملف robots.txt من 3,000 موقع اخترناها عشوائيًا من سجل Online Web Directory، وأحصينا زواحف الذكاء الاصطناعي التي تذكرها وتحظرها. ستجد أيضًا قواعد مُختبرة لـ robots.txt وNginx وApache، وسكربتًا يتحقق مما إذا كان زائر “GPTBot” قادمًا فعلًا من OpenAI.
ما هي قائمة زواحف الذكاء الاصطناعي؟ قائمة زواحف الذكاء الاصطناعي مرجع للروبوتات التي تستخدمها شركات الذكاء الاصطناعي لجلب صفحات الويب، مع رمز robots.txt لكل روبوت وسلسلة وكيل المستخدم ومهمته: جمع بيانات التدريب، أو فهرسة الصفحات للبحث بالذكاء الاصطناعي، أو جلب صفحة مباشرة لأن مستخدمًا طلبها. تستخدمها لكتابة قواعد robots.txt وقراءة سجلات الخادم وضبط سياسات جدار الحماية.
زواحف الذكاء الاصطناعي في لمحة
| السؤال | إجابة مختصرة |
|---|---|
| كم عدد زواحف الذكاء الاصطناعي المهمة؟ | نحو 20 وكيل مستخدم موثّقًا من 9 مشغّلين (OpenAI وAnthropic وGoogle وPerplexity وApple وMeta وAmazon وCommon Crawl وMistral)، إضافة إلى DuckDuckGo وعدد كبير من الروبوتات الصغيرة. |
| الأنواع الرئيسية | زواحف التدريب، وزواحف البحث بالذكاء الاصطناعي، والجالبات أو الوكلاء الذين يشغّلهم المستخدم. Google-Extended وApplebot-Extended رموز تحكم وليست زواحف. |
| هل تلتزم بملف robots.txt؟ | زواحف التدريب والبحث الموثّقة تقول إنها تلتزم. أما الجالبات التي يشغّلها المستخدم (ChatGPT-User وPerplexity-User وجالبات Google التي يشغّلها المستخدم وMeta-ExternalFetcher) فتقول إن robots.txt قد لا ينطبق عليها. |
| هل يمكن لملف robots.txt أن يُرجع 403؟ | لا. ملف robots.txt طلب وليس قفلًا. رمز 403 يأتي من خادمك أو شبكة CDN أو جدار الحماية. |
| كم مرة تحظرها المواقع؟ | في عيّنتنا بتاريخ 20 نوفمبر 2026، تحظر 16.9% من ملفات robots.txt روبوت GPTBot حظرًا كاملًا، بينما تحظر 2.8% فقط OAI-SearchBot حظرًا كاملًا. |
| كيف أتحقق من روبوت؟ | طابِق عنوان IP للطلب مع قائمة عناوين IP التي ينشرها المشغّل (مثل https://openai.com/gptbot.json). تزييف وكيل المستخدم أمر سهل للغاية. |
قائمة زواحف الذكاء الاصطناعي (تم التحقق في نوفمبر 2026)
يعرض الجدول أدناه كل رمز في robots.txt، ومن يشغّله، وما يفعله وفقًا للمشغّل، وما إذا كان المشغّل يقول إنه يلتزم بملف robots.txt. يستخدم عمود “النوع” ثلاث فئات: تدريب (يجمع محتوى قد يُستخدم لتدريب النماذج)، وبحث (يفهرس الصفحات كي يستشهد بها منتج ذكاء اصطناعي لاحقًا)، ومستخدم (يجلب صفحة في الوقت الفعلي لأن شخصًا طلبها). استبعدنا الروبوتات التي لا ينشر مشغّلها وثائق تمكّنا من التحقق منها.
| رمز robots.txt | المشغّل | النوع | ماذا يفعل | يلتزم بـ robots.txt؟ |
|---|---|---|---|---|
GPTBot |
OpenAI | تدريب | يزحف إلى محتوى قد يُستخدم لتدريب النماذج الأساسية لـ OpenAI. | نعم |
OAI-SearchBot |
OpenAI | بحث | يفهرس الصفحات كي تظهر في نتائج بحث ChatGPT. | نعم |
ChatGPT-User |
OpenAI | مستخدم | يزور صفحة عندما يطرح مستخدم ChatGPT أو GPT مخصّص سؤالًا. | “قد لا ينطبق” |
OAI-AdsBot |
OpenAI | فحص الإعلانات | يفحص الصفحات المقصودة المقدَّمة كإعلانات في ChatGPT؛ لا يُستخدم للتدريب. | يزور الصفحات المقدَّمة فقط |
ClaudeBot |
Anthropic | تدريب | يجمع محتوى الويب الذي قد يسهم في تدريب نماذج Claude. | نعم، ويحترم Crawl-delay |
Claude-SearchBot |
Anthropic | بحث | يفهرس المحتوى لتحسين نتائج بحث Claude. | نعم |
Claude-User |
Anthropic | مستخدم | يجلب الصفحات عندما يطرح مستخدم Claude سؤالًا. | نعم، وفقًا لـ Anthropic |
Google-Extended |
رمز تحكم | يحدد ما إذا كان المحتوى الذي تزحف إليه Google يمكن أن يدرّب Gemini أو يدعم إجاباته. لا يوجد زاحف منفصل. | رمز فقط | |
Google-CloudVertexBot |
بطلب المالك | يزحف إلى مواقع المالكين الذين يبنون Vertex AI Agents؛ لا تأثير له على بحث Google. | نعم | |
Google-Agent |
مستخدم | وكلاء يعملون على بنية Google ويتصفحون وينفذون إجراءات بطلب المستخدم. | بتشغيل المستخدم: عمومًا لا | |
PerplexityBot |
Perplexity | بحث | يفهرس الصفحات لنتائج بحث Perplexity؛ لا يُستخدم للتدريب. | نعم |
Perplexity-User |
Perplexity | مستخدم | يجلب صفحة أثناء جلسة المستخدم في Perplexity. | “يتجاهله عمومًا” |
Applebot-Extended |
Apple | رمز تحكم | يحدد ما إذا كانت الصفحات التي زحف إليها Applebot يمكن أن تدرّب النماذج الأساسية لـ Apple. لا يزحف. | رمز فقط |
meta-externalagent |
Meta | تدريب | يزحف لاستخدامات مثل تدريب نماذج الذكاء الاصطناعي أو فهرسة المحتوى. | نعم |
meta-externalfetcher |
Meta | مستخدم | يجلب روابط فردية بطلب المستخدم، بما في ذلك المهام الوكيلية. | “قد يتجاوزه” |
Amazonbot |
Amazon | تدريب | يحسّن منتجات Amazon وخدماتها؛ قد يُستخدم لتدريب نماذج الذكاء الاصطناعي لدى Amazon. | نعم |
Amzn-SearchBot |
Amazon | بحث | يفهرس الصفحات لتجارب البحث مثل Alexa؛ لا يُستخدم للتدريب. | نعم |
Amzn-User |
Amazon | مستخدم | يجلب معلومات حيّة للإجابة على المستخدم، مثل سؤال موجّه إلى Alexa. | “قد لا يلتزم بكل شيء” |
CCBot |
Common Crawl | بيانات التدريب | يبني أرشيف الويب المفتوح Common Crawl، وهو مصدر شائع لبيانات تدريب الذكاء الاصطناعي. | نعم |
MistralAI-Training |
Mistral AI | تدريب | يزحف إلى المحتوى لبناء مجموعات بيانات لتدريب نماذج Mistral. | نعم |
MistralAI-Index |
Mistral AI | بحث | يفهرس المحتوى لبحث Mistral؛ لا يُستخدم للتدريب. | نعم |
MistralAI-User |
Mistral AI | مستخدم | يزور صفحة عندما يطرح مستخدم سؤالًا على مساعد Vibe من Mistral. | نعم، لطلبات المستخدمين |
DuckAssistBot |
DuckDuckGo | بحث | يزحف إلى الصفحات في الوقت الفعلي لإجابات DuckDuckGo المدعومة بالذكاء الاصطناعي. | نعم (يسري بعد 72 ساعة) |
مصادر كل صف مرتبطة في نهاية هذا المقال. الاقتباسات في العمود الأخير مأخوذة مباشرة من وثائق المشغّل. استبعدنا Bytespider (ByteDance) عن قصد: لم نجد صفحة من ByteDance توثّقه، رغم أن 18.5% من ملفات robots.txt التي فحصناها تذكره. وللسبب نفسه لا نصف الرموز الأقل شيوعًا مثل cohere-ai وDiffbot وomgili؛ ستجد في قسم البيانات كم مرة تذكرها المواقع.
سلاسل وكيل المستخدم الكاملة التي ستراها في السجلات
يطابق robots.txt الرمز القصير، لكن سجلات الوصول تعرض السلسلة الكاملة. هذه هي الأمثلة التي ينشرها المشغّلون. أرقام الإصدارات تتغير، لذا طابِق على الرمز لا على السلسلة بأكملها.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
تشير OpenAI أيضًا إلى أن GPTBot وOAI-SearchBot قد يضيفان علامة robots.txt إلى وكيل المستخدم عند جلب ملف robots.txt، لتتمكن من تمييز تلك الطلبات في السجلات التي لا تسجّل المسارات.
ثلاثة أنواع من زواحف الذكاء الاصطناعي، ولماذا يهم الفرق
حظر “روبوتات الذكاء الاصطناعي” كمجموعة واحدة هو أكثر خطأ نراه. للأنواع الثلاثة تكاليف وفوائد مختلفة، ويتعامل المشغّلون مع robots.txt بشكل مختلف لكل منها.
زواحف التدريب
تجمع GPTBot وClaudeBot وCCBot وmeta-externalagent وAmazonbot وMistralAI-Training صفحات قد تنتهي في بيانات تدريب النماذج. حظرها لا يُخرجك من نتائج البحث بالذكاء الاصطناعي لدى الشركة نفسها: تقول OpenAI إن كل إعداد في robots.txt مستقل، لذا يمكنك منع GPTBot والسماح لـ OAI-SearchBot. في عيّنتنا، زواحف التدريب هي الفئة الأكثر حظرًا: 17.3% من ملفات robots.txt تمنع CCBot كليًا، و16.9% تمنع GPTBot، و15.9% تمنع ClaudeBot.
زواحف البحث بالذكاء الاصطناعي
تفهرس OAI-SearchBot وClaude-SearchBot وPerplexityBot وAmzn-SearchBot وMistralAI-Index وDuckAssistBot الصفحات كي يجدها المساعد ويستشهد بها لاحقًا. حظرها قد يُبعدك عن تلك الإجابات. ويبدو أن أصحاب المواقع يعرفون ذلك: 2.8% فقط من الملفات تحظر OAI-SearchBot كليًا و5.8% تحظر PerplexityBot، مقابل 16.9% لـ GPTBot.
الجالبات والوكلاء الذين يشغّلهم المستخدم
يعمل ChatGPT-User وClaude-User وPerplexity-User وmeta-externalfetcher وAmzn-User وMistralAI-User وGoogle-Agent لصالح شخص واحد في كل مرة، كما يفعل المتصفح. يقول عدة مشغّلين إن robots.txt قد لا ينطبق لأن إنسانًا طلب الصفحة. وهذه أيضًا الروبوتات التي يستخدمها وكلاء التسوق والحجز، لذا قد يؤدي حظرها إلى صدّ عملاء حقيقيين. 5.9% من الملفات في عيّنتنا تحظر ChatGPT-User كليًا.
رموز تحكم لا تزحف
لا يزور Google-Extended ولا Applebot-Extended موقعك أبدًا. تزحف Google وApple باستخدام Googlebot وApplebot كالمعتاد، ثم تتحقق من هذه الرموز لتقرر ما إذا كان المحتوى يمكن أن يدرّب نماذجها. وفقًا لـ Google، منع Google-Extended لا يؤثر على الظهور أو الترتيب في بحث Google. 14.1% من الملفات المفحوصة تحظر Google-Extended كليًا و13.5% تحظر Applebot-Extended. وقالت Google أيضًا إنها تخطط لدعم إشارة تدريب الذكاء الاصطناعي المشتركة (user-agent: __usage_ai-training) في أوائل 2027؛ نشرح ذلك في دليلنا لإلغاء الاشتراك في تدريب الذكاء الاصطناعي عبر robots.txt.
رموز قديمة لا تزال تملأ ملفات robots.txt
صفحة المساعدة الحالية لـ Anthropic تذكر ClaudeBot وClaude-User وClaude-SearchBot فقط. ومع ذلك لا تزال 15.6% من الملفات المفحوصة تذكر anthropic-ai و13.8% تذكر Claude-Web. القواعد الخاصة بهذه الأسماء غير ضارة، لكن إن كانت قواعدك الوحيدة لـ Anthropic فقد لا تغطي الروبوتات التي توثّقها Anthropic اليوم. تأكد من ذكر ClaudeBot صراحةً.
كيف يبدو وصول زواحف الذكاء الاصطناعي عمليًا
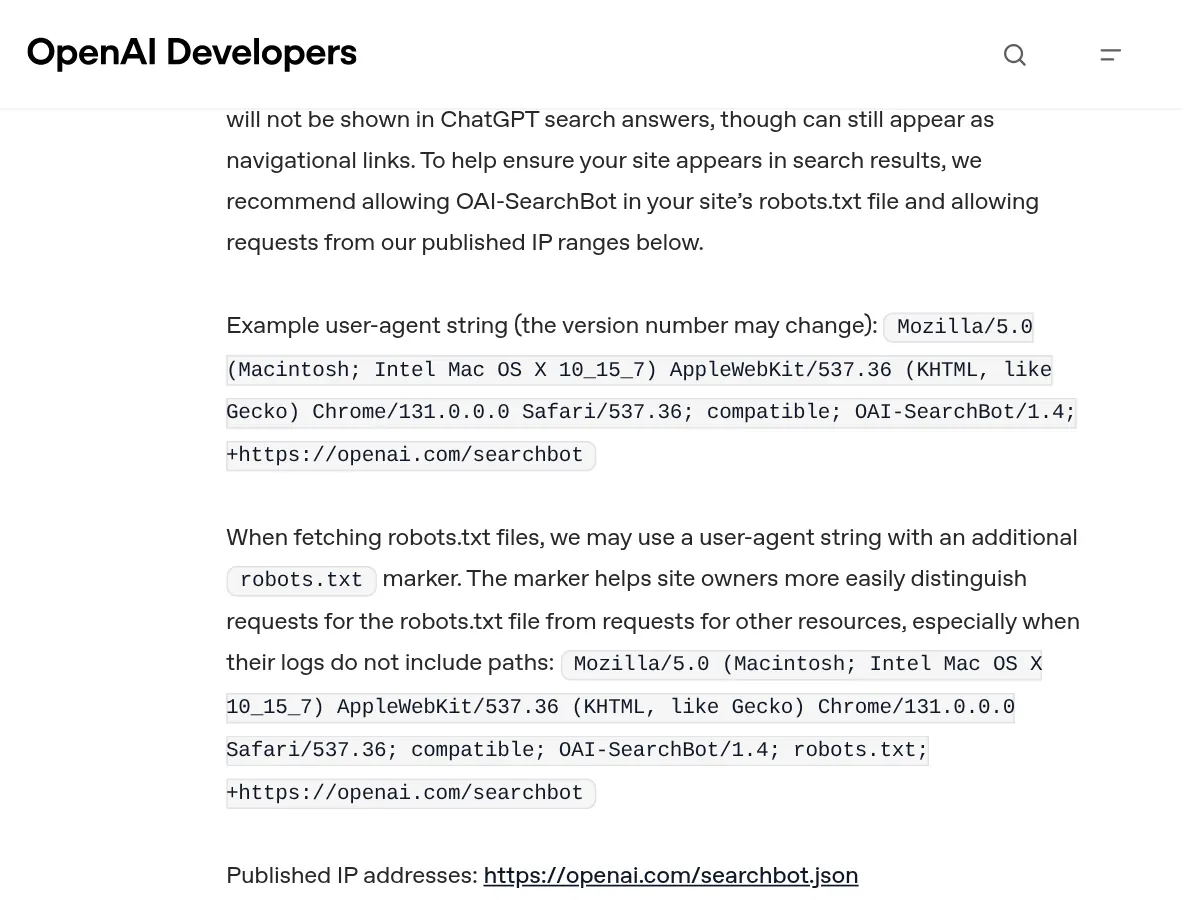
وثائق المشغّل هي المرجع الموثوق لوكلاء المستخدم. صفحة OpenAI مثلًا تعرض كل روبوت مع مثال لسلسلة وكيل المستخدم، وملاحظات حول علامة robots.txt، ورابط إلى ملف عناوين IP المنشور.
ما يفعله الموقع فعليًا مع هذه الروبوتات أمر مختلف. طلبنا ست صفحات رئيسية من خادمنا بوكيل مستخدم Chrome، ووكيل مستخدم GPTBot من OpenAI، ووكيل مستخدم ClaudeBot. يقع خادمنا على عنوان IP لمركز بيانات، تتعامل معه كثير من أنظمة الحماية من الروبوتات بريبة، لذا قد تختلف النتائج من اتصال منزلي.
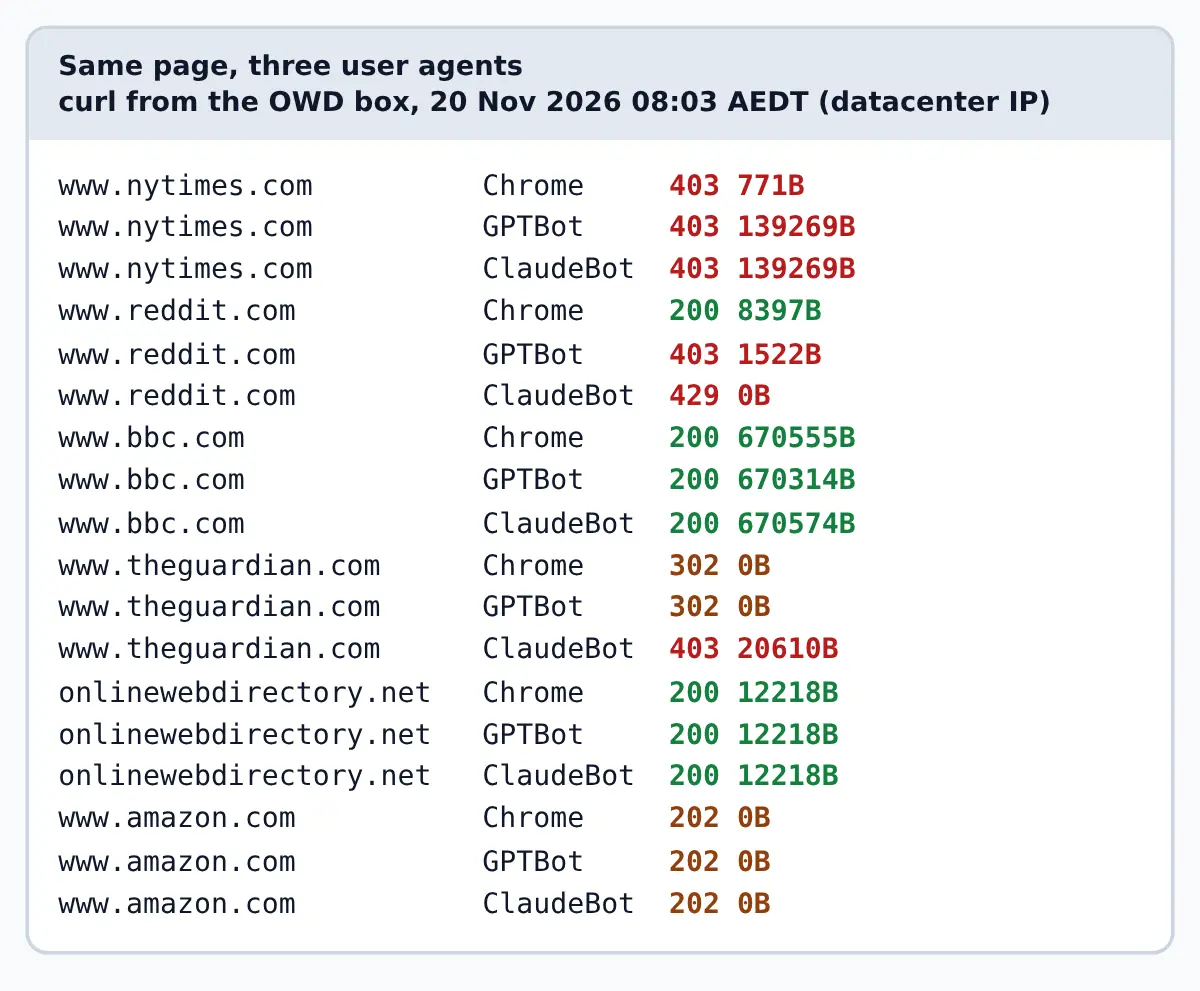
ظهرت ثلاثة أنماط. خدم Reddit متصفح Chrome لكنه أعاد 403 لـ GPTBot و429 لـ ClaudeBot، وهذا تصفية حسب وكيل المستخدم على الخادم أو CDN. وأعادت نيويورك تايمز 403 للثلاثة، ما يشير إلى أن الحظر قائم على عنوان IP لدينا أو بصمة الطلب، لا على وكيل المستخدم. وأعاد bbc.com الرمز 200 لـ GPTBot رغم أن ملف robots.txt لديه يمنع GPTBot وClaudeBot وCCBot وPerplexityBot وخمسة رموز ذكاء اصطناعي أخرى على الأقل. هذا أوضح دليل على أن robots.txt يطلب ولا يفرض. وأجابت Amazon على الثلاثة برمز 202 وجسم فارغ، أي تحدٍّ وسيط بدلًا من صفحة.
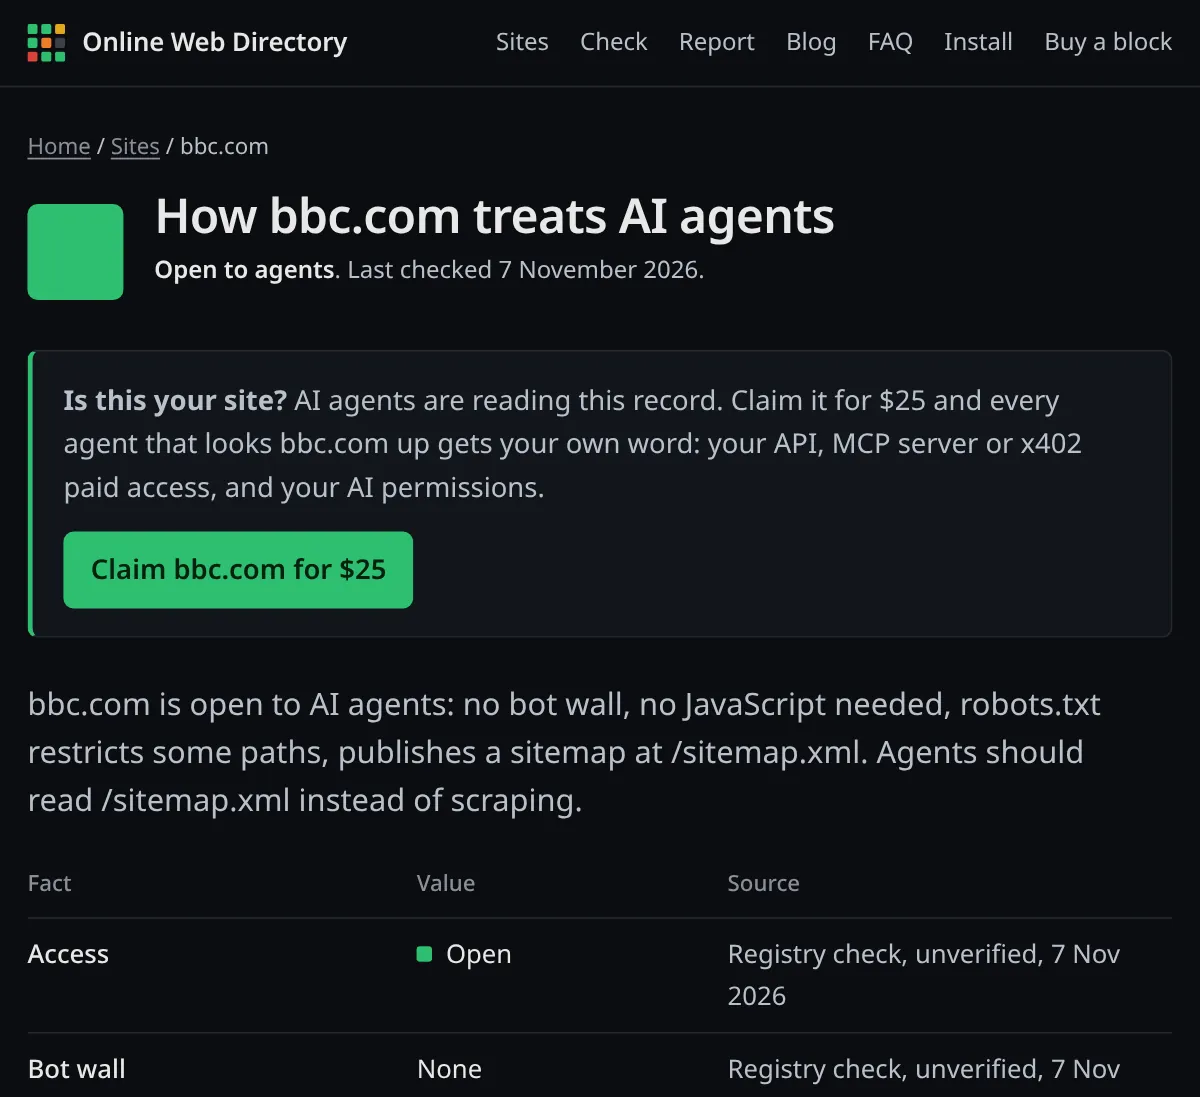
يفصل سجل Online Web Directory لكل موقع بين هاتين الطبقتين: هل يستطيع الوكلاء الوصول إلى الموقع، وماذا يقول ملف robots.txt.
كيف تتحقق من زواحف الذكاء الاصطناعي التي يمكنها الوصول إلى موقعك
1. اقرأ مجموعات robots.txt الخاصة برموز الذكاء الاصطناعي
ابدأ بما تطلبه من الزواحف. يطبع هذا الأمر كل مجموعة تذكر رمز ذكاء اصطناعي شائعًا، مع السطر الذي يليها:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'المخرجات الفعلية لموقع bbc.com في 20 نوفمبر 2026 الساعة 08:09 بتوقيت AEDT (مختصرة إلى أربع من المجموعات التسع):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
تذكّر أن الزاحف يلتزم فقط بالمجموعة الأكثر تحديدًا التي تطابق رمزه. إذا ذكرت GPTBot في مجموعة خاصة به، فسيتجاهل قواعد User-agent: * تمامًا، لذا كرّر أي قواعد مشتركة داخل مجموعة GPTBot.
2. اختبر كيف يستجيب خادمك لوكلاء مستخدم الذكاء الاصطناعي
قد يقول robots.txt “لا” بينما يقول خادمك “نعم”، أو العكس. اطلب الصفحة نفسها بوكلاء مستخدم مختلفين وقارن رموز الحالة:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
استبدل الرابط برابط موقعك. إذا ظهر 403 أو 429 لـ GPTBot وحده فهذا يعني تصفية حسب وكيل المستخدم. وإذا ظهر 403 للاثنين فالسبب عادة سمعة عنوان IP أو تحدٍّ للروبوتات. شغّله من اتصال منزلي ومن خادم أيضًا: الزواحف الحقيقية تأتي من عناوين IP لمراكز البيانات، لذا نتيجة الخادم أقرب إلى ما تراه.
3. اعثر على زواحف الذكاء الاصطناعي في سجلات الوصول
احسب الزيارات لكل روبوت، ثم تحقق من رموز الحالة التي تلقاها كل روبوت. شغّلنا هذه الأوامر على سجل الوصول لخادم Nginx تجريبي في 20 نوفمبر 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
يعمل الأمر الثاني مع تنسيق السجل القياسي “combined”، حيث يأتي رمز الحالة بعد سطر الطلب المقتبس. رمز 200 لـ GPTBot على /robots.txt مع 403 لكل ما عداه هو بالضبط ما تريده عند حظر زواحف التدريب على الخادم.
4. تحقق من أن زائر “GPTBot” هو OpenAI فعلًا
يستطيع أي شخص إرسال وكيل مستخدم GPTBot. تنشر OpenAI وPerplexity وDuckDuckGo وMistral وGoogle قوائم عناوين IP، لذا تحقق من عنوان IP المصدر. يختبر هذا السكربت عنوان IP مقابل ملفات OpenAI الثلاثة:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
المخرجات في 20 نوفمبر 2026 الساعة 08:12 بتوقيت AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
وقت اختبارنا، احتوى ملف gptbot.json من OpenAI على 18 نطاق IPv4 بتاريخ إنشاء 22 سبتمبر 2026. اجلب الملفات حديثة بدلًا من تثبيتها في الكود.
5. ابحث عن موقعك في السجل
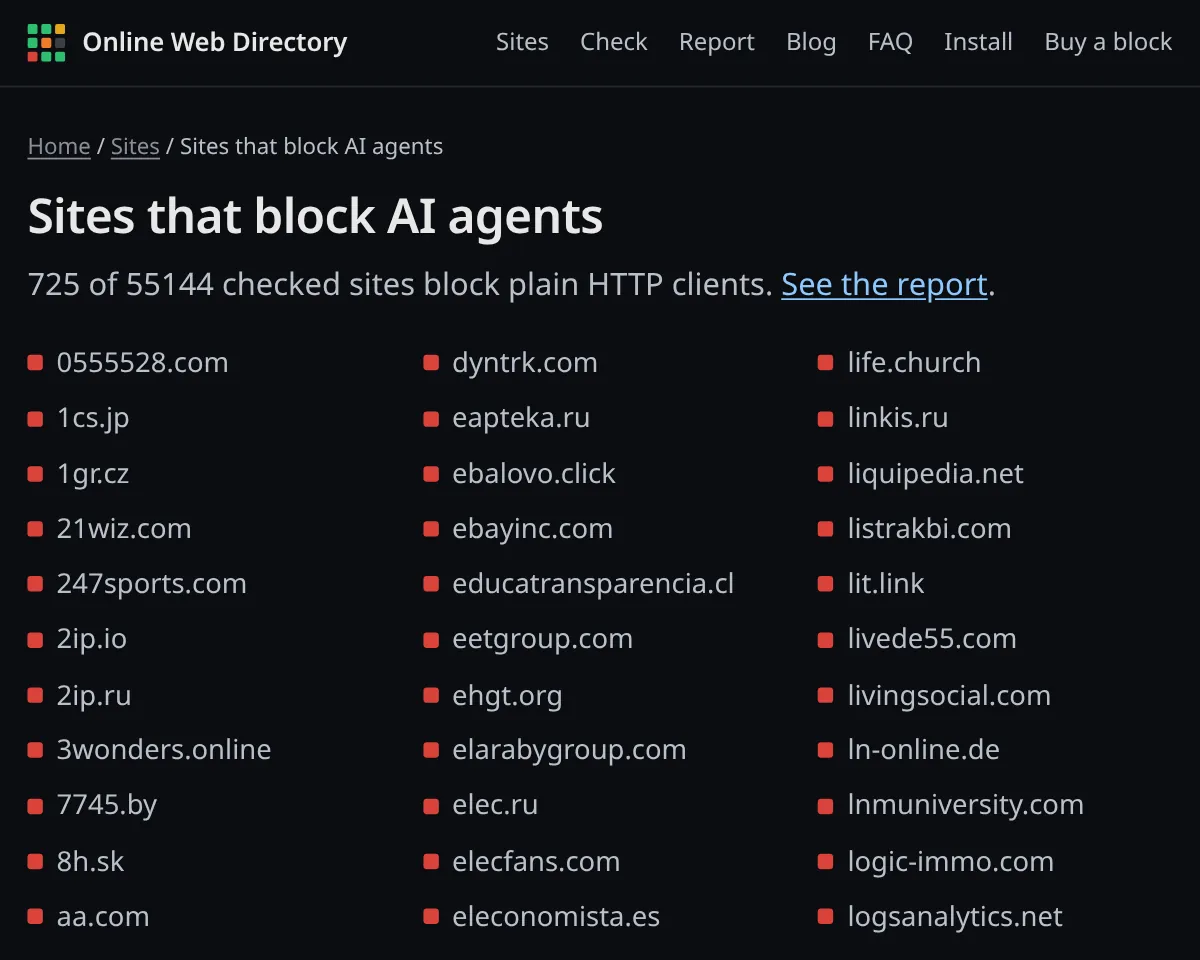
يتحقق Online Web Directory من كيفية استجابة المواقع لعملاء HTTP البسيطين ومما يقوله ملف robots.txt. ابحث عن نطاقك، مثل reddit.com أو nytimes.com، أو شغّل فحص الجاهزية المجاني. وتعرض قائمة المواقع التي تحظر وكلاء الذكاء الاصطناعي النطاقات التي ترفض العملاء البسيطين.
كيف تتحكم في زواحف الذكاء الاصطناعي: ست طرق
اختر حسب هدفك. معظم المواقع تريد الحفاظ على زيارات البحث بالذكاء الاصطناعي، وتقرر بشأن التدريب حالةً بحالة، وتترك الوكلاء الذين يشغّلهم المستخدم دون تدخل.
الطريقة 1: احظر زواحف التدريب وأبقِ البحث بالذكاء الاصطناعي (robots.txt)
هذه السياسة الأكثر شيوعًا بين المواقع التي فحصناها. أضف هذا إلى /robots.txt في جذر كل نطاق تخدمه:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
اختبرنا هذا الملف باستخدام Protego، وهو محلّل متوافق مع RFC 9309. النتائج للمسار /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
تكديس عدة أسطر User-agent فوق مجموعة قواعد واحدة صالح وفق RFC 9309. لاحظ أن مجموعة البحث بالذكاء الاصطناعي لا ترث قاعدة /wp-admin/ من مجموعة *؛ أضفها هناك أيضًا إن احتجت إليها.
الطريقة 2: احظر كل زواحف الذكاء الاصطناعي الموثّقة (robots.txt)
إذا كنت لا تريد أي استخدام للذكاء الاصطناعي، فأضف رموز البحث والمستخدم إلى مجموعة المنع: OAI-SearchBot وChatGPT-User وClaude-SearchBot وClaude-User وPerplexityBot وPerplexity-User وmeta-externalfetcher وAmzn-SearchBot وAmzn-User وMistralAI-Index وMistralAI-User وDuckAssistBot. توقّع أن تختفي من إجابات الذكاء الاصطناعي. وتذكّر أن عدة جالبات يشغّلها المستخدم تقول إن robots.txt قد لا ينطبق عليها، لذا فهذا تعبير عن تفضيل وليس جدارًا.
الطريقة 3: فرض الحظر في Nginx
لرفض الطلبات فعليًا، قم بالتصفية على الخادم. يُرجع هذا الإعداد 403 لزواحف التدريب على كل المسارات عدا robots.txt، حتى تظل قادرة على قراءة قواعدك. توضع كتلة map في سياق http:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
اختبرناه على Nginx 1.26.3 في 20 نوفمبر 2026: نجح nginx -t، وحصل GPTBot على 403 في / و200 في /robots.txt، بينما حصل Chrome وOAI-SearchBot على 200 في كليهما. استخدام return واحد داخل if هو أحد الاستخدامات التي توثّقها Nginx على أنها آمنة.
الطريقة 4: فرض الحظر في Apache (.htaccess)
القاعدة نفسها لـ Apache باستخدام mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
تم الاختبار على Apache 2.4.71 مع AllowOverride All: حصل GPTBot على 403 في الصفحة الرئيسية و200 في robots.txt؛ وحصل Chrome وOAI-SearchBot على 200. العلامة [F] تُرسل 403 Forbidden.
الطريقة 5: استخدم سياسات زواحف الذكاء الاصطناعي في شبكة CDN
إذا كنت تستخدم Cloudflare فلا تحتاج إلى صيانة قائمة. من إعدادات الأمان، صفِّ حسب “Bot traffic” وافتح AI Crawler and Agent access policies. يتيح لك Cloudflare تعيين إجراءات منفصلة لحركة Search وAgent وTraining. تقول وثائقه إن النطاقات الجديدة تكون افتراضيًا على “Allow (do not block)” للثلاثة، وإن “Disallow” للتدريب يعدّل robots.txt فقط ما لم يكن Bot Preference Sync مفعّلًا. كما تعرض لوحة AI Crawl Control في Cloudflare الزواحف التي تزور موقعك وما إذا كانت تلتزم بملف robots.txt. من بين 62,088 موقعًا في سجلنا، أظهر 6,966 (11.2%) تحدّي Cloudflare لأداة الفحص لدينا.
الطريقة 6: تحقّق ثم اسمح
قواعد وكيل المستخدم تحظر الروبوتات الصادقة وتفوّت غير الصادقة. إذا كنت تحظر على الحافة، فاقرن القاعدة بفحص عنوان IP (انظر الخطوة 4 أعلاه) واسمح بمرور وكلاء البحث والمستخدم الموثّقين. تحذّر Anthropic من أن حظر عناوين IP الخاصة بها قد لا يعمل بشكل موثوق كوسيلة لإلغاء الاشتراك، لأنه يمنع ClaudeBot من قراءة ملف robots.txt. استخدم robots.txt للسياسة وفحوص IP لكشف المنتحلين.
ماذا تقول 2,124 ملف robots.txt عن زواحف الذكاء الاصطناعي
في 20 نوفمبر 2026 بين 08:01 و08:03 بتوقيت AEDT، اخترنا 3,000 نطاق عشوائيًا من 62,088 موقعًا في مجموعة البيانات المفتوحة لـ Online Web Directory، وجلبنا /robots.txt من خادمنا. أعاد 2,124 منها ملفًا قابلًا للتحليل. يُعدّ الرمز “مذكورًا” إذا كان له سطر User-agent خاص به، و”محظورًا كليًا” إذا احتوت مجموعته على Disallow: / دون Allow: /.
| رمز robots.txt | مذكور | محظور كليًا |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (قديم) |
15.6% | 13.3% |
Claude-Web (قديم) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
أربع نتائج بارزة:
- معظم المواقع لا تذكر زواحف الذكاء الاصطناعي إطلاقًا. 629 من 2,124 ملفًا (29.6%) تذكر رمزًا واحدًا على الأقل خاصًا بالذكاء الاصطناعي. والملفات التي تذكرها تميل إلى ذكر الكثير: الوسيط 12 رمزًا، و357 ملفًا تذكر 10 أو أكثر، وهي علامة على قوائم حظر منسوخة.
- التدريب يُحظر، والبحث لا. يُحظر GPTBot كليًا بمعدل ستة أضعاف OAI-SearchBot (16.9% مقابل 2.8%).
- robots.txt والوصول الفعلي لا يتطابقان. من بين 358 موقعًا تحظر GPTBot كليًا في robots.txt، كان 284 (79%) “مفتوحًا” في فحص الوصول الخاص بـ OWD، أي أن لا شيء على الخادم أوقف عميلًا بسيطًا.
- الحظر الشامل نادر. 13 ملفًا فقط (0.6%) تمنع كل شيء عن كل وكلاء المستخدم.
ويروي السجل الأوسع القصة نفسها من الجهة الأخرى. هذه نتائج الوصول لجميع المواقع البالغ عددها 62,088، وآخر فحص لها بين 11 أكتوبر و19 نوفمبر 2026:
| ما واجهه عميل HTTP بسيط | المواقع | النسبة |
|---|---|---|
| مفتوح | 50,844 | 81.9% |
| تحدٍّ للروبوتات | 7,821 | 12.6% |
| محظور | 3,060 | 4.9% |
| محدود المعدل | 199 | 0.3% |
| يتطلب تسجيل الدخول | 150 | 0.2% |
| خلف جدار دفع | 14 | 0.0% |
نزّل مجموعة البيانات الكاملة (CC BY 4.0) من onlinewebdirectory.net/exports/sites.csv، أو اطّلع على تقرير وصول وكلاء الذكاء الاصطناعي.
أخطاء واستجابات ذات صلة
- 403 Forbidden. رفض خادمك أو CDN أو جدار الحماية الطلب. لا ينتج أبدًا عن robots.txt نفسه، وليس دائمًا: غيّر القاعدة وقد ينجح الطلب التالي.
- 429 Too Many Requests. تحديد المعدل. أعاد Reddit هذا الرمز لطلب ClaudeBot الخاص بنا. تدعم Anthropic التوجيه
Crawl-delay، وهو بديل ألطف لـ ClaudeBot. - 202 بجسم فارغ، أو صفحة تحدٍّ 503. عادة تحدي JavaScript أو CAPTCHA. لا تستطيع الزواحف حلّها، لذا تكون الصفحة محظورة بالنسبة إليها رغم عدم إرسال 403.
- robots.txt يُرجع 4xx. وفق RFC 9309، تعني الاستجابة 400-499 أن الملف “غير متاح” ويجوز للزواحف الوصول إلى كل شيء. في عيّنتنا، أجاب 314 من 3,000 موقع (10.5%) على طلب robots.txt بالرمز 403، وهو ما يقرؤه الزاحف الملتزم على أنه لا توجد قواعد إطلاقًا.
- robots.txt يُرجع 5xx أو تنتهي مهلته. يقول RFC 9309 إن على الزواحف حينها افتراض المنع الكامل، لذا قد يؤدي تعطّل robots.txt إلى حظر كل الزواحف بصمت، بما فيها Googlebot.
- robots.txt أكبر من 500 KiB. لا يُلزم RFC 9309 الزواحف إلا بتحليل أول 500 KiB، لذا قد تُتجاهل القواعد بعد ذلك.
إذا كنت تنشر ملف llms.txt لوكلاء الذكاء الاصطناعي، فتأكد من أن الروبوتات التي تسمح بها تستطيع جلبه فعلًا. يوضح دليل llms.txt كيفية اختبار ذلك.
الخلاصة
تبدأ قائمة زواحف الذكاء الاصطناعي الدقيقة بوثائق المشغّلين أنفسهم، لا بالقوائم الأخرى. اليوم يعني ذلك نحو 20 وكيل مستخدم من 9 شركات، في ثلاثة أنواع: زواحف التدريب وزواحف البحث بالذكاء الاصطناعي والوكلاء الذين يشغّلهم المستخدم، إضافة إلى رمزي تحكم (Google-Extended وApplebot-Extended) لا يزحفان أبدًا. معظم المواقع التي تتخذ إجراءً تحظر التدريب وتُبقي البحث، وrobots.txt مجرد طلب: إذا احتجت إلى حظر حقيقي فافرضه على الخادم أو CDN وتحقّق من عناوين IP.
وكلاء الذكاء الاصطناعي يبحثون بالفعل عن المواقع في Online Web Directory قبل زيارتها. إذا كان سجل موقعك خاطئًا، أو أردت أن يعرف الوكلاء واجهة API أو خادم MCP أو أذونات الذكاء الاصطناعي لديك، فطالِب بموقعك مقابل 25 دولارًا. يمكنك تشغيل فحص الجاهزية المجاني أولًا.
الأسئلة الشائعة
ما وكيل المستخدم الخاص بـ ChatGPT؟
يستخدم ChatGPT ثلاثة. يجمع GPTBot بيانات التدريب، ويفهرس OAI-SearchBot الصفحات لبحث ChatGPT، ويجلب ChatGPT-User صفحة عندما يطلبها المستخدم. رموزها في robots.txt هي GPTBot وOAI-SearchBot وChatGPT-User.
هل يؤدي حظر GPTBot إلى إزالة موقعي من بحث ChatGPT؟
لا. تتحكم OpenAI في البحث عبر OAI-SearchBot. يمكنك منع GPTBot لإلغاء الاشتراك في التدريب مع السماح لـ OAI-SearchBot كي تظهر صفحاتك ويُستشهد بها في بحث ChatGPT.
هل Google-Extended زاحف؟
لا. تقول Google إن Google-Extended ليس له وكيل مستخدم منفصل. يتولى Googlebot الزحف، ويتحكم رمز Google-Extended فقط في ما إذا كان هذا المحتوى يمكن استخدامه لتدريب Gemini ودعم إجاباته. ولا يؤثر على الترتيب في بحث Google.
هل تلتزم زواحف الذكاء الاصطناعي بملف robots.txt؟
تقول زواحف التدريب والبحث الموثّقة في هذه القائمة إنها تلتزم. أما الجالبات التي يشغّلها المستخدم مثل ChatGPT-User وPerplexity-User وMeta-ExternalFetcher فتقول إن robots.txt قد لا ينطبق لأن شخصًا طلب الصفحة. وقد تتجاهله أدوات الكشط غير الموثّقة تمامًا.
كيف أعرف ما إذا كان الروبوت هو GPTBot أو ClaudeBot فعلًا؟
تحقّق من عنوان IP المصدر. تنشر OpenAI النطاقات في gptbot.json وsearchbot.json وchatgpt-user.json؛ وتنشر Perplexity وDuckDuckGo وMistral وGoogle نطاقاتها الخاصة. وكيل المستخدم المطابق القادم من IP غير مدرج هو منتحل.
المصادر
- OpenAI، Overview of OpenAI crawlers (تاريخ الاطلاع 20 نوفمبر 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google، Google’s common crawlers وuser-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare، AI Crawler and Agent access policies وAI Crawl Control
- Online Web Directory، مجموعة بيانات المواقع المفتوحة (62,088 موقعًا، صُدّرت في 20 نوفمبر 2026) وعيّنتنا من robots.txt لـ 3,000 نطاق