

De flesta ”listor över AI-crawlers” du hittar är kopierade från varandra, och många är inaktuella. De anger fortfarande Claude-Web som Anthropics crawler, hittar på en bot som heter ”Googlebot-Extended” eller påstår att Google-Extended crawlar dina sidor. Det gör den inte. Google-Extended har ingen egen user agent; det är bara en robots.txt-token.
Den här listan skiljer sig på två sätt. Varje user agent nedan är kontrollerad mot operatörens egen dokumentation, per den 20 november 2026. Och vi har mätt hur riktiga webbplatser behandlar botarna: vi hämtade robots.txt från 3 000 slumpvis valda webbplatser i Online Web Directorys register och räknade vilka AI-crawlers de nämner och blockerar. Du får också testade regler för robots.txt, Nginx och Apache, plus ett skript som kontrollerar om en ”GPTBot”-besökare verkligen kommer från OpenAI.
Vad är en lista över AI-crawlers? En lista över AI-crawlers är en referens över de botar som AI-företag använder för att hämta webbsidor, med varje bots robots.txt-token, dess user agent-sträng och dess uppgift: samla träningsdata, indexera sidor för AI-sök eller hämta en sida direkt för att en användare bad om den. Du använder den för att skriva robots.txt-regler, läsa serverloggar och ställa in brandväggsregler.
AI-crawlers i korthet
| Fråga | Kort svar |
|---|---|
| Hur många AI-crawlers spelar roll? | Ungefär 20 dokumenterade user agents från 9 operatörer (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), plus DuckDuckGo och en lång svans av mindre botar. |
| Huvudtyper | Träningscrawlers, AI-sökcrawlers och användarstartade agenter eller hämtare. Google-Extended och Applebot-Extended är kontrolltokens, inte crawlers. |
| Följer de robots.txt? | De dokumenterade tränings- och sökcrawlerna säger ja. Användarstartade hämtare (ChatGPT-User, Perplexity-User, Googles användarstartade hämtare, Meta-ExternalFetcher) säger att robots.txt kanske inte gäller. |
| Kan robots.txt ge ett 403-fel? | Nej. robots.txt är en begäran, inte ett lås. Ett 403 kommer från din server, ditt CDN eller din brandvägg. |
| Hur ofta blockerar webbplatser dem? | I vårt urval från 20 nov. 2026 blockerar 16,9 % av robots.txt-filerna GPTBot helt, men bara 2,8 % blockerar OAI-SearchBot helt. |
| Hur verifierar man en bot? | Jämför förfrågans IP med operatörens publicerade IP-lista (till exempel https://openai.com/gptbot.json). En user agent är lätt att förfalska. |
Listan över AI-crawlers (kontrollerad i november 2026)
Tabellen visar varje robots.txt-token, vem som driver den, vad den gör enligt operatören och om operatören säger att den följer robots.txt. Kolumnen ”Typ” har tre grupper: träning (samlar innehåll som kan träna modeller), sök (indexerar sidor så att en AI-produkt kan citera dem senare) och användare (hämtar en sida i realtid för att en person bad om den). Botar vars operatör inte publicerar någon dokumentation som går att kontrollera har vi utelämnat.
| robots.txt-token | Operatör | Typ | Vad den gör | Följer robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Träning | Crawlar innehåll som kan användas för att träna OpenAI:s grundmodeller. | Ja |
OAI-SearchBot |
OpenAI | Sök | Indexerar sidor så att de kan visas i ChatGPT:s sökresultat. | Ja |
ChatGPT-User |
OpenAI | Användare | Besöker en sida när en användare av ChatGPT eller en Custom GPT ställer en fråga. | ”Gäller kanske inte” |
OAI-AdsBot |
OpenAI | Annonskontroll | Kontrollerar landningssidor som skickats in som ChatGPT-annonser; används inte för träning. | Besöker bara inskickade sidor |
ClaudeBot |
Anthropic | Träning | Samlar webbinnehåll som kan bidra till träningen av Claude-modeller. | Ja, och respekterar Crawl-delay |
Claude-SearchBot |
Anthropic | Sök | Indexerar innehåll för att förbättra Claudes sökresultat. | Ja |
Claude-User |
Anthropic | Användare | Hämtar sidor när en Claude-användare ställer en fråga. | Ja, enligt Anthropic |
Google-Extended |
Kontrolltoken | Styr om innehåll som Google crawlar får träna Gemini eller grunda dess svar. Ingen separat crawler. | Endast token | |
Google-CloudVertexBot |
På ägarens begäran | Crawlar webbplatser vars ägare bygger Vertex AI Agents; ingen effekt på Google Sök. | Ja | |
Google-Agent |
Användare | Agenter som Google driver och som surfar och utför åtgärder på en användares begäran. | Användarstartad: i regel nej | |
PerplexityBot |
Perplexity | Sök | Indexerar sidor för Perplexitys sökresultat; används inte för träning. | Ja |
Perplexity-User |
Perplexity | Användare | Hämtar en sida under en användares Perplexity-session. | ”Ignorerar den i regel” |
Applebot-Extended |
Apple | Kontrolltoken | Styr om sidor som Applebot crawlar får träna Apples grundmodeller. Crawlar ingenting själv. | Endast token |
meta-externalagent |
Meta | Träning | Crawlar för användning som träning av AI-modeller eller indexering av innehåll. | Ja |
meta-externalfetcher |
Meta | Användare | Hämtar specifika länkar på en användares begäran, även för agentuppgifter. | ”Kan kringgå den” |
Amazonbot |
Amazon | Träning | Förbättrar Amazons produkter och tjänster; kan användas för att träna Amazons AI-modeller. | Ja |
Amzn-SearchBot |
Amazon | Sök | Indexerar sidor för sökupplevelser som Alexa; används inte för träning. | Ja |
Amzn-User |
Amazon | Användare | Hämtar aktuell information för att svara en användare, till exempel en Alexa-förfrågan. | ”Följer kanske inte allt” |
CCBot |
Common Crawl | Träningsdata | Bygger Common Crawls öppna webbarkiv, en vanlig källa till träningsdata för AI. | Ja |
MistralAI-Training |
Mistral AI | Träning | Crawlar innehåll för att bygga träningsdataset för Mistral-modeller. | Ja |
MistralAI-Index |
Mistral AI | Sök | Indexerar innehåll för Mistrals sök; används inte för träning. | Ja |
MistralAI-User |
Mistral AI | Användare | Besöker en sida när en användare ställer en fråga till Vibe, Mistrals assistent. | Ja, för användarförfrågningar |
DuckAssistBot |
DuckDuckGo | Sök | Crawlar sidor i realtid för DuckDuckGos AI-assisterade svar. | Ja (gäller efter 72 timmar) |
Källorna för varje rad länkas i slutet av artikeln. Citaten i sista kolumnen kommer direkt från operatörens dokumentation. Bytespider (ByteDance) saknas med avsikt: vi hittade ingen sida från ByteDance som dokumenterar den, även om 18,5 % av robots.txt-filerna i vårt urval nämner den. Av samma skäl beskriver vi inte den långa svansen av tokens som cohere-ai, Diffbot eller omgili; hur ofta de förekommer finns i dataavsnittet.
De fullständiga user agent-strängarna du ser i loggarna
robots.txt fungerar med den korta token, men dina åtkomstloggar visar hela strängen. Det här är exemplen som operatörerna publicerar. Versionsnummer ändras, så filtrera på token och inte på hela strängen.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
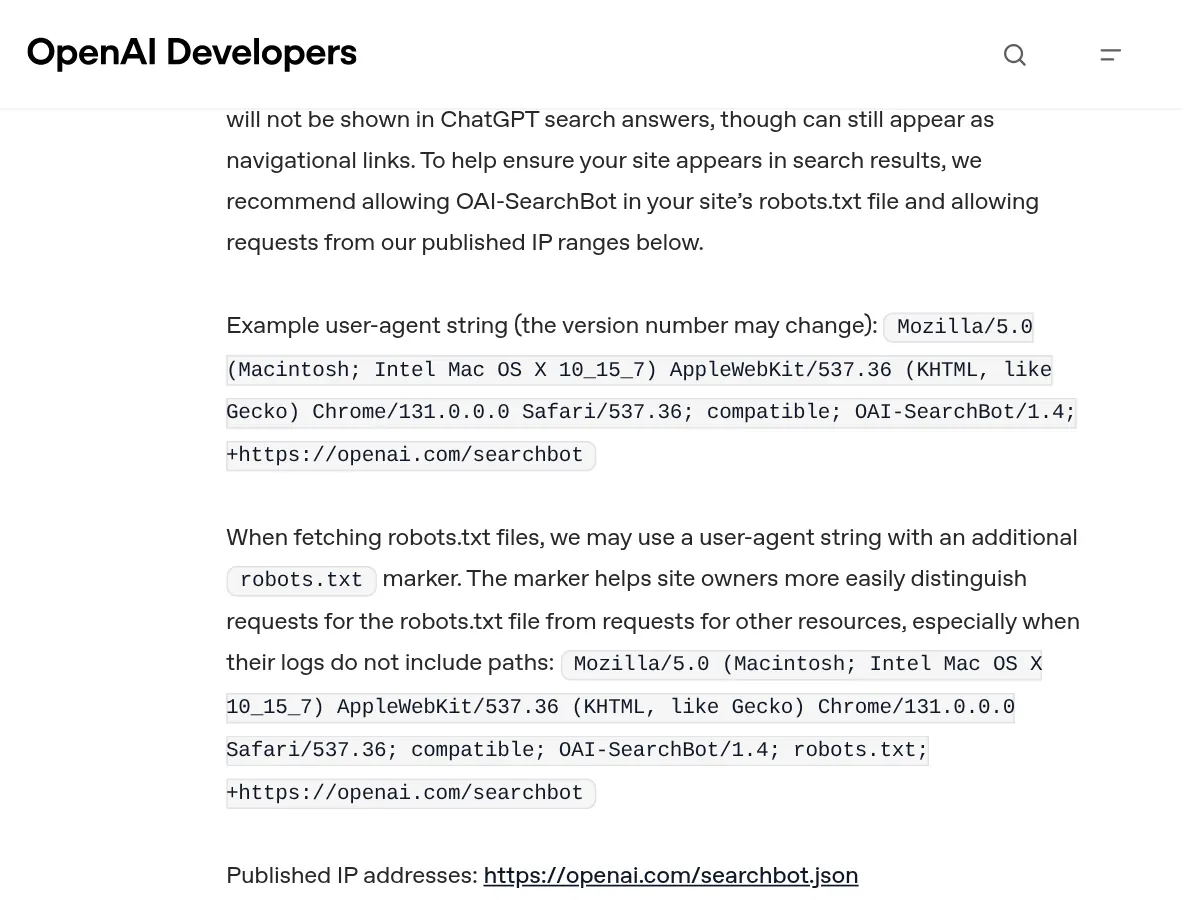
OpenAI anger också att GPTBot och OAI-SearchBot kan lägga till en robots.txt-markör i user agent när de hämtar din robots.txt, så att du kan skilja ut de förfrågningarna i loggar som saknar sökvägar.
Tre typer av AI-crawlers, och varför skillnaden spelar roll
Att blockera ”AI-botar” som en enda grupp är det vanligaste misstaget vi ser. De tre typerna har olika kostnader och nytta, och operatörerna hanterar robots.txt olika för varje typ.
Träningscrawlers
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot och MistralAI-Training samlar sidor som kan hamna i träningsdata. Att blockera dem tar inte bort dig från samma företags AI-sökresultat: OpenAI säger att varje robots.txt-inställning är oberoende, så du kan blockera GPTBot och tillåta OAI-SearchBot. I vårt urval är träningscrawlers den mest blockerade gruppen. 17,3 % av robots.txt-filerna blockerar CCBot helt, 16,9 % GPTBot och 15,9 % ClaudeBot.
AI-sökcrawlers
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index och DuckAssistBot indexerar sidor så att en assistent kan hitta och citera dem senare. Att blockera dem kan hålla dig utanför de svaren. Webbplatsägare verkar veta det: bara 2,8 % av filerna blockerar OAI-SearchBot helt och 5,8 % PerplexityBot, mot 16,9 % för GPTBot.
Användarstartade hämtare och agenter
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User och Google-Agent agerar för en person i taget, precis som en webbläsare. Flera operatörer säger att robots.txt kanske inte gäller, eftersom en människa bad om sidan. Det är också dessa botar som shopping- och bokningsagenter använder, så att blockera dem kan stöta bort riktiga kunder. 5,9 % av filerna i vårt urval blockerar ChatGPT-User helt.
Kontrolltokens som inte crawlar något
Google-Extended och Applebot-Extended besöker aldrig din webbplats. Google och Apple crawlar som vanligt med Googlebot och Applebot och kontrollerar sedan dessa tokens för att avgöra om innehållet får träna deras modeller. Google säger att blockering av Google-Extended inte påverkar indexering eller ranking i Google Sök. 14,1 % av de analyserade filerna blockerar Google-Extended helt och 13,5 % Applebot-Extended. Google har också sagt att man planerar att stödja den gemensamma signalen för AI-träning (user-agent: __usage_ai-training) i början av 2027; det tar vi upp i vår guide om opt-out från AI-träning i robots.txt.
Gamla tokens som fortfarande fyller robots.txt-filer
Anthropics nuvarande hjälpsida nämner bara ClaudeBot, Claude-User och Claude-SearchBot. Ändå nämner 15,6 % av de analyserade filerna fortfarande anthropic-ai och 13,8 % Claude-Web. Regler för de namnen skadar inte, men om det är dina enda regler för Anthropic täcker de kanske inte de botar som Anthropic dokumenterar i dag. Kontrollera att ClaudeBot nämns uttryckligen.
Hur åtkomst för AI-crawlers ser ut i praktiken
För user agents gäller operatörernas dokumentation. OpenAI:s sida listar till exempel varje bot med ett exempel på user agent-sträng, anteckningar om robots.txt-markören och en länk till den publicerade IP-filen.
Vad en webbplats faktiskt gör med botarna är en annan sak. Vi begärde sex startsidor från vår server med en Chrome-user agent, OpenAI:s GPTBot-user agent och en ClaudeBot-user agent. Vår server använder en datacenter-IP, som många botskydd behandlar med misstanke; från en hemanslutning kan resultaten bli annorlunda.
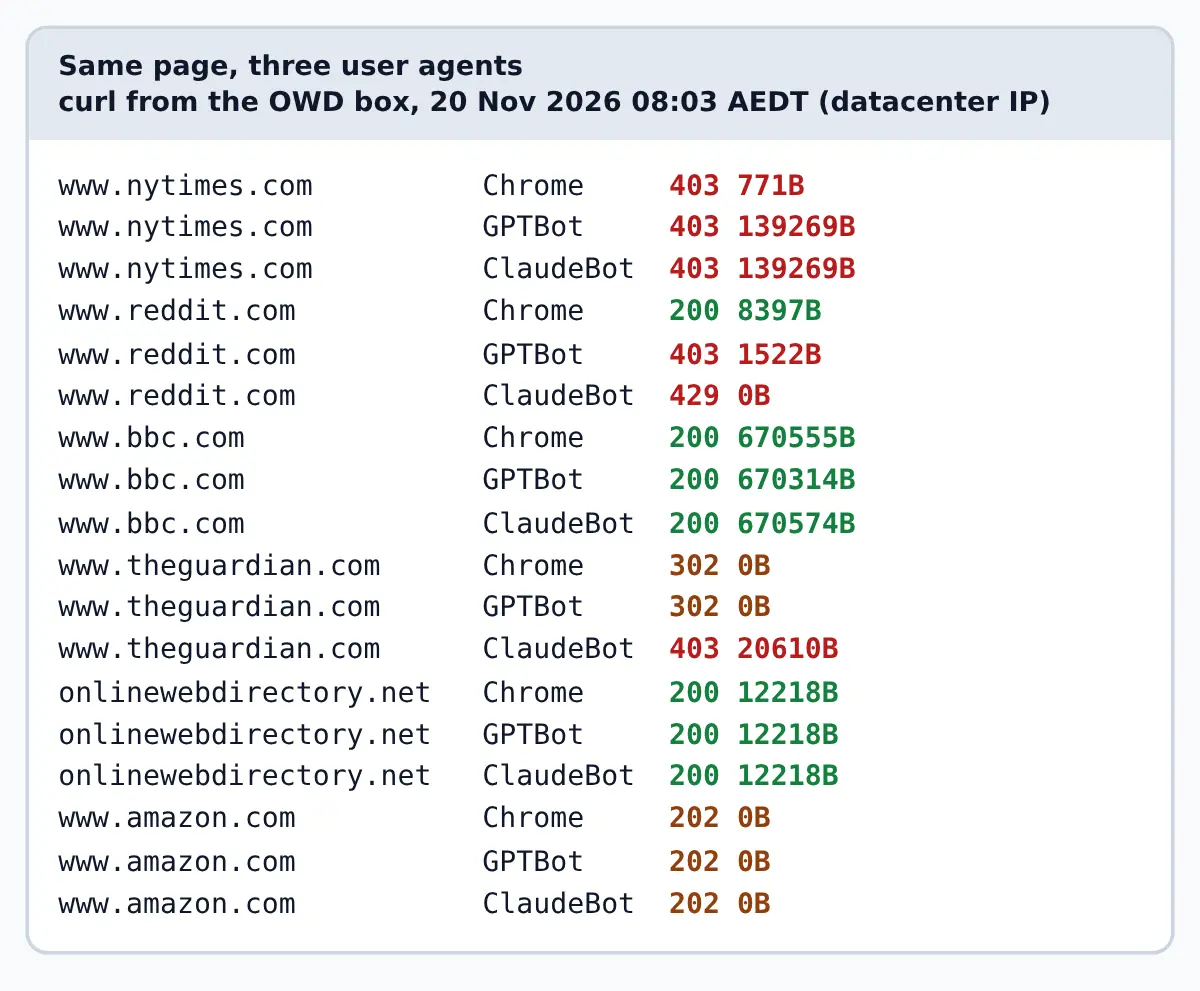
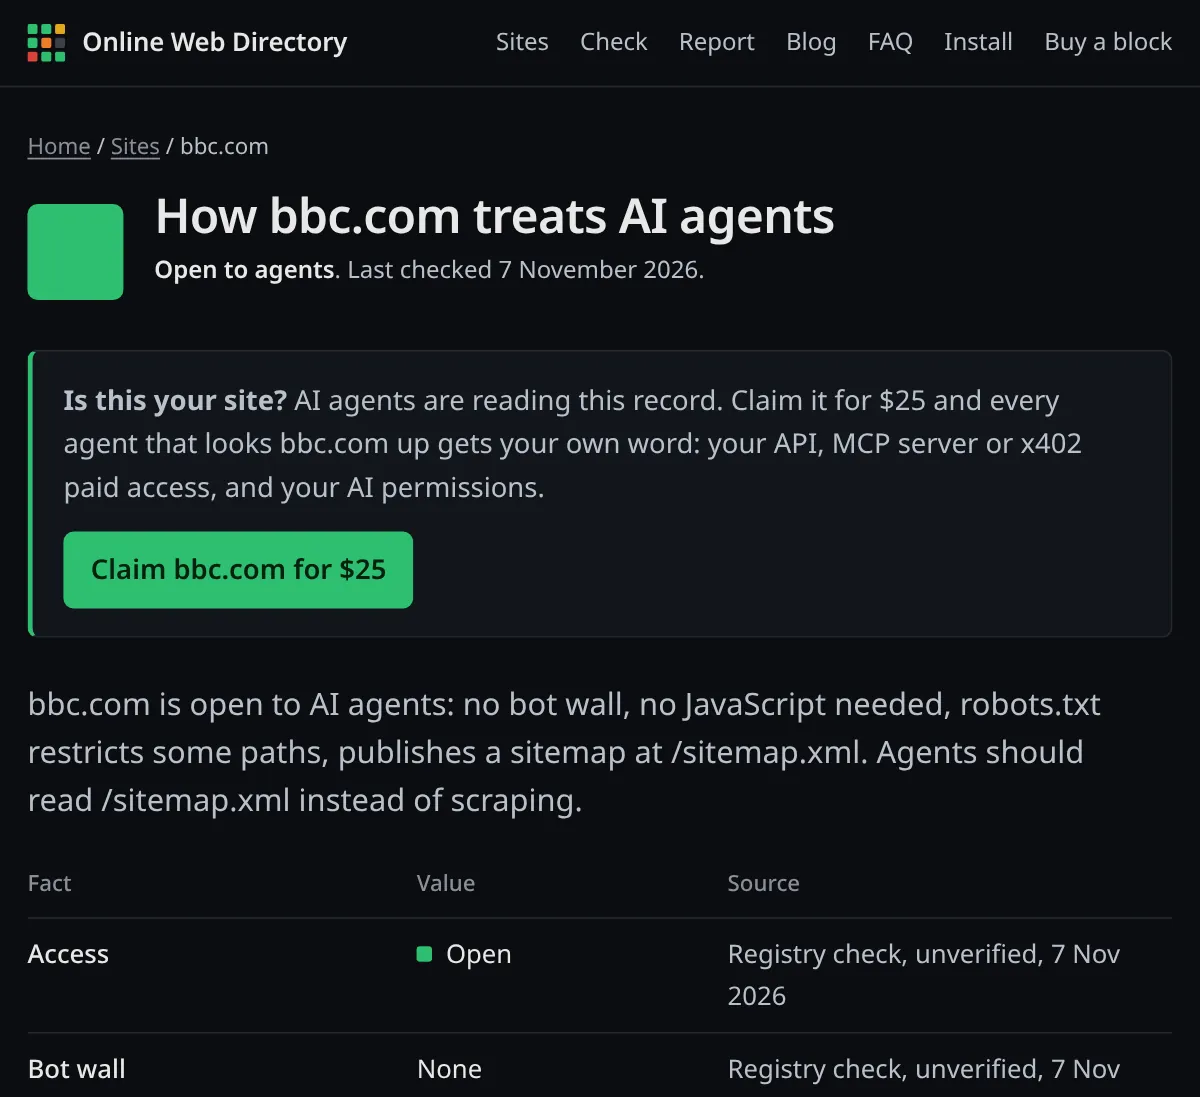
Tre mönster syns. Reddit levererade till Chrome men gav GPTBot 403 och ClaudeBot 429: filtrering på user agent i servern eller CDN:et. The New York Times gav alla tre 403, vilket tyder på blockering baserad på vår IP eller förfrågans fingeravtryck, inte på user agent. Och bbc.com gav GPTBot 200 trots att dess robots.txt blockerar GPTBot, ClaudeBot, CCBot, PerplexityBot och minst fem andra AI-tokens. Det är det tydligaste beviset på att robots.txt ber men inte tvingar. Amazon svarade alla tre med ett 202 med tom kropp, en mellanliggande kontrollsida i stället för en riktig sida.
Varje webbplats profil i Online Web Directory skiljer på de två lagren: om agenter kan nå webbplatsen och vad dess robots.txt säger.
Så kontrollerar du vilka AI-crawlers som kan nå din webbplats
1. Läs grupperna i din robots.txt för AI-tokens
Börja med vad du ber crawlers om. Det här kommandot visar varje grupp som nämner en vanlig AI-token, med raden efter:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Riktig utdata för bbc.com den 20 november 2026 kl. 08:09 AEDT (förkortad till fyra av nio grupper):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Kom ihåg att en crawler bara följer den mest specifika grupp som matchar dess token. Om du nämner GPTBot i en egen grupp ignorerar den dina User-agent: *-regler helt, så upprepa gemensamma regler i GPTBot-gruppen.
2. Testa hur din server svarar AI-user agents
robots.txt kan säga ”nej” medan servern fortfarande säger ”ja”, eller tvärtom. Begär samma sida med olika user agents och jämför statuskoderna:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Byt ut URL:en mot din egen. Ett 403 eller 429 bara för GPTBot tyder på filtrering på user agent. Ett 403 för båda tyder oftast på IP-rykte eller en botkontroll. Testa både från en hemanslutning och från en server: riktiga crawlers kommer från datacenter-IP:er, så serverresultatet ligger närmare det de ser.
3. Hitta AI-crawlers i dina åtkomstloggar
Räkna förfrågningar per bot och kontrollera vilka statuskoder varje bot fick. Vi körde de här kommandona mot åtkomstloggen på en Nginx-testserver den 20 november 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
Det andra kommandot fungerar med standardloggformatet ”combined”, där statuskoden står efter den citerade förfrågningsraden. Ett 200 för GPTBot på /robots.txt och 403 överallt annars är precis vad du vill se när du blockerar träningscrawlers på servern.
4. Kontrollera att en ”GPTBot”-besökare verkligen kommer från OpenAI
Vem som helst kan skicka en GPTBot-user agent. OpenAI, Perplexity, DuckDuckGo, Mistral och Google publicerar IP-listor, så kontrollera käll-IP:n. Det här skriptet testar en IP mot OpenAI:s tre filer:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Utdata den 20 november 2026 kl. 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
När vi testade innehöll OpenAI:s fil gptbot.json 18 IPv4-intervall, med skapandedatum 22 september 2026. Hämta filerna varje gång i stället för att hårdkoda dem.
5. Slå upp din webbplats i registret
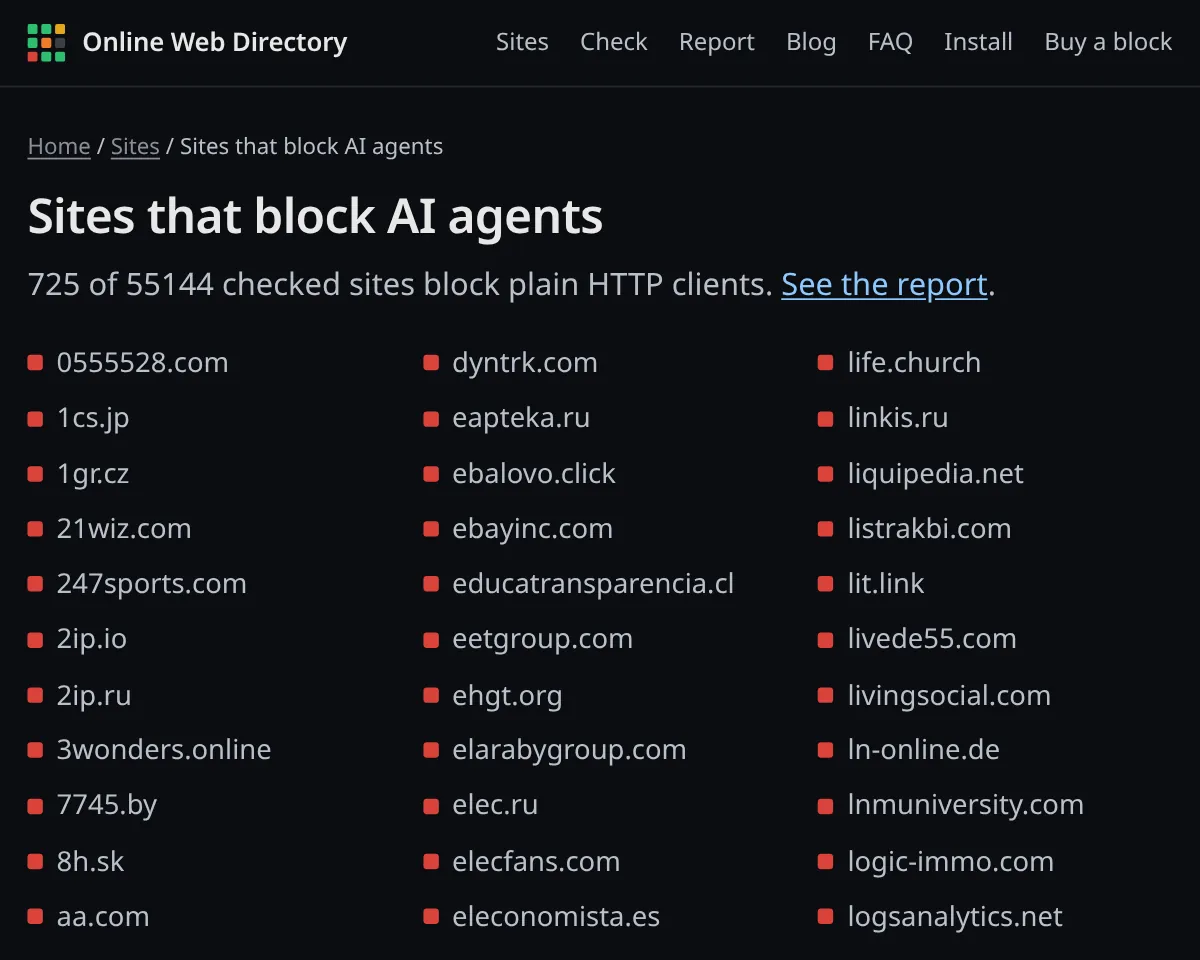
Online Web Directory kontrollerar hur webbplatser svarar enkla HTTP-klienter och vad deras robots.txt säger. Slå upp din domän, till exempel reddit.com eller nytimes.com, eller kör den kostnadsfria beredskapskontrollen. Listan över webbplatser som blockerar AI-agenter visar vilka domäner som nekar enkla klienter.
Styra AI-crawlers: sex metoder
Välj utifrån ditt mål. De flesta webbplatser vill behålla trafiken från AI-sök, ta ställning till träning från fall till fall och låta användarstartade agenter vara.
Metod 1: blockera träningscrawlers, behåll AI-sök (robots.txt)
Det här är den vanligaste policyn bland webbplatserna i vårt urval. Lägg till detta i /robots.txt i roten på varje värd du betjänar:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Vi testade filen med Protego, en parser som följer RFC 9309. Resultat för sökvägen /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Att stapla flera User-agent-rader ovanför ett regelblock är giltigt enligt RFC 9309. Observera att AI-sökgruppen inte ärver regeln /wp-admin/ från gruppen *; lägg till den där också om du behöver den.
Metod 2: blockera alla dokumenterade AI-crawlers (robots.txt)
Om du inte vill ha någon AI-användning alls lägger du till sök- och användartokens i den blockerade gruppen: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User och DuckAssistBot. Räkna med att försvinna från AI-svar. Och kom ihåg att flera användarstartade hämtare säger att robots.txt kanske inte gäller dem: det är en uttalad önskan, ingen mur.
Metod 3: tvinga fram blockeringen i Nginx
För att verkligen neka förfrågningar filtrerar du på servern. Den här konfigurationen ger träningscrawlers 403 på alla sökvägar utom robots.txt, så att de fortfarande kan läsa dina regler. Blocket map hör hemma i http-kontexten:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Testad med Nginx 1.26.3 den 20 november 2026: nginx -t gick igenom, GPTBot fick 403 på / och 200 på /robots.txt, medan Chrome och OAI-SearchBot fick 200 på båda. En enkel return inuti en if hör till de användningar som Nginx dokumenterar som säkra.
Metod 4: tvinga fram blockeringen i Apache (.htaccess)
Samma regel för Apache med mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Testad på Apache 2.4.71 med AllowOverride All: GPTBot fick 403 på startsidan och 200 på robots.txt; Chrome och OAI-SearchBot fick 200. Flaggan [F] returnerar 403 Forbidden.
Metod 5: använd ditt CDN:s regler för AI-crawlers
På Cloudflare behöver du inte underhålla någon lista. Gå till Security, Settings, filtrera på ”Bot traffic” och öppna AI Crawler and Agent access policies. Cloudflare låter dig ställa in separata åtgärder för trafik av typen Search, Agent och Training. Enligt dokumentationen är nya domäner som standard inställda på ”Allow (do not block)” för alla tre, och ”Disallow” för Training ändrar bara robots.txt tills du aktiverar Bot Preference Sync. Cloudflares instrumentpanel AI Crawl Control visar också vilka crawlers som kommer in och om de följer din robots.txt. Av de 62 088 webbplatserna i vårt register visade 6 966 (11,2 %) en Cloudflare-kontroll för vår kontrollant.
Metod 6: verifiera, sedan tillåt
Regler på user agent blockerar ärliga botar och släpper igenom oärliga. Om du blockerar vid kanten, kombinera regeln med IP-verifiering (se steg 4) och släpp igenom verifierade sök- och användaragenter. Anthropic varnar för att blockering av dess IP-adresser kanske inte fungerar tillförlitligt som opt-out, eftersom ClaudeBot då inte kan läsa din robots.txt. Använd robots.txt för policyn och IP-kontroller för att fånga imitatörer.
Vad 2 124 robots.txt-filer säger om AI-crawlers
Den 20 november 2026 mellan 08:01 och 08:03 AEDT drog vi slumpvis 3 000 värdar bland de 62 088 webbplatserna i Online Web Directorys öppna dataset och hämtade /robots.txt från vår server. 2 124 gav en tolkningsbar fil. En token är ”nämnd” om den har en egen User-agent-rad, och ”helt blockerad” om den gruppen innehåller Disallow: / utan Allow: /.
| robots.txt-token | Nämnd | Helt blockerad |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (äldre) |
15.6% | 13.3% |
Claude-Web (äldre) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Fyra saker sticker ut:
- De flesta webbplatser nämner inte AI-crawlers alls. 629 av 2 124 filer (29,6 %) nämner minst en AI-specifik token. De som gör det nämner ofta många: medianen är 12 tokens, och 357 filer nämner 10 eller fler, ett tecken på kopierade blocklistor.
- Träning blockeras, sök gör det inte. GPTBot blockeras helt sex gånger oftare än OAI-SearchBot (16,9 % mot 2,8 %).
- robots.txt och verklig åtkomst stämmer inte överens. Av de 358 webbplatser som blockerar GPTBot helt i robots.txt var 284 (79 %) ”öppna” i OWD:s åtkomstkontroll: ingenting på servern stoppade en enkel klient.
- Totalförbud är sällsynta. Bara 13 filer (0,6 %) förbjuder allt för alla user agents.
Hela registret berättar samma historia från andra hållet. Här är åtkomstresultaten för alla 62 088 webbplatser, senast kontrollerade mellan 11 oktober och 19 november 2026:
| Vad en enkel HTTP-klient mötte | Webbplatser | Andel |
|---|---|---|
| Öppen | 50,844 | 81.9% |
| Botkontroll | 7,821 | 12.6% |
| Blockerad | 3,060 | 4.9% |
| Hastighetsbegränsad | 199 | 0.3% |
| Inloggning krävs | 150 | 0.2% |
| Betalvägg | 14 | 0.0% |
Ladda ner hela datasetet (CC BY 4.0) på onlinewebdirectory.net/exports/sites.csv eller se rapporten om AI-agenters åtkomst.
Relaterade fel och svar
- 403 Forbidden. Din server, ditt CDN eller din brandvägg nekade förfrågan. Det orsakas aldrig av robots.txt i sig, och det är inte permanent: ändra regeln så kan nästa förfrågan lyckas.
- 429 Too Many Requests. Hastighetsbegränsning. Reddit gav detta på vår ClaudeBot-förfrågan. Anthropic stöder
Crawl-delay, ett mjukare alternativ för ClaudeBot. - 202 med tom kropp, eller en 503-kontrollsida. Oftast en JavaScript- eller CAPTCHA-kontroll. Crawlers kan inte lösa den, så för dem är sidan blockerad även utan 403.
- robots.txt ger 4xx. Enligt RFC 9309 betyder ett svar mellan 400 och 499 att filen är ”otillgänglig” och att crawlers får crawla allt. I vårt urval svarade 314 av 3 000 webbplatser (10,5 %) med 403 på vår robots.txt-förfrågan, vilket en regelföljande crawler tolkar som inga regler.
- robots.txt ger 5xx eller tidsgräns. RFC 9309 säger att crawlers då ska anta fullt förbud, så ett robots.txt-avbrott kan i tysthet blockera alla crawlers, även Googlebot.
- robots.txt större än 500 KiB. RFC 9309 kräver bara att crawlers tolkar de första 500 KiB, så regler efter det kan ignoreras.
Om du publicerar en llms.txt-fil för AI-agenter, se till att tillåtna botar verkligen kan hämta den. Vår guide till llms.txt förklarar hur du testar det.
Sammanfattning
En pålitlig lista över AI-crawlers börjar med operatörernas dokumentation, inte med andra listor. I dag handlar det om ungefär 20 user agents från 9 företag, i tre typer: träningscrawlers, AI-sökcrawlers och användarstartade agenter, plus två kontrolltokens (Google-Extended och Applebot-Extended) som aldrig crawlar. De flesta webbplatser som agerar blockerar träning och behåller sök, och robots.txt är bara en begäran: behöver du en verklig blockering, tvinga fram den i servern eller CDN:et och verifiera IP:er.
AI-agenter slår redan upp webbplatser i Online Web Directory innan de besöker dem. Om din webbplats profil är fel, eller om du vill att agenter ska känna till ditt API, din MCP-server eller dina AI-behörigheter, gör anspråk på din webbplats för 25 $. Du kan köra den kostnadsfria beredskapskontrollen först.
Vanliga frågor
Vilken user agent har ChatGPT?
ChatGPT använder tre. GPTBot samlar träningsdata, OAI-SearchBot indexerar sidor för ChatGPT-sök och ChatGPT-User hämtar en sida när en användare ber om den. Deras robots.txt-tokens är GPTBot, OAI-SearchBot och ChatGPT-User.
Tar blockering av GPTBot bort min webbplats från ChatGPT-sök?
Nej. OpenAI sköter sök via OAI-SearchBot. Du kan blockera GPTBot för att säga nej till träning och tillåta OAI-SearchBot så att dina sidor visas och citeras i ChatGPT-sök.
Är Google-Extended en crawler?
Nej. Google säger att Google-Extended inte har någon egen user agent. Det är Googlebot som crawlar, och token Google-Extended styr bara om innehållet får träna och grunda Gemini. Den påverkar inte rankingen i Google Sök.
Följer AI-crawlers robots.txt?
De dokumenterade tränings- och sökcrawlerna i listan säger ja. Användarstartade hämtare som ChatGPT-User, Perplexity-User och Meta-ExternalFetcher säger att robots.txt kanske inte gäller, eftersom en person bad om sidan. Odokumenterade skrapare kan ignorera den helt.
Hur vet jag om en bot verkligen är GPTBot eller ClaudeBot?
Kontrollera käll-IP:n. OpenAI publicerar sina intervall i gptbot.json, searchbot.json och chatgpt-user.json; Perplexity, DuckDuckGo, Mistral och Google publicerar sina. En matchande user agent från en IP som inte finns i listan är en imitatör.
Källor
- OpenAI, Overview of OpenAI crawlers (hämtad 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers och user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies och AI Crawl Control
- Online Web Directory, öppet webbplatsdataset (62 088 webbplatser, exporterat 20 nov. 2026) och vårt robots.txt-urval på 3 000 värdar