

La maggior parte degli «elenchi di crawler IA» che troverete sono copiati l’uno dall’altro, e molti sono superati. Indicano ancora Claude-Web come crawler di Anthropic, inventano un bot «Googlebot-Extended» o sostengono che Google-Extended scansiona le vostre pagine. Non è così. Google-Extended non ha uno user agent proprio: è solo un token di robots.txt.
Questo elenco è diverso per due motivi. Ogni user agent qui sotto è verificato sulla documentazione dell’operatore, aggiornata al 20 novembre 2026. E abbiamo misurato come i siti reali trattano questi bot: abbiamo scaricato il robots.txt di 3.000 siti scelti a caso nel registro di Online Web Directory e contato quali crawler IA nominano e bloccano. Troverete anche regole testate per robots.txt, Nginx e Apache, più uno script che verifica se un visitatore «GPTBot» arriva davvero da OpenAI.
Che cos’è un elenco di crawler IA? Un elenco di crawler IA è un riferimento dei bot che le aziende di IA usano per scaricare pagine web, con il token robots.txt di ogni bot, la sua stringa user agent e il suo compito: raccogliere dati di addestramento, indicizzare pagine per la ricerca IA o recuperare una pagina in tempo reale perché un utente l’ha chiesta. Serve per scrivere regole robots.txt, leggere i log del server e impostare le regole del firewall.
I crawler IA in sintesi
| Domanda | Risposta breve |
|---|---|
| Quanti crawler IA contano? | Circa 20 user agent documentati di 9 operatori (OpenAI, Anthropic, Google, Perplexity, Apple, Meta, Amazon, Common Crawl, Mistral), più DuckDuckGo e una lunga coda di bot minori. |
| Tipi principali | Crawler di addestramento, crawler di ricerca IA e agenti o fetcher avviati dall’utente. Google-Extended e Applebot-Extended sono token di controllo, non crawler. |
| Rispettano robots.txt? | I crawler di addestramento e di ricerca documentati dicono di sì. I fetcher avviati dall’utente (ChatGPT-User, Perplexity-User, i fetcher di Google avviati dall’utente, Meta-ExternalFetcher) dicono che robots.txt potrebbe non applicarsi. |
| robots.txt può restituire un errore 403? | No. robots.txt è una richiesta, non una serratura. Un 403 arriva dal vostro server, CDN o firewall. |
| Quanto spesso i siti li bloccano? | Nel nostro campione del 20 nov. 2026, il 16,9% dei file robots.txt blocca del tutto GPTBot, ma solo il 2,8% blocca del tutto OAI-SearchBot. |
| Come si verifica un bot? | Confrontate l’IP della richiesta con l’elenco di IP pubblicato dall’operatore (per esempio https://openai.com/gptbot.json). Uno user agent si falsifica con facilità. |
L’elenco dei crawler IA (verificato a novembre 2026)
La tabella mostra ogni token robots.txt, chi lo gestisce, cosa fa secondo l’operatore e se l’operatore dichiara di rispettare robots.txt. La colonna «Tipo» usa tre categorie: addestramento (raccoglie contenuti che possono addestrare modelli), ricerca (indicizza pagine perché un prodotto IA possa citarle in seguito) e utente (recupera una pagina in tempo reale perché una persona l’ha chiesta). Abbiamo escluso i bot il cui operatore non pubblica documentazione verificabile.
| Token robots.txt | Operatore | Tipo | Cosa fa | Rispetta robots.txt? |
|---|---|---|---|---|
GPTBot |
OpenAI | Addestramento | Scansiona contenuti che possono servire ad addestrare i modelli di base di OpenAI. | Sì |
OAI-SearchBot |
OpenAI | Ricerca | Indicizza pagine perché possano comparire nei risultati di ricerca di ChatGPT. | Sì |
ChatGPT-User |
OpenAI | Utente | Visita una pagina quando un utente di ChatGPT o di un Custom GPT fa una domanda. | «Potrebbe non applicarsi» |
OAI-AdsBot |
OpenAI | Controllo annunci | Controlla le landing page inviate come annunci ChatGPT; non usato per l’addestramento. | Visita solo le pagine inviate |
ClaudeBot |
Anthropic | Addestramento | Raccoglie contenuti web che possono contribuire all’addestramento dei modelli Claude. | Sì, e rispetta Crawl-delay |
Claude-SearchBot |
Anthropic | Ricerca | Indicizza contenuti per migliorare i risultati di ricerca di Claude. | Sì |
Claude-User |
Anthropic | Utente | Recupera pagine quando un utente di Claude fa una domanda. | Sì, secondo Anthropic |
Google-Extended |
Token di controllo | Decide se i contenuti scansionati da Google possono addestrare Gemini o fondarne le risposte. Non è un crawler separato. | Solo token | |
Google-CloudVertexBot |
Richiesto dal proprietario | Scansiona i siti i cui proprietari creano Vertex AI Agents; nessun effetto sulla ricerca Google. | Sì | |
Google-Agent |
Utente | Agenti ospitati da Google che navigano e agiscono su richiesta di un utente. | Avviato dall’utente: in genere no | |
PerplexityBot |
Perplexity | Ricerca | Indicizza pagine per i risultati di ricerca di Perplexity; non usato per l’addestramento. | Sì |
Perplexity-User |
Perplexity | Utente | Recupera una pagina durante la sessione Perplexity di un utente. | «In genere lo ignora» |
Applebot-Extended |
Apple | Token di controllo | Decide se le pagine scansionate da Applebot possono addestrare i modelli di base di Apple. Non scansiona nulla. | Solo token |
meta-externalagent |
Meta | Addestramento | Scansiona per usi come l’addestramento di modelli IA o l’indicizzazione dei contenuti. | Sì |
meta-externalfetcher |
Meta | Utente | Recupera link specifici su richiesta di un utente, anche per attività da agente. | «Potrebbe aggirarlo» |
Amazonbot |
Amazon | Addestramento | Migliora prodotti e servizi Amazon; può servire ad addestrare i modelli IA di Amazon. | Sì |
Amzn-SearchBot |
Amazon | Ricerca | Indicizza pagine per esperienze di ricerca come Alexa; non usato per l’addestramento. | Sì |
Amzn-User |
Amazon | Utente | Recupera informazioni in tempo reale per rispondere a un utente, per esempio una richiesta ad Alexa. | «Potrebbe non seguire tutto» |
CCBot |
Common Crawl | Dati di addestramento | Costruisce l’archivio web aperto di Common Crawl, fonte frequente di dati di addestramento per l’IA. | Sì |
MistralAI-Training |
Mistral AI | Addestramento | Scansiona contenuti per creare dataset di addestramento per i modelli Mistral. | Sì |
MistralAI-Index |
Mistral AI | Ricerca | Indicizza contenuti per la ricerca di Mistral; non usato per l’addestramento. | Sì |
MistralAI-User |
Mistral AI | Utente | Visita una pagina quando un utente fa una domanda a Vibe, l’assistente di Mistral. | Sì, per le richieste degli utenti |
DuckAssistBot |
DuckDuckGo | Ricerca | Scansiona pagine in tempo reale per le risposte assistite dall’IA di DuckDuckGo. | Sì (effettivo dopo 72 ore) |
Le fonti di ogni riga sono linkate alla fine dell’articolo. Le citazioni nell’ultima colonna vengono direttamente dalla documentazione dell’operatore. Bytespider (ByteDance) manca di proposito: non abbiamo trovato alcuna pagina di ByteDance che lo documenti, anche se il 18,5% dei file robots.txt del nostro campione lo nomina. Per lo stesso motivo non descriviamo la lunga coda di token come cohere-ai, Diffbot o omgili; la loro frequenza è nella sezione dati.
Le stringhe user agent complete che vedrete nei log
robots.txt funziona con il token breve, ma i log di accesso mostrano la stringa completa. Questi sono gli esempi pubblicati dagli operatori. I numeri di versione cambiano: filtrate sul token, non sulla stringa intera.
# GPTBot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot

# OAI-SearchBot
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot

# ChatGPT-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot

# PerplexityBot
Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)

# Perplexity-User
Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user)

# Amazonbot
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1) Chrome/W.X.Y.Z Safari/537.36

# CCBot
CCBot/2.0 (https://commoncrawl.org/faq/)

# meta-externalagent
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)

# MistralAI-User
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; MistralAI-User/1.0; +https://docs.mistral.ai/robots)

# DuckAssistBot
DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html)
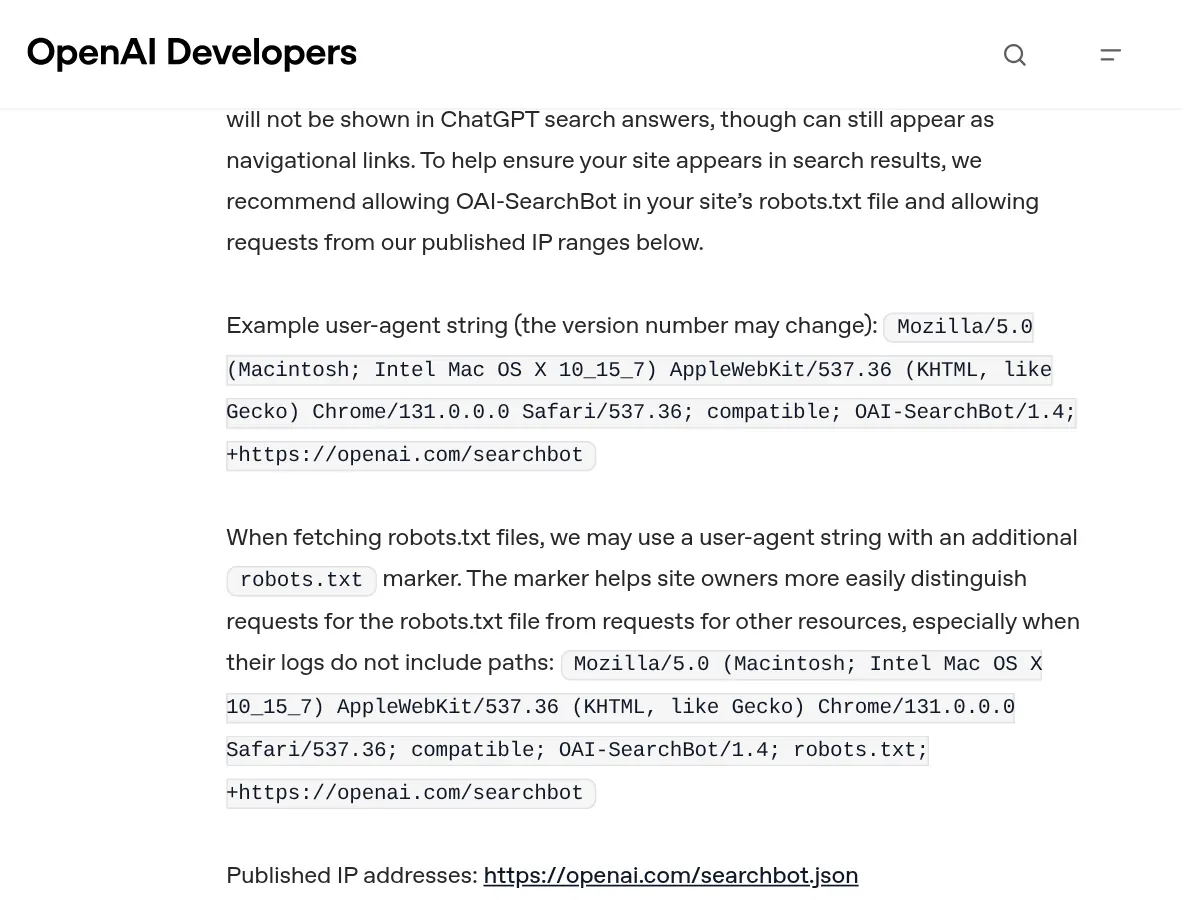
OpenAI precisa anche che GPTBot e OAI-SearchBot possono aggiungere un indicatore robots.txt allo user agent quando recuperano il vostro robots.txt, così potete distinguere quelle richieste in log senza percorsi.
Tre tipi di crawler IA, e perché la differenza conta
Bloccare i «bot IA» come un unico gruppo è l’errore più comune che vediamo. I tre tipi hanno costi e benefici diversi, e gli operatori trattano robots.txt in modo diverso per ciascuno.
Crawler di addestramento
GPTBot, ClaudeBot, CCBot, meta-externalagent, Amazonbot e MistralAI-Training raccolgono pagine che possono finire nei dati di addestramento. Bloccarli non vi toglie dai risultati di ricerca IA della stessa azienda: OpenAI dice che ogni sua impostazione robots.txt è indipendente, quindi potete bloccare GPTBot e consentire OAI-SearchBot. Nel nostro campione, i crawler di addestramento sono il gruppo più bloccato. Il 17,3% dei file robots.txt blocca del tutto CCBot, il 16,9% GPTBot e il 15,9% ClaudeBot.
Crawler di ricerca IA
OAI-SearchBot, Claude-SearchBot, PerplexityBot, Amzn-SearchBot, MistralAI-Index e DuckAssistBot indicizzano pagine perché un assistente possa trovarle e citarle in seguito. Bloccarli può escludervi da quelle risposte. I proprietari dei siti sembrano saperlo: solo il 2,8% dei file blocca del tutto OAI-SearchBot e il 5,8% PerplexityBot, contro il 16,9% di GPTBot.
Fetcher e agenti avviati dall’utente
ChatGPT-User, Claude-User, Perplexity-User, meta-externalfetcher, Amzn-User, MistralAI-User e Google-Agent agiscono per una persona alla volta, come un browser. Diversi operatori dicono che robots.txt potrebbe non applicarsi, perché la pagina l’ha chiesta un essere umano. Sono anche i bot usati dagli agenti di acquisto e prenotazione: bloccarli può allontanare clienti reali. Il 5,9% dei file del nostro campione blocca del tutto ChatGPT-User.
Token di controllo che non scansionano nulla
Google-Extended e Applebot-Extended non visitano mai il vostro sito. Google e Apple scansionano come sempre con Googlebot e Applebot, poi controllano questi token per decidere se i contenuti possono addestrare i loro modelli. Google afferma che bloccare Google-Extended non ha alcun effetto sull’inclusione o sul posizionamento nella ricerca Google. Il 14,1% dei file analizzati blocca del tutto Google-Extended e il 13,5% Applebot-Extended. Google ha anche annunciato che intende supportare il segnale comune per l’addestramento IA (user-agent: __usage_ai-training) all’inizio del 2027; ne parliamo nella nostra guida all’opt-out dall’addestramento IA in robots.txt.
Vecchi token che affollano ancora i robots.txt
L’attuale pagina di aiuto di Anthropic cita solo ClaudeBot, Claude-User e Claude-SearchBot. Eppure il 15,6% dei file analizzati nomina ancora anthropic-ai e il 13,8% Claude-Web. Le regole per quei nomi non fanno danni, ma se sono le vostre uniche regole per Anthropic potrebbero non coprire i bot che Anthropic documenta oggi. Verificate che ClaudeBot sia nominato esplicitamente.
Come appare in pratica l’accesso dei crawler IA
Per gli user agent fa fede la documentazione degli operatori. La pagina di OpenAI, per esempio, elenca ogni bot con una stringa user agent di esempio, note sull’indicatore robots.txt e un link al suo file di IP pubblicato.
Cosa fa davvero un sito con questi bot è un’altra storia. Abbiamo richiesto sei home page dal nostro server con uno user agent Chrome, lo user agent GPTBot di OpenAI e uno user agent ClaudeBot. Il nostro server usa un IP di data center, che molte protezioni anti-bot guardano con sospetto; da una connessione domestica i risultati possono essere diversi.
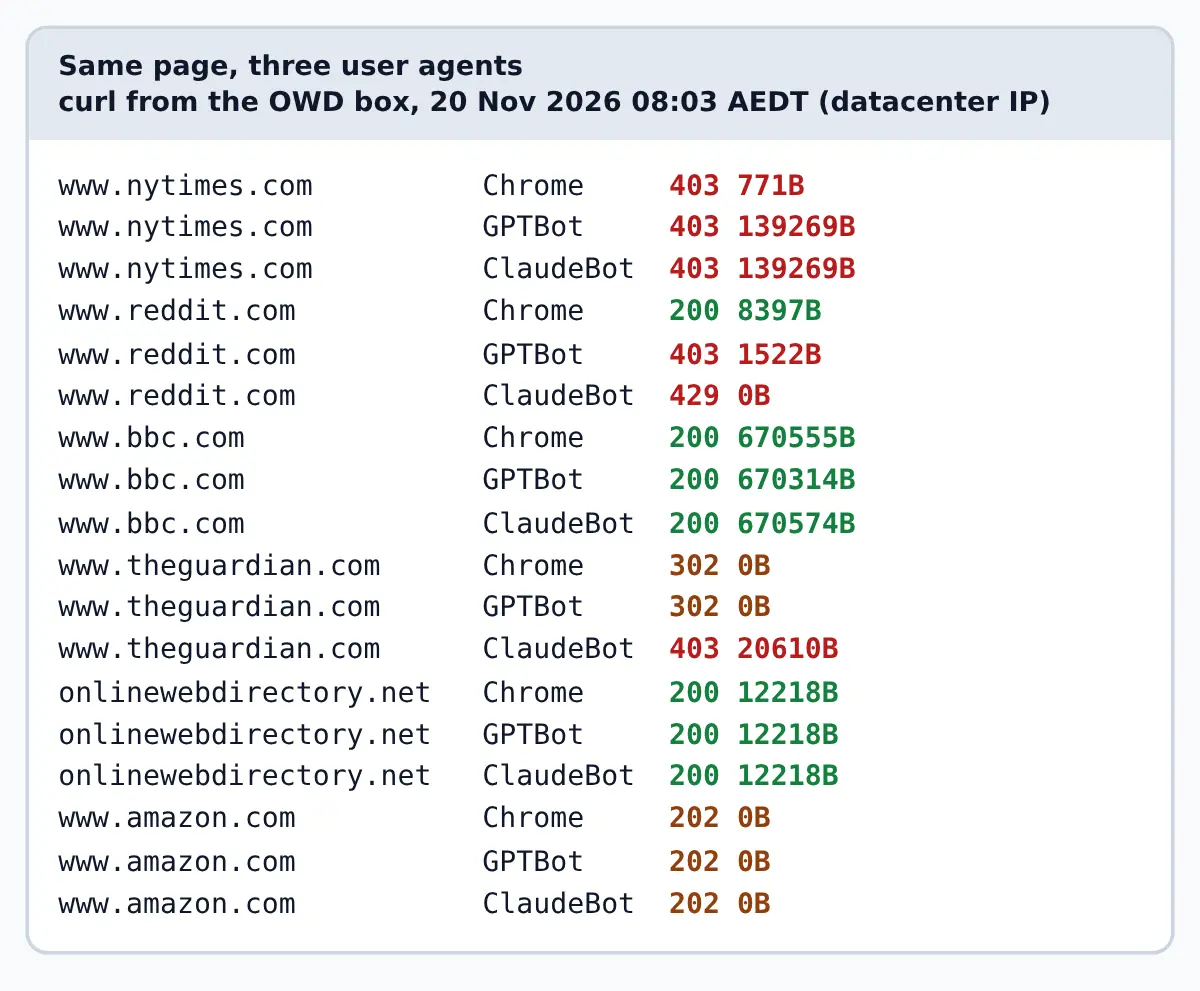
Emergono tre schemi. Reddit ha servito Chrome ma ha restituito 403 a GPTBot e 429 a ClaudeBot: filtraggio per user agent sul server o sulla CDN. Il New York Times ha restituito 403 a tutti e tre, segno di un blocco basato sul nostro IP o sull’impronta della richiesta, non sullo user agent. E bbc.com ha restituito 200 a GPTBot anche se il suo robots.txt blocca GPTBot, ClaudeBot, CCBot, PerplexityBot e almeno altri cinque token IA. È la prova più chiara che robots.txt chiede senza imporre. Amazon ha risposto a tutti e tre con un 202 a corpo vuoto, una pagina di verifica intermedia anziché una pagina reale.
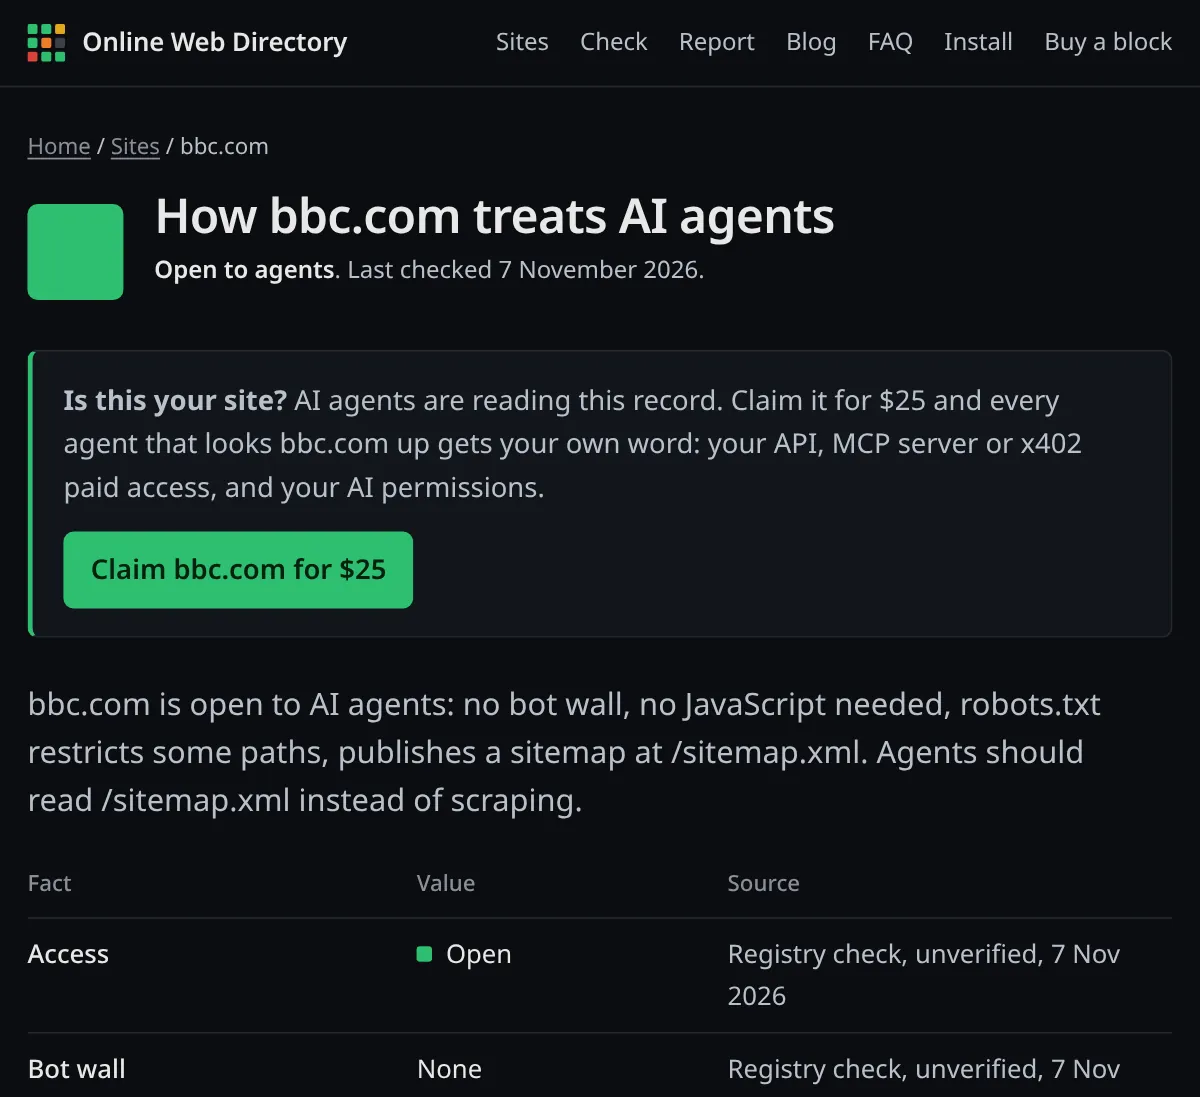
La scheda di ogni sito in Online Web Directory separa questi due livelli: se gli agenti possono raggiungere il sito e cosa dice il suo robots.txt.
Come verificare quali crawler IA possono raggiungere il vostro sito
1. Leggete i gruppi del vostro robots.txt per i token IA
Partite da ciò che chiedete ai crawler. Questo comando mostra ogni gruppo che nomina un token IA comune, con la riga successiva:
curl -s https://www.bbc.com/robots.txt | grep -i -A1 -E '^user-agent: *(gptbot|oai-searchbot|chatgpt-user|claudebot|google-extended|perplexitybot|ccbot|bytespider|applebot-extended)'Output reale per bbc.com il 20 novembre 2026 alle 08:09 AEDT (ridotto a quattro dei nove gruppi):
User-agent: CCBot
Disallow: /
--
User-agent: ClaudeBot
Disallow: /
--
User-agent: GPTBot
Disallow: /
--
User-agent: OAI-SearchBot
Disallow: /
Ricordate che un crawler obbedisce solo al gruppo più specifico che corrisponde al suo token. Se nominate GPTBot in un gruppo proprio, ignora del tutto le regole User-agent: *; ripetete quindi le regole condivise nel gruppo di GPTBot.
2. Testate la risposta del server agli user agent IA
robots.txt può dire «no» mentre il server dice ancora «sì», o viceversa. Richiedete la stessa pagina con user agent diversi e confrontate i codici di stato:
GPT='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
CHROME='Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0.0.0 Safari/537.36'
for ua in "$CHROME" "$GPT"; do
  curl -s -o /dev/null -A "$ua" -w "%{http_code} %{size_download}B\n" https://www.example-shop.com/
done
Sostituite l’URL con il vostro. Un 403 o un 429 solo per GPTBot indica un filtraggio per user agent. Un 403 per entrambi indica di solito la reputazione dell’IP o una verifica anti-bot. Testate sia da una connessione domestica sia da un server: i crawler reali arrivano da IP di data center, quindi il risultato dal server è più vicino a ciò che vedono.
3. Individuate i crawler IA nei log di accesso
Contate le richieste per bot, poi controllate quali codici di stato ha ricevuto ciascuno. Abbiamo eseguito questi comandi sul log di accesso di un server Nginx di prova il 20 novembre 2026:
$ grep -o -E 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|CCBot|Bytespider|Amazonbot|meta-external[a-z]+' access.log | sort | uniq -c | sort -rn
      2 OAI-SearchBot
      2 GPTBot
$ awk -F'"' '/GPTBot/ {split($3,a," "); print a[1]}' access.log | sort | uniq -c
      1 200
      1 403
Il secondo comando funziona con il formato di log standard «combined», dove il codice di stato segue la riga di richiesta tra virgolette. Un 200 per GPTBot su /robots.txt e un 403 ovunque altrove è esattamente ciò che volete quando bloccate i crawler di addestramento sul server.
4. Verificate che un visitatore «GPTBot» arrivi davvero da OpenAI
Chiunque può inviare uno user agent GPTBot. OpenAI, Perplexity, DuckDuckGo, Mistral e Google pubblicano elenchi di IP: verificate quindi l’IP di origine. Questo script controlla un IP con i tre file di OpenAI:
# verify_ip.py - usage: python3 verify_ip.py 132.196.86.1
import sys, json, ipaddress, urllib.request

ip = ipaddress.ip_address(sys.argv[1])
for name in ["gptbot", "searchbot", "chatgpt-user"]:
    data = json.load(urllib.request.urlopen(f"https://openai.com/{name}.json", timeout=20))
    nets = [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]
    hit = [str(n) for n in nets if ip.version == n.version and ip in n]
    print(f"{name:13} {len(nets):3} ranges  {'MATCH ' + hit[0] if hit else 'no match'}")
Output del 20 novembre 2026 alle 08:12 AEDT:
$ python3 verify_ip.py 132.196.86.1
gptbot         18 ranges  MATCH 132.196.86.0/24
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
$ python3 verify_ip.py 1.1.1.1
gptbot         18 ranges  no match
searchbot      39 ranges  no match
chatgpt-user  237 ranges  no match
Al momento del nostro test, il file gptbot.json di OpenAI conteneva 18 intervalli IPv4, con data di creazione 22 settembre 2026. Scaricate i file ogni volta invece di scriverli nel codice.
5. Cercate il vostro sito nel registro
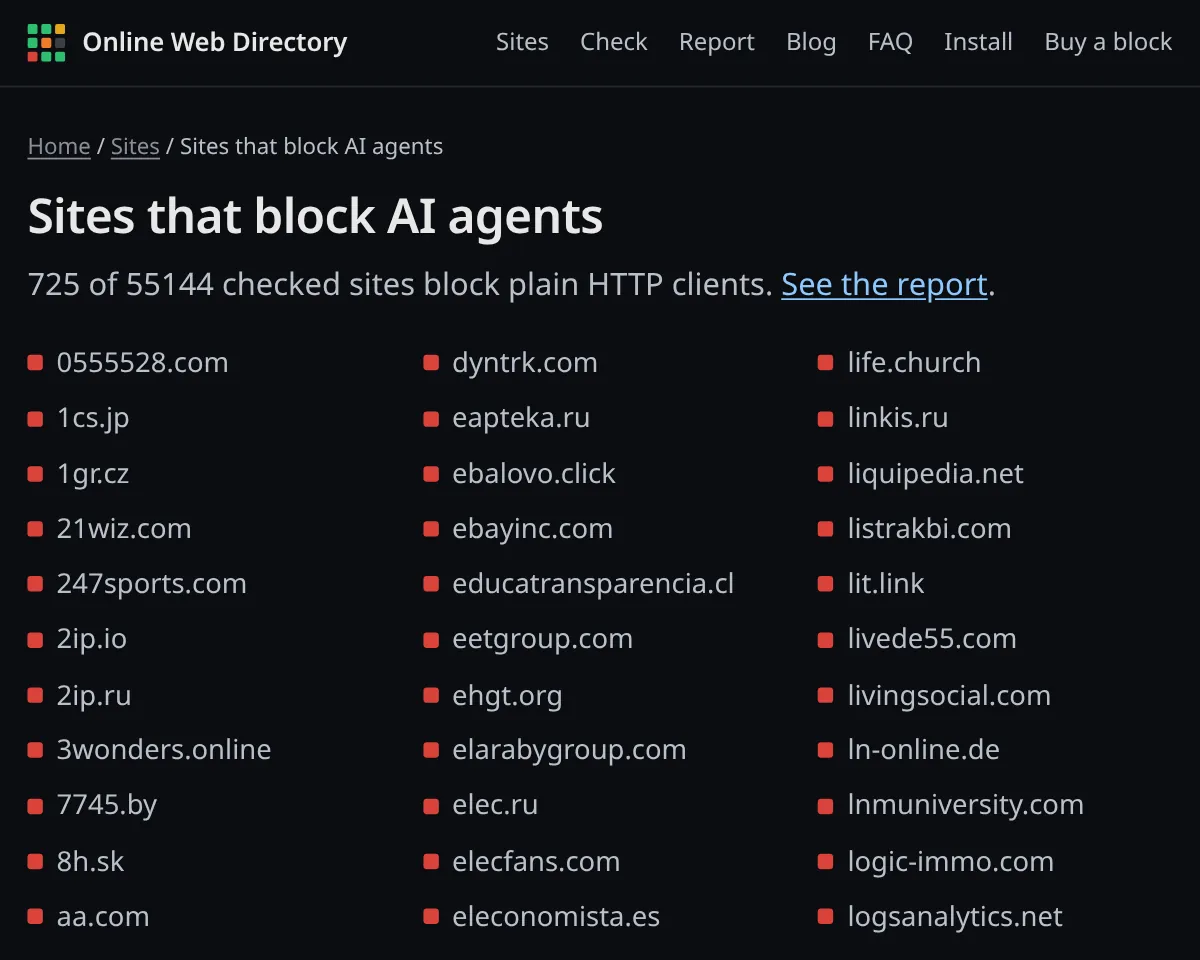
Online Web Directory verifica come i siti rispondono ai client HTTP semplici e cosa dice il loro robots.txt. Cercate il vostro dominio, per esempio reddit.com o nytimes.com, oppure eseguite il controllo di idoneità gratuito. L’elenco dei siti che bloccano gli agenti IA mostra quali domini rifiutano i client semplici.
Controllare i crawler IA: sei metodi
Scegliete in base al vostro obiettivo. La maggior parte dei siti vuole mantenere il traffico della ricerca IA, decidere caso per caso sull’addestramento e lasciare in pace gli agenti avviati dall’utente.
Metodo 1: bloccare i crawler di addestramento, mantenere la ricerca IA (robots.txt)
È la politica più comune tra i siti del nostro campione. Aggiungete questo al file /robots.txt nella radice di ogni host che servite:
# Block AI training crawlers
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: Bytespider
Disallow: /

# Allow AI search crawlers (so you can be cited in AI answers)
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
User-agent: MistralAI-Index
Allow: /

# Everyone else
User-agent: *
Disallow: /wp-admin/
Abbiamo testato questo file con Protego, un parser conforme alla RFC 9309. Risultati per il percorso /blog/:
GPTBot             /blog/  blocked
ClaudeBot          /blog/  blocked
CCBot              /blog/  blocked
Google-Extended    /blog/  blocked
Applebot-Extended  /blog/  blocked
OAI-SearchBot      /blog/  allowed
Claude-SearchBot   /blog/  allowed
PerplexityBot      /blog/  allowed
Googlebot          /blog/  allowed
Bingbot            /blog/  allowed
Impilare più righe User-agent sopra un unico blocco di regole è valido secondo la RFC 9309. Notate che il gruppo della ricerca IA non eredita la regola /wp-admin/ del gruppo *; aggiungetela anche lì se vi serve.
Metodo 2: bloccare tutti i crawler IA documentati (robots.txt)
Se non volete alcun uso da parte dell’IA, aggiungete al gruppo bloccato i token di ricerca e utente: OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User, meta-externalfetcher, Amzn-SearchBot, Amzn-User, MistralAI-Index, MistralAI-User e DuckAssistBot. Aspettatevi di sparire dalle risposte dell’IA. E ricordate che diversi fetcher avviati dall’utente dicono che robots.txt potrebbe non applicarsi a loro: è una preferenza dichiarata, non un muro.
Metodo 3: imporre il blocco in Nginx
Per rifiutare davvero le richieste, filtrate sul server. Questa configurazione restituisce 403 ai crawler di addestramento su ogni percorso tranne robots.txt, così possono ancora leggere le vostre regole. Il blocco map va nel contesto http:
# Block AI training crawlers by user agent, but still let them read robots.txt
map $http_user_agent $block_ai_crawler {
    default 0;
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training)" 1;
}
server {
    listen 80;
    root /var/www/html;
    location = /robots.txt { }
    location / {
        if ($block_ai_crawler) { return 403; }
    }
}
Testata con Nginx 1.26.3 il 20 novembre 2026: nginx -t è andato a buon fine, GPTBot ha ricevuto 403 su / e 200 su /robots.txt, mentre Chrome e OAI-SearchBot hanno ricevuto 200 su entrambi. Un semplice return dentro un if è tra gli usi che Nginx documenta come sicuri.
Metodo 4: imporre il blocco in Apache (.htaccess)
La stessa regola per Apache con mod_rewrite:
# Block AI training crawlers by user agent, but still let them read robots.txt
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent|Amazonbot|MistralAI-Training) [NC]
RewriteRule ^ - [F,L]
</IfModule>
Testato su Apache 2.4.71 con AllowOverride All: GPTBot ha ricevuto 403 sulla home page e 200 su robots.txt; Chrome e OAI-SearchBot hanno ricevuto 200. Il flag [F] restituisce 403 Forbidden.
Metodo 5: usare le regole per i crawler IA della vostra CDN
Su Cloudflare non serve mantenere un elenco. In Security, Settings, filtrate per «Bot traffic» e aprite AI Crawler and Agent access policies. Cloudflare consente di impostare azioni separate per il traffico Search, Agent e Training. La sua documentazione dice che i nuovi domini sono impostati di default su «Allow (do not block)» per tutti e tre, e che «Disallow» per Training modifica solo robots.txt finché non si attiva Bot Preference Sync. La dashboard AI Crawl Control di Cloudflare mostra anche quali crawler passano e se rispettano il vostro robots.txt. Dei 62.088 siti del nostro registro, 6.966 (11,2%) hanno presentato una verifica Cloudflare al nostro strumento di controllo.
Metodo 6: verificare, poi consentire
Le regole per user agent bloccano i bot onesti e lasciano passare quelli disonesti. Se bloccate all’edge, abbinate la regola a una verifica dell’IP (vedi il passo 4) e lasciate passare gli agenti di ricerca e utente verificati. Anthropic avverte che bloccare i suoi indirizzi IP potrebbe non funzionare in modo affidabile come opt-out, perché impedisce a ClaudeBot di leggere il vostro robots.txt. Usate robots.txt per la politica e le verifiche IP per scovare gli impostori.
Cosa dicono 2.124 file robots.txt sui crawler IA
Il 20 novembre 2026, tra le 08:01 e le 08:03 AEDT, abbiamo estratto a caso 3.000 host dai 62.088 siti del dataset aperto di Online Web Directory e scaricato /robots.txt dal nostro server. 2.124 hanno restituito un file analizzabile. Un token è «nominato» se ha una propria riga User-agent, e «bloccato del tutto» se quel gruppo contiene Disallow: / senza Allow: /.
| Token robots.txt | Nominato | Bloccato del tutto |
|---|---|---|
GPTBot |
23.6% | 16.9% |
ClaudeBot |
22.0% | 15.9% |
CCBot |
20.6% | 17.3% |
Google-Extended |
19.4% | 14.1% |
Bytespider |
18.5% | 16.6% |
Amazonbot |
17.4% | 14.3% |
meta-externalagent |
16.7% | 14.0% |
Applebot-Extended |
16.6% | 13.5% |
anthropic-ai (obsoleto) |
15.6% | 13.3% |
Claude-Web (obsoleto) |
13.8% | 12.2% |
PerplexityBot |
12.4% | 5.8% |
ChatGPT-User |
12.2% | 5.9% |
OAI-SearchBot |
9.3% | 2.8% |
Claude-User |
6.5% | 3.2% |
Perplexity-User |
6.4% | 3.2% |
Claude-SearchBot |
6.2% | 2.8% |
DuckAssistBot |
4.2% | 2.7% |
MistralAI-User |
3.7% | 2.6% |
Emergono quattro dati:
- La maggior parte dei siti non menziona affatto i crawler IA. 629 file su 2.124 (29,6%) nominano almeno un token specifico per l’IA. Chi lo fa spesso ne nomina molti: la mediana è di 12 token, e 357 file ne nominano 10 o più, segno di elenchi di blocco copiati.
- L’addestramento si blocca, la ricerca no. GPTBot è bloccato del tutto sei volte più spesso di OAI-SearchBot (16,9% contro 2,8%).
- robots.txt e accesso reale non coincidono. Dei 358 siti che bloccano del tutto GPTBot in robots.txt, 284 (79%) risultavano «aperti» nel controllo di accesso di OWD: niente sul server fermava un client semplice.
- I divieti totali sono rari. Solo 13 file (0,6%) vietano tutto a tutti gli user agent.
Il registro completo racconta la stessa storia dall’altro lato. Ecco i risultati di accesso dei 62.088 siti, verificati l’ultima volta tra l’11 ottobre e il 19 novembre 2026:
| Cosa ha incontrato un client HTTP semplice | Siti | Quota |
|---|---|---|
| Aperto | 50,844 | 81.9% |
| Verifica anti-bot | 7,821 | 12.6% |
| Bloccato | 3,060 | 4.9% |
| Limitato | 199 | 0.3% |
| Accesso richiesto | 150 | 0.2% |
| Paywall | 14 | 0.0% |
Scaricate il dataset completo (CC BY 4.0) da onlinewebdirectory.net/exports/sites.csv o consultate il rapporto sull’accesso degli agenti IA.
Errori e risposte correlati
- 403 Forbidden. Il vostro server, CDN o firewall ha rifiutato la richiesta. Non è mai causato da robots.txt in sé, e non è permanente: cambiate la regola e la richiesta successiva può andare a buon fine.
- 429 Too Many Requests. Limitazione della frequenza. Reddit l’ha restituito alla nostra richiesta ClaudeBot. Anthropic supporta
Crawl-delay, un’alternativa più morbida per ClaudeBot. - 202 a corpo vuoto, o pagina di verifica 503. Di solito una verifica JavaScript o CAPTCHA. I crawler non possono risolverla: per loro la pagina è bloccata anche senza 403.
- robots.txt restituisce un 4xx. Secondo la RFC 9309, una risposta tra 400 e 499 significa che il file è «non disponibile» e i crawler possono scansionare tutto. Nel nostro campione, 314 siti su 3.000 (10,5%) hanno risposto 403 alla nostra richiesta di robots.txt, che un crawler conforme leggerebbe come assenza di regole.
- robots.txt restituisce un 5xx o non risponde. La RFC 9309 impone ai crawler di presumere un divieto totale: un guasto di robots.txt può quindi bloccare in silenzio ogni crawler, Googlebot compreso.
- robots.txt oltre 500 KiB. La RFC 9309 obbliga i crawler ad analizzare solo i primi 500 KiB: le regole oltre questo limite possono essere ignorate.
Se pubblicate un file llms.txt per gli agenti IA, assicuratevi che i bot consentiti possano davvero scaricarlo. La nostra guida a llms.txt spiega come testarlo.
Riepilogo
Un elenco affidabile di crawler IA parte dalla documentazione degli operatori, non da altri elenchi. Oggi si tratta di circa 20 user agent di 9 aziende, in tre tipi: crawler di addestramento, crawler di ricerca IA e agenti avviati dall’utente, più due token di controllo (Google-Extended e Applebot-Extended) che non scansionano mai. La maggior parte dei siti che interviene blocca l’addestramento e mantiene la ricerca, e robots.txt è solo una richiesta: se vi serve un blocco vero, imponetelo sul server o sulla CDN e verificate gli IP.
Gli agenti IA consultano già i siti in Online Web Directory prima di visitarli. Se la scheda del vostro sito è sbagliata, o volete che gli agenti conoscano la vostra API, il vostro server MCP o i vostri permessi IA, rivendicate il vostro sito per 25 $. Prima potete eseguire il controllo di idoneità gratuito.
Domande frequenti
Qual è lo user agent di ChatGPT?
ChatGPT ne usa tre. GPTBot raccoglie dati di addestramento, OAI-SearchBot indicizza pagine per la ricerca di ChatGPT e ChatGPT-User recupera una pagina quando un utente la chiede. I loro token robots.txt sono GPTBot, OAI-SearchBot e ChatGPT-User.
Bloccare GPTBot toglie il mio sito dalla ricerca di ChatGPT?
No. OpenAI gestisce la ricerca tramite OAI-SearchBot. Potete bloccare GPTBot per rifiutare l’addestramento e consentire OAI-SearchBot perché le vostre pagine compaiano e siano citate nella ricerca di ChatGPT.
Google-Extended è un crawler?
No. Google dice che Google-Extended non ha uno user agent separato. A scansionare è Googlebot, e il token Google-Extended controlla solo se quei contenuti possono addestrare e fondare Gemini. Non ha alcun effetto sul posizionamento nella ricerca Google.
I crawler IA rispettano robots.txt?
I crawler di addestramento e di ricerca documentati in questo elenco dicono di sì. I fetcher avviati dall’utente, come ChatGPT-User, Perplexity-User e Meta-ExternalFetcher, dicono che robots.txt potrebbe non applicarsi, perché la pagina l’ha chiesta una persona. Gli scraper non documentati possono ignorarlo del tutto.
Come capisco se un bot è davvero GPTBot o ClaudeBot?
Verificate l’IP di origine. OpenAI pubblica i suoi intervalli in gptbot.json, searchbot.json e chatgpt-user.json; Perplexity, DuckDuckGo, Mistral e Google pubblicano i loro. Uno user agent corrispondente da un IP non elencato è un impostore.
Fonti
- OpenAI, Overview of OpenAI crawlers (consultato il 20 nov. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Google, Google’s common crawlers e user-triggered fetchers
- Perplexity, Perplexity crawlers
- Apple, About Applebot
- Meta, Meta web crawlers
- Amazon, Amazonbot and Amazon crawlers
- Common Crawl, CCBot
- Mistral AI, Mistral AI robots
- DuckDuckGo, About DuckAssistBot
- IETF, RFC 9309: Robots Exclusion Protocol
- Cloudflare, AI Crawler and Agent access policies e AI Crawl Control
- Online Web Directory, dataset aperto dei siti (62.088 siti, esportato il 20 nov. 2026) e il nostro campione robots.txt di 3.000 host